cbirdcn.github.io
http://www.zhzq.site
服务端重点-跨语言编程-Go
跨语言编程
golang语言与高并发
Golang的概念与理解
竞态(race)问题?Golang有哪些方式安全读写共享变量? link link link link
多个goroutine之间大部分情况是代码交叉执行,在执行过程中,可能会修改或读取共享内存变量,这样就会产生数据竞争,发生一些意外之外的结果。 举例:
package main

import (
	"fmt"
	"time"
)

var balance int

//存款
func Deposit(amount int) {
	balance = balance + amount
}

//读取余额
func Balance() int {
	return balance
}

func main() {
	//小王:存600,并读取余额
	go func() {
		Deposit(600)
		fmt.Println(Balance())
	}()
	//小张:存500
	go func() {
		Deposit(500)
		fmt.Println(Balance())
	}()

	time.Sleep(time.Second) // 为了简单,不使用waitGroup
	fmt.Println(balance) // 如果使用go run -race race.go会提示,此行也有竟态问题。因为主协程没有加waitGroup等待,所以也可能和子协程并发,所以主协程读余额也要处理
}
银行存款问题,结果可能不会是1100。如果让两个协程都执行100次。结果大概率不是110000.
解决竟态问题的两个思路:
- 不要多个 goroutine 中去访问同一个变量 goroutine + channel 就是这样的一个思路,通过 channel 阻塞来更新变量,这也符合 Go 代码的设计理念:不要通过共享内存来通信,而应该通过通信来共享内存。
- 同一时间只允许一个 goroutine 访问变量 如果在同一时间只能有一个 goroutine 访问变量,其他的 goruotine 需要等到当前的访问结束之后,才能访问,这样也可以消除竞态。
简言之,Golang中Goroutine 可以通过 Channel 进行安全读写共享变量,或者通过原子性操作同一时间只允许一个协程操作共享变量
先说一下通过Channel通道读写共享变量的方式。
- 通道Channel
- 原理:无缓冲信道是阻塞且原子的。
- 应用:只要有一个bool型channel就够了。方法内都是先写入channel,最后读取channel。当对方法A传入的channel被写入时,对方法B相同channel的写入肯定是失败的,只有等A释放了channel时,B才能抢到channel。
- 优点:比下面的sync.Mutex多了通信的功能
- 缺点:和sync.Mutex功能一样,性能不太好。无法区分写锁、读锁,读写操作会被同一把锁锁住。
package main

import (
	"fmt"
	"time"
)

var balance int

//存款
func Deposit(ch chan bool, amount int) {
	ch <- true // 抢channel,没抢到的被阻塞
	balance = balance + amount
	<-ch // 释放channel,其他被阻塞的可以继续抢
}

//读取余额
func Balance(ch chan bool) int {
	ch <- true
	ret := balance
	<-ch
	return ret
}

func main() {
	ch := make(chan bool, 1)
	//小王:存600,并读取余额
	go func() {
		Deposit(ch, 600)
		fmt.Println(Balance(ch))
	}()
	//小张:存500
	go func() {
		Deposit(ch, 500)
		fmt.Println(Balance(ch))
	}()

	// 为了简单,不使用 sync.WaitGroup , 所以需要defer和Sleep
	defer close(ch) // 记得关闭channel。单一程序是可以自动被GC清理掉channel的。但是如果goroutine很多,机器性能差,长时间积累或短时间爆发会压垮机器的CPU和内存,手动关闭channel是个好习惯。

	time.Sleep(time.Second)
	fmt.Println(Balance(ch))
}
还有一种使用多个channel处理共享变量的思考方式: link
对共享变量的每一种操作都要定义一个channel,然后死循环select监听信道变化,发生对应的信道变化时,就对共享变量执行对应的操作。
package bank

var deposits = make(chan int) // send amout to deposit
var balances = make(chan int) // receive balance

func Deposit(amount int) {
    deposits <- amount
}

func Balance() int {
    return <-balances
}

func teller() {
    var balance int // balance 只在 teller 中可以访问
    for {
        select {
        case amount := <-deposits:
            balance += amount
        case balances <- balance:
        }
    }
}

func init() {
    go teller()
}
这样的程序,稳定性较差:循环阻塞Channel可能会导致死锁。channel中传递的都是数据的拷贝,可能会影响性能。channel中如果传递指针又会导致数据竞态问题。另外代码量也会比较大。唯一比单一channel好的就是能解决读写共用一把锁的问题。
然后说几个保证同一时间只能有一个 goroutine 来访问变量的方案。
- 互斥锁sync.Mutex
- 原理:如果要访问一个资源,那么就必须要拿到这个资源的锁,只有拿到锁才有资格访问资源,其他的 goroutine 想要访问,必须等到当前 goroutine 释放了锁,抢到锁之后再访问
- 应用:每个拿到锁的 goroutine 都需要保证在对变量的访问结束之后,把锁释放掉,即使发生在异常情况,也需要释放。可以使用 defer 来保证最终会释放锁
- 缺点:性能较低。无论对共享变量的读写,都会被锁住。
package main

import (
    "fmt"
    "time"
    "sync"
)


var balance int
var mu sync.Mutex

//存款
func Deposit(amount int) {
    mu.Lock()
    defer mu.Unlock()
    balance = balance + amount
}
//读取余额
func Balance() int {
    mu.Lock()
    defer mu.Unlock()
    return balance
}

func main(){
    //小王:存600,并读取余额
    go func(){
        Deposit(600)
        fmt.Println(Balance())
    }()
    //小张:存500
    go func(){
        Deposit(500)
		fmt.Println(Balance())
    }()

    time.Sleep(time.Second)
    fmt.Println(Balance()) // 外部也要加锁,因为主协程没有加waitGroup,所以可能和子协程并发
}
- 读写互斥锁sync.RWMutex
- 对sync.Mutex的优化:如果这个变量没有在写入,就可以运行多个 goroutine 同时读,这样可以大大提高效率。
- 特点:如果有 goroutine 在写入,其他的 goroutine 既不能读,也不能写,但允许多个 goroutine 同时来读。修改时,需要等到所有读取的锁释放,才能修改
- 区别:读锁的获取锁和解锁是RLock与RUnlock。写锁就是原来的Lock和Unlock。
package main

import (
	"fmt"
	"sync"
	"time"
)

var balance int
var mu sync.RWMutex // 读锁

//存款
func Deposit(amount int) {
	mu.Lock()
	defer mu.Unlock()
	balance = balance + amount
}

//读取余额
func Balance() int {
	mu.RLock() // 读取余额要获取读锁
	defer mu.RUnlock()
	return balance
}

func main() {
	//小王:存600,并读取余额
	go func() {
		Deposit(600)
		fmt.Println(Balance())
	}()
	//小张:存500
	go func() {
		Deposit(500)
		fmt.Println(Balance())
	}()

	time.Sleep(time.Second)
	fmt.Println(Balance())
}
- sync.Once
- 特点:使方法只执行一次的对象实现,作用与 init 函数类似,但是可以在代码任何位置使用,而不是像init一样程序一开始就必须执行。
- 原理:sync.Once 使用变量 done 来记录函数的执行状态,使用 sync.Mutex 和 sync.atomic 来保证线程安全的读取 done 。
package main

import (
	"fmt"
	"sync"
	"time"
)

var balance int

//存款
func Deposit(amount int) {
	balance = balance + amount
}

//读取余额
func Balance() int {
	return balance
}

func main() {
	o := &sync.Once{}
	// o.Do(f func())
	o.Do(func() {
		//小王:存600,并读取余额
		go func() {
			Deposit(600)
			fmt.Println(Balance())
		}()
		//小张:存500
		go func() {
			Deposit(500)
			fmt.Println(Balance())
		}()
	})

	time.Sleep(time.Second)
	fmt.Println(balance) // once无法解决此行race问题
}
- 原子操作atomic link
- 特点:优势是更轻量,比如CAS可以在不形成临界区和创建互斥量的情况下完成并发安全的值替换操作。这可以大大的减少同步对程序性能的损耗。
- 劣势:还是以CAS操作为例,使用CAS操作的做法趋于乐观,总是假设被操作值未曾被改变(即与旧值相等),并一旦确认这个假设的真实性就立即进行值替换,那么在被操作值被频繁变更的情况下,CAS操作并不那么容易成功。而使用互斥锁的做法则趋于悲观,我们总假设会有并发的操作要修改被操作的值,并使用锁将相关操作放入临界区中加以保护。
-
原理比较:
- 互斥锁是一种数据结构,用来让一个线程执行程序的关键部分,完成互斥的多个操作
- 原子操作是无锁的,常常直接通过CPU指令直接实现
- 可以把互斥锁理解为悲观锁,共享资源每次只给一个线程使用,其它线程阻塞,用完后再把资源转让给其它线程
- 原子操作中的cas趋于乐观锁,CAS操作并不那么容易成功,需要判断,然后尝试处理
- 应用:atomic包提供了底层的原子性内存原语,这对于同步算法的实现很有用。这些函数一定要非常小心地使用,使用不当反而会增加系统资源的开销,对于应用层来说,最好使用通道或sync包中提供的功能来完成同步操作。
- 建议:atomic包的观点在Google的邮件组里也有很多讨论,其中一个结论解释是:应避免使用该包装。或者,阅读C ++ 11标准的“原子操作”一章;如果您了解如何在C ++中安全地使用这些操作,那么你才能有安全地使用Go的sync/atomic包的能力。
-
相关函数:
- CAS,比如func CompareAndSwapInt32(addr *int32, old, new int32) (swapped bool)
- Swap,比如func SwapInt32(addr *int32, new int32) (old int32)
- Add,比如func AddInt32(addr *int32, delta int32) (new int32)
- Load(读),比如func LoadInt32(addr *int32) (val int32)
- Store(写),比如func StoreInt32(addr *int32, val int32)
- 总结:
atomic操作是直接进行原语级操作,如果操作得当,效果是最好的,但是风险也是最高的。更建议用atomic实现的其他sync包中的功能。
sync.RWMutex比sync.Mutex和sync.Once功能更强,也更方便使用。
channel与前面四种方法在思想上是不同的,符合go语言的理念“不要通过共享内存来通信,而应该通过通信来共享内存”。
但是只有涉及到通信的时候才有必要用channel,不需要通信就直接加锁,不然代码写起来又多又乱容易出错。channel并没有太好用,因为可能涉及死锁。
Chan 的发送和接收是否同步(无缓冲、有缓冲)
ch := make(chan int)    无缓冲的channel由于没有缓冲发送和接收需要同步.
ch := make(chan int, 2) 有缓冲channel不要求发送和接收操作同步.
- channel无缓冲时,发送阻塞直到数据被接收,接收阻塞直到读到数据。
- channel有缓冲时,当缓冲满时发送阻塞,当缓冲空时接收阻塞。
go语言的并发机制以及它所使用的CSP并发模型
在计算机科学中,通信顺序过程(communicating sequential processes,CSP)是一种描述并发系统中交互模式的正式语言,它是并发数学理论家族中的一个成员,被称为过程算法(process algebras),或者说过程计算(process calculate),是基于消息的通道传递的数学理论。
CSP模型是上个世纪七十年代提出的,不同于传统的多线程通过共享内存来通信,CSP讲究的是“以通信的方式来共享内存”。用于描述两个独立的并发实体通过共享的通讯 channel(管道)进行通信的并发模型。 CSP中channel是第一类对象,它不关注发送消息的实体,而关注于发送消息时使用的channel。
Golang中channel 是被单独创建并且可以在进程之间传递,它的通信模式类似于 boss-worker 模式的,一个实体通过将消息发送到channel 中,然后又监听这个 channel 的实体处理,两个实体之间是匿名的,这个就实现实体中间的解耦,其中 channel 是同步的一个消息被发送到 channel 中,最终是一定要被另外的实体消费掉的,在实现原理上其实类似一个阻塞的消息队列。
注:在流水线设计模式之外,主从模式(Boss-worker)也是一种重要的多线程设计模式。在主从模式中,存在一个主人线程(Boss),它负责将工作分成同样的几份,并分配给从线程(Worker),Worker各自分头完成工作,最后Boss负责将多个Worker线程的工作成果合并
Goroutine 是Golang实际并发执行的实体,它底层是使用协程(coroutine)实现并发,coroutine是一种运行在用户态的用户线程,类似于greenthread,go底层选择使用coroutine的出发点是因为,它具有以下特点:
- 用户空间 避免了内核态和用户态的切换导致的成本.
- 可以由语言和框架层进行调度.
- 更小的栈空间允许创建大量的实例.
Golang中的Goroutine的特性:
- Golang内部有三个对象:P对象(processor)代表上下文(或者可以认为是cpu),M(work thread)代表工作线程,G对象(goroutine).
- 正常情况下一个cpu对象启动一个工作线程对象,线程去检查并执行goroutine对象。碰到goroutine对象阻塞的时候,会启动一个新的工作线程,以充分利用cpu资源。所以有时候线程对象会比处理器对象多很多.
- G(Goroutine): 协程,为用户级的轻量级线程,每个Goroutine对象中的sched保存着其上下文信息。
- M(Machine): 对Os内核级线程的封装,数量对应真实的CPU数(真正干活的对象)。
- P(Processor): 逻辑处理器,即为G和M的调度对象,用来调度G和M之间的关联关系,其数量可通过GOMAXPROCS()来设置,默认为核心数。
- 在单核情况下,所有Goroutine运行在同一个线程(M0)中,每一个线程维护一个上下文(P),任何时刻,一个上下文中只有一个Goroutine,其他Goroutine在runqueue中等待。
- 一个Goroutine运行完自己的时间片后,让出上下文,自己回到runqueue中(如下图所示)。
- 当正在运行的G0阻塞的时候(可以需要IO),会再创建一个线程(M1),P转到新的线程中去运行。

- 当M0返回时,它会尝试从其他线程中“偷”一个上下文过来,如果没有偷到,会把Goroutine放到 Global runqueue中去,然后把自己放入线程缓存中。 上下文会定时检查 Global runqueue。
Golang是为并发而生的语言,Go语言是为数不多的在语言层面实现并发的语言;也正是Go语言的并发特性,吸引了全球无数的开发者。
Golang的CSP并发模型,是通过Goroutine和Channel来实现的。
- Goroutine 是Go语言中并发的执行单位。有点抽象,其实就是和传统概念上的”线程“类似,可以理解为”线程“。
- Channel是Go语言中各个并发结构体(Goroutine)之前的通信机制。通常Channel,是各个Goroutine之间通信的”管道“,有点类似于Linux中的管道。
- 通信机制channel也很方便,传数据用 channel <- data,取数据用 <-channel。
- 在通信过程中,传数据 channel <- data和取数据 <-channel必然会成对出现,因为这边传,那边取,两个goroutine之间才会实现通信。
- 而且不管是传还是取,肯定阻塞,直到另外的goroutine传或者取为止。
因此GPM的简要概括即为:事件循环,线程池,工作队列。
Golang中常用的并发模型
Golang中常用的并发模型有三种:
-
通过channel通知实现并发控制
- 无缓冲的通道:指的是通道的大小为0,也就是说,这种类型的通道在接收前没有能力保存任何值,它要求发送 goroutine 和接收 goroutine 同时准备好,才可以完成发送和接收操作。
- 从上面无缓冲的通道定义来看,发送 goroutine 和接收 gouroutine 必须是同步的,同时准备后,如果没有同时准备好的话,先执行的操作就会阻塞等待,直到另一个相对应的操作准备好为止。这种无缓冲的通道我们也称之为同步通道。
func main() { ch := make(chan struct{}) go func() { fmt.Println("start working") time.Sleep(time.Second * 1) ch <- struct{}{} }() <-ch fmt.Println("finished") } - 当主 goroutine 运行到
<-ch接受 channel 的值的时候,如果该 channel 中没有数据,就会一直阻塞等待,直到有值。 这样就可以简单实现并发控制
-
通过sync包中的WaitGroup实现并发控制
- Goroutine是异步执行的,有的时候为了防止在结束main函数的时候结束掉Goroutine,所以需要同步等待,这个时候就需要用 WaitGroup了,在 sync 包中,提供了 WaitGroup,它会等待它收集的所有 goroutine 任务全部完成。
- 在WaitGroup里主要有三个方法:
- Add, 可以添加或减少 goroutine的数量.
- Done, 相当于Add(-1).
- Wait, 执行后会堵塞主线程,直到WaitGroup 里的值减至0.
- 在主 goroutine 中 Add(delta int) 所有等待goroutine 的数量。在每一个 goroutine 完成后 Done() 表示这一个goroutine 已经完成,当所有的 goroutine 都完成后,在主 goroutine 中 WaitGroup 返回。
func main(){ var wg sync.WaitGroup var urls = []string{ "http://www.golang.org/", "http://www.google.com/", } for _, url := range urls { wg.Add(1) go func(url string) { defer wg.Done() http.Get(url) }(url) } wg.Wait() } - 在Golang官网中对于WaitGroup介绍是
A WaitGroup must not be copied after first use,在 WaitGroup 第一次使用后,不能被拷贝。否则会提示所有的 goroutine 都已经睡眠了,出现了死锁。这是因为 wg 给拷贝传递到了 goroutine 中,导致原wg对象只进行了Add 操作,而Done操作是在 wg 的副本执行的。 - 第一个修改方式:将匿名函数的参数类型改为 *sync.WaitGroup。
- 第二个修改方式:将匿名函数中的 wg 的传入参数去掉,因为Go支持闭包类型,在匿名函数中可以直接使用外面的 wg 变量.
-
在Go 1.7 以后引进的强大的Context上下文,实现并发控制. link
- 通常,在一些简单场景下使用 channel 和 WaitGroup 已经足够了,但是当面临一些复杂多变的网络并发场景下 channel 和 WaitGroup 显得有些力不从心了。
- 比如一个网络请求 Request,每个 Request 都需要开启一个 goroutine 做一些事情,这些 goroutine 又可能会开启其他的 goroutine,比如数据库和RPC服务。
- 所以我们需要一种可以跟踪 goroutine 的方案,才可以达到控制他们的目的,这就是Go语言为我们提供的 Context,称之为上下文非常贴切,它就是goroutine 的上下文。
- 它是包括一个程序的运行环境、现场和快照等。每个程序要运行时,都需要知道当前程序的运行状态,通常Go 将这些封装在一个 Context 里,再将它传给要执行的 goroutine 。
- context 包主要是用来处理多个 goroutine 之间共享数据,及多个 goroutine 的管理。
- 具体来说,上下文 context.Context Go 语言中用来设置截止时间、同步信号,传递请求相关值的结构体。
- context.Context 是 Go 语言在 1.7 版本中引入标准库的接口1,该接口定义了四个需要实现的方法。接口声明如下:
// A Context carries a deadline, cancelation signal, and request-scoped values // across API boundaries. Its methods are safe for simultaneous use by multiple // goroutines. type Context interface { // Done returns a channel that is closed when this `Context` is canceled // or times out. // Done() 返回一个只能接受数据的channel类型,当该context关闭或者超时时间到了的时候,该channel就会有一个取消信号 Done() <-chan struct{} // Err indicates why this Context was canceled, after the Done channel // is closed. // Err() 在Done() 之后,返回context 取消的原因。 Err() error // Deadline returns the time when this Context will be canceled, if any. // Deadline() 设置该context cancel的时间点 Deadline() (deadline time.Time, ok bool) // Value returns the value associated with key or nil if none. // Value() 方法允许 Context 对象携带request作用域的数据,该数据必须是线程安全的。 Value(key interface{}) interface{} } - context 包中提供的 context.Background、context.TODO、context.WithDeadline 和 context.WithValue 函数会返回实现该接口的私有结构体
- Context 对象是线程安全的,你可以把一个 Context 对象传递给任意个数的 gorotuine,对context执行取消操作时,所有 goroutine 都会接收到取消信号。
- 一个 Context 不能拥有 Cancel 方法,同时我们也只能 Done channel 接收数据。其中的原因是一致的:接收取消信号的函数和发送信号的函数通常不是一个。
- 典型的场景是:父操作为子操作操作启动 goroutine,子操作也就不能取消父操作。
- Context 与 Goroutine 树:每一个 context.Context 都会从最顶层的 Goroutine 一层一层传递到最下层。context.Context 可以在上层 Goroutine 执行出现错误时,将信号及时同步给下层。就可以在下层及时停掉无用的工作以减少额外资源的消耗。
// 创建了一个过期时间为 1s 的上下文,并向上下文传入 handle 函数,该方法会使用 500ms 的时间处理传入的请求 func main() { ctx, cancel := context.WithTimeout(context.Background(), 1*time.Second) defer cancel() go handle(ctx, 500*time.Millisecond) select { case <-ctx.Done(): fmt.Println("main", ctx.Err()) } } func handle(ctx context.Context, duration time.Duration) { select { case <-ctx.Done(): fmt.Println("handle", ctx.Err()) case <-time.After(duration): fmt.Println("process request with", duration) } } // 因为过期时间大于处理时间,所以我们有足够的时间处理该请求,运行上述代码会打印出下面的内容 //$ go run context.go //process request with 500ms //main context deadline exceeded // 因为handle 函数没有进入超时的 select 分支,main 函数的 select 会等待 context.Context 超时并打印出 main context deadline exceeded。 // 如果我们将处理请求时间增加至 1500ms,整个程序都会因为上下文的过期而被中止 //$ go run context.go //main context deadline exceeded //handle context deadline exceeded- Context的使用方法和设计原理:多个 Goroutine 同时订阅 ctx.Done() 管道中的消息,一旦接收到取消信号就立刻停止当前正在执行的工作。
综上。Channel无缓冲同步阻塞通道;sync.WaitGroup让主协程等待所有子协程完成;Context上下文包括程序的运行环境、现场和快照,使数据从主协程更快传递给子协程。
Go中对nil的Slice和空Slice的处理是一致的吗? link
首先Go的JSON 标准库对 nil slice 和 空 slice 的处理是不一致.
通常错误的用法,会报数组越界的错误,因为只是声明了slice,却没有给实例化的对象。
var slice []int
slice[1] = 0
此时slice的值是nil,这种情况可以用于需要返回slice的函数,当函数出现异常的时候,保证函数依然会有nil的返回值。
empty slice 是指slice不为nil,但是slice没有值,slice的底层的空间是空的,此时的定义如下:
slice := make([]int,0)
slice := []int{}
当我们查询或者处理一个空的列表的时候,这非常有用,它会告诉我们返回的是一个列表,但是列表内没有任何值。
总之,nil slice 和 empty slice是不同的东西,需要我们加以区分的。实际上,代码中使用slice时,尽可能用make创建,可以避免出现数组越界panic。
协程和线程和进程的区别
进程
- 进程是具有一定独立功能的程序关于某个数据集合上的一次运行活动,进程是系统进行资源分配和调度的一个独立单位。
- 每个进程都有自己的独立内存空间,不同进程通过进程间通信来通信。
- 由于进程比较重量,占据独立的内存,所以上下文进程间的切换开销(栈、寄存器、虚拟内存、文件句柄等)比较大,但相对比较稳定安全。
线程
- 线程是进程的一个实体,线程是内核态,而且是CPU调度和分派的基本单位,它是比进程更小的能独立运行的基本单位.
- 线程自己基本上不拥有系统资源,只拥有一点在运行中必不可少的资源(如程序计数器,一组寄存器和栈),但是它可与同属一个进程的其他的线程共享进程所拥有的全部资源。
- 线程间通信主要通过共享内存,上下文切换很快,资源开销较少,但相比进程不够稳定容易丢失数据。
协程
- 协程是一种用户态的轻量级线程,协程的调度完全由用户控制。
- 协程拥有自己的寄存器上下文和栈。
- 协程调度切换时,将寄存器上下文和栈保存到其他地方,在切回来的时候,恢复先前保存的寄存器上下文和栈,直接操作栈则基本没有内核切换的开销,可以不加锁的访问全局变量,所以上下文的切换非常快。
Golang的内存模型,为什么小对象多了会造成gc压力? link
通常小对象过多会导致GC三色法消耗过多的CPU。
优化思路是,减少对象分配.
还有一种思路:
一直分配对象不回收,最后整个分配器一起丢掉。中间只有分配器占用了一个byte数组对象需要GC扫描,但是因为Go认为数组里面没有指针,所以就只标记数组头为可达,扫描就完成了。目标达成!
Data Race问题是什么?怎么解决?能不能不加锁解决这个问题?
Data Race问题可以使用互斥锁 sync.Mutex, 或者也可以通过CAS无锁并发解决.
其中使用同步访问共享数据或者CAS无锁并发是处理数据竞争的一种有效的方法.
golang在1.1之后引入了竞争检测机制,可以使用 go run -race 或者 go build -race来进行静态检测。
其在内部的实现是,开启多个协程执行同一个命令, 并且记录下每个变量的状态.
竞争检测器已经完全集成到Go工具链中,仅仅添加-race标志到命令行就使用了检测器。
$ go test -race mypkg    // 测试包
$ go run -race mysrc.go  // 编译和运行程序
$ go build -race mycmd   // 构建程序
$ go install -race mypkg // 安装程序
要想解决数据竞争的问题可以使用互斥锁 sync.Mutex,解决数据竞争(Data race),也可以使用管道解决,使用管道的效率要比互斥锁高.
解决 race 的问题时,无非就是上锁。可能很多人都听说过一个高逼格的词叫「无锁队列」。 都一听到加锁就觉得很 low,那无锁又是怎么一回事?其实就是利用 atomic 特性,那 atomic 会比 mutex 有什么好处呢?
mutex 由操作系统实现,而 atomic 包中的原子操作则由底层硬件直接提供支持。在 CPU 实现的指令集里,有一些指令被封装进了 atomic 包,这些指令在执行的过程中是不允许中断(interrupt)的,因此原子操作可以在 lock-free 的情况下保证并发安全,并且它的性能也能做到随 CPU 个数的增多而线性扩展。
若实现相同的功能,后者通常会更有效率,并且更能利用计算机多核的优势。所以,以后当我们想并发安全的更新一些变量的时候,我们应该优先选择用 atomic 来实现。
什么是channel,为什么它可以做到线程安全?
Channel是Go中的一个核心类型,可以把它看成一个管道,通过它并发核心单元就可以发送或者接收数据进行通讯(communication),Channel也可以理解是一个先进先出的队列,通过管道进行通信。
Golang的Channel,发送一个数据到Channel和从Channel接收一个数据都是原子性的。
Go的设计思想就是, 不要通过共享内存来通信,而是通过通信来共享内存,前者就是传统的加锁,后者就是Channel。
也就是说,设计Channel的主要目的就是在多任务间传递数据的,本身就是安全的。
什么是垃圾回收?垃圾回收的方法(引用计数、标记-清除、分代搜集)?Golang GC 时会发生什么?
什么是垃圾回收?
内存管理是程序员开发应用的一大难题。传统的系统级编程语言(主要指C/C++)中,程序开发者必须对内存小心的进行管理操作,控制内存的申请及释放。 因为稍有不慎,就可能产生内存泄露问题,这种问题不易发现并且难以定位。
如何解决?
过去一般采用两种办法:
- 内存泄露检测工具。这种工具的原理一般是静态代码扫描,通过扫描程序检测可能出现内存泄露的代码段。然而检测工具难免有疏漏和不足,只能起到辅助作用。
- 智能指针。这是 c++ 中引入的自动内存管理方法,通过拥有自动内存管理功能的指针对象来引用对象,是程序员不用太关注内存的释放,而达到内存自动释放的目的。这种方法是采用最广泛的做法,但是对程序开发者有一定的学习成本(并非语言层面的原生支持),而且一旦有忘记使用的场景依然无法避免内存泄露。
为了解决这个问题,后来开发出来的几乎所有新语言(java,python,php等等)都引入了语言层面的自动内存管理 – 也就是语言的使用者只用关注内存的申请而不必关心内存的释放,内存释放由虚拟机(virtual machine)或运行时(runtime)来自动进行管理。而这种对不再使用的内存资源进行自动回收的行为就被称为垃圾回收。
常用的垃圾回收的方法:
- 引用计数(reference counting)
- 最简单的一种垃圾回收算法,和之前提到的智能指针异曲同工。对每个对象维护一个引用计数,当引用该对象的对象被销毁或更新时被引用对象的引用计数自动减一,当被引用对象被创建或被赋值给其他对象时引用计数自动加一。当引用计数为0时则立即回收对象。
- 优点是实现简单,并且内存的回收很及时。这种算法在内存比较紧张和实时性比较高的系统中使用的比较广泛,如ios cocoa框架,php,python等。
- 缺点:
- 频繁更新引用计数降低了性能。
- 循环引用。当对象间发生循环引用时引用链中的对象都无法得到释放。最明显的解决办法是避免产生循环引用。或者系统检测循环引用并主动打破循环链。当然这也增加了垃圾回收的复杂度。
- 标记-清除(mark and sweep)
- 标记-清除(mark and sweep)分为两步:
- 标记从根变量开始迭代得遍历所有被引用的对象,对能够通过应用遍历访问到的对象都进行标记为“被引用”;
- 标记完成后进行清除操作,对没有标记过的内存进行回收(回收同时可能伴有碎片整理操作)。
- 这种方法解决了引用计数的不足,但是也有比较明显的问题:每次启动垃圾回收都会暂停当前所有的正常代码执行,回收时,系统响应能力大大降低 !当然后续也出现了很多mark&sweep算法的变种(如三色标记法)优化了这个问题。
- 标记-清除(mark and sweep)分为两步:
- 分代搜集(generation)
- java的jvm 就使用的分代回收的思路。在面向对象编程语言中,绝大多数对象的生命周期都非常短。分代收集的基本思想是,将堆划分为两个或多个称为代(generation)的空间。
- 新创建的对象存放在称为新生代(young generation)中(一般来说,新生代的大小会比 老年代小很多),随着垃圾回收的重复执行,生命周期较长的对象会被提升(promotion)到老年代中(这里用到了一个分类的思路,这个是也是科学思考的一个基本思路)。
- 因此,新生代垃圾回收和老年代垃圾回收两种不同的垃圾回收方式应运而生,分别用于对各自空间中的对象执行垃圾回收。新生代垃圾回收的速度非常快,比老年代快几个数量级,即使新生代垃圾回收的频率更高,执行效率也仍然比老年代垃圾回收强,这是因为大多数对象的生命周期都很短,根本无需提升到老年代。
Golang GC 时会发生什么? 完整介绍 link link link 原理

golang 一轮完整的 GC 的过程:
- 一轮完整的 GC,总是从 Off,如果不是 Off 状态,则代表上一轮GC还未完成,如果这时修改指针的值,是直接修改的。
- Stack scan: 收集根对象(全局变量和 goroutine 栈上的变量),该阶段会开启写屏障(Write Barrier)。
- Mark: 标记对象,直到标记完所有根对象和根对象可达对象。此时写屏障会记录所有指针的更改(通过 mutator)。
- Mark Termination: 重新扫描部分全局变量和发生更改的栈变量,完成标记,该阶段会STW(Stop The World),也是 gc 时造成 go 程序停顿的主要阶段。
- Sweep: 并发的清除未标记的对象。
Golang 1.5后,采取的是“非分代的、非移动的、并发的、三色的”标记清除垃圾回收算法。优化的核心就是尽量使得 STW(Stop The World) 的时间越来越短。
- golang 的垃圾回收是基于标记清扫算法,这种算法需要进行 STW(stop the world),这个过程就会导致程序是卡顿的,频繁的 GC 会严重影响程序性能.
- golang 在此基础上进行了改进,通过三色标记清扫法与写屏障来减少 STW 的时间.
- 以上 Mark 阶段,采用的是三色标记法,是传统标记-清除算法的一种优化,主要思想是增加了一种中间状态,即灰色对象,以减少 STW 时间。

|  |
- 三色标记将对象分为黑色、白色、灰色三种:
- 黑色:已标记的对象,表示对象是根对象可达的。
- 白色:未标记对象,gc开始时所有对象为白色,当gc结束时,如果仍为白色,说明对象不可达,在 sweep 阶段会被清除。
- 灰色:被黑色对象引用到的对象,但其引用的自对象还未被扫描,灰色为标记过程的中间状态,当灰色对象全部被标记完成代表本次标记阶段结束。
- gc的过程一共分为四个阶段:
- 栈扫描(开始时STW):所有对象最开始都是白色。然后取消STW,将扫描任务作为多个并发的goroutine立即入队给调度器,进而被CPU处理。
- 第一次标记(并发):从root开始找到所有可达对象(所有可以找到的对象,包括全局指针和 goroutine 栈上的指针),标记为灰色,放入待处理队列。
- 第二次标记(STW):遍历灰色对象队列,将其引用对象标记为灰色放入待处理队列,自身标记为黑色。
- 清除(并发):循环步骤3直到灰色队列为空为止,此时所有引用对象都被标记为黑色,所有不可达的对象依然为白色,白色的就是需要进行回收的对象。
- 三色标记法相对于普通标记清扫,减少了 STW 时间. 这主要得益于标记过程是 “on-the-fly” 的,在标记过程中是不需要 STW 的,它与程序是并发执行的,这就大大缩短了STW的时间.
- 写屏障:
- 当标记和程序是并发执行的,这就会造成一个问题. 在标记过程中,有新的引用产生,可能会导致误清扫.
- 清扫开始前,标记为黑色的对象引用了一个新申请的对象,它肯定是白色的,而黑色对象不会被再次扫描,那么这个白色对象无法被扫描变成灰色、黑色,它就会最终被清扫,而实际它不应该被清扫.
- 这就需要用到屏障技术,golang采用了写屏障,其作用就是为了避免这类误清扫问题. 写屏障即在内存写操作前,维护一个约束,从而确保清扫开始前,黑色的对象不能引用白色对象.
GC触发GC的触发条件?
Go中对 GC 的触发时机存在两种形式:
- 主动触发(手动触发),通过调用runtime.GC 来触发GC,此调用阻塞式地等待当前GC运行完毕.
- 被动触发,分为两种方式:
- a. 使用系统监控。默认每 2min 未产生 GC 时,golang 的守护协程 sysmon 会强制触发 GC
- b. 使用步调(Pacing)算法,当 go 程序分配的内存增长超过阈值时,会触发GC.
Golang 中 Goroutine 如何调度(GMP调度原理)? link
G、M、P、Sched
Go的调度器内部有四个重要的结构:M,P,G,Sched,如上图所示(Sched未给出).
M:M代表内核级线程,一个M就是一个线程,goroutine就是跑在M之上的;M是一个很大的结构,里面维护小对象内存cache(mcache)、当前执行的goroutine、随机数发生器等等非常多的信息 P:P全称是Processor,处理器,它的主要用途就是用来执行goroutine的,所以它也维护了一个goroutine队列,里面存储了所有需要它来执行的goroutine G:代表一个goroutine,它有自己的栈,instruction pointer和其他信息(正在等待的channel等等),用于调度。 Sched:代表调度器,它维护有存储M和G的队列以及调度器的一些状态信息等。
调度实现:

从上图中可以看到,有2个物理线程M,每一个M都拥有一个处理器P,每一个也都有一个正在运行的goroutine。P的数量可以通过GOMAXPROCS()来设置,它其实也就代表了真正的并发度,即有多少个goroutine可以同时运行。
图中灰色的那些goroutine并没有运行,而是出于ready的就绪态,正在等待被调度。P维护着这个队列(称之为runqueue),Go语言里,启动一个goroutine很容易:go function 就行,所以每有一个go语句被执行,runqueue队列就在其末尾加入一个goroutine,在下一个调度点,就从runqueue中取出一个goroutine执行。
当一个OS线程M0陷入阻塞时,P转而在运行M1,图中的M1可能是正被创建,或者从线程缓存中取出。

当M0返回时,它必须尝试取得一个P来运行goroutine,一般情况下,它会从其他的OS线程那里拿一个P过来, 如果没有拿到的话,它就把goroutine放在一个global runqueue里,然后自己睡眠(放入线程缓存里)。所有的P也会周期性的检查global runqueue并运行其中的goroutine,否则global runqueue上的goroutine永远无法执行。
另一种情况是P所分配的任务G很快就执行完了(分配不均),这就导致了这个处理器P很忙,但是其他的P还有任务,此时如果global runqueue没有任务G了,那么P不得不从其他的P里拿一些G来执行。
通常来说,如果P从其他的P那里要拿任务的话,一般就拿run queue的一半,这就确保了每个OS线程都能充分的使用。
并发编程概念是什么?
并行是指两个或者多个事件在同一时刻发生;并发是指两个或多个事件在同一时间间隔发生。
并行是在不同实体上的多个事件,并发是在同一实体上的多个事件。
并发偏重于多个任务交替执行,而多个任务之间有可能还是串行的。而并行是真正意义上的“同时执行”。
并发编程是指在一台处理器上“同时”处理多个任务。并发是在同一实体上的多个事件。多个事件在同一时间间隔发生。并发编程的目标是充分的利用处理器的每一个核,以达到最高的处理性能。
Go语言的栈空间管理是怎么样的?
Go语言的运行环境(runtime)会在goroutine需要的时候动态地分配栈空间,而不是给每个goroutine分配固定大小的内存空间。这样就避免了需要程序员来决定栈的大小。
分块式的栈是最初Go语言组织栈的方式。当创建一个goroutine的时候,它会分配一个8KB的内存空间来给goroutine的栈使用。我们可能会考虑当这8KB的栈空间被用完的时候该怎么办?
为了处理这种情况,每个Go函数的开头都有一小段检测代码。这段代码会检查我们是否已经用完了分配的栈空间。如果是的话,它会调用 morestack函数。morestack函数分配一块新的内存作为栈空间,并且在这块栈空间的底部填入各种信息(包括之前的那块栈地址)。在分配了这块新的栈空间之后,它会重试刚才造成栈空间不足的函数。这个过程叫做栈分裂(stack split)。
在新分配的栈底部,还插入了一个叫做 lessstack的函数指针。这个函数还没有被调用。这样设置是为了从刚才造成栈空间不足的那个函数返回时做准备的。当我们从那个函数返回时,它会跳转到 lessstack。lessstack函数会查看在栈底部存放的数据结构里的信息,然后调整栈指针(stack pointer)。这样就完成了从新的栈块到老的栈块的跳转。接下来,新分配的这个块栈空间就可以被释放掉了。
分块式的栈让我们能够按照需求来扩展和收缩栈的大小。 Go开发者不需要花精力去估计goroutine会用到多大的栈。创建一个新的goroutine的开销也不大。当 Go开发者不知道栈会扩展到多少大时,它也能很好的处理这种情况。
这一直是之前Go语言管理栈的的方法。但这个方法有一个问题。缩减栈空间是一个开销相对较大的操作。如果在一个循环里有栈分裂,那么它的开销就变得不可忽略了。一个函数会扩展,然后分裂栈。当它返回的时候又会释放之前分配的内存块。如果这些都发生在一个循环里的话,代价是相当大的。 这就是所谓的热分裂问题(hot split problem)。它是Go语言开发者选择新的栈管理方法的主要原因。新的方法叫做 栈复制法(stack copying)。
栈复制法一开始和分块式的栈很像。当goroutine运行并用完栈空间的时候,与之前的方法一样,栈溢出检查会被触发。但是,不像之前的方法那样分配一个新的内存块并链接到老的栈内存块,新的方法会分配一个两倍大的内存块并把老的内存块内容复制到新的内存块里。这样做意味着当栈缩减回之前大小时,我们不需要做任何事情。栈的缩减没有任何代价。而且,当栈再次扩展时,运行环境也不需要再做任何事。它可以重用之前分配的空间。
栈的复制听起来很容易,但实际操作并非那么简单。存储在栈上的变量的地址可能已经被使用到。也就是说程序使用到了一些指向栈的指针。当移动栈的时候,所有指向栈里内容的指针都会变得无效。然而,指向栈内容的指针自身也必定是保存在栈上的。这是为了保证内存安全的必要条件。否则一个程序就有可能访问一段已经无效的栈空间了。
因为垃圾回收的需要,我们必须知道栈的哪些部分是被用作指针了。当我们移动栈的时候,我们可以更新栈里的指针让它们指向新的地址。所有相关的指针都会被更新。我们使用了垃圾回收的信息来复制栈,但并不是任何使用栈的函数都有这些信息。因为很大一部分运行环境是用C语言写的,很多被调用的运行环境里的函数并没有指针的信息,所以也就不能够被复制了。当遇到这种情况时,我们只能退回到分块式的栈并支付相应的开销。
这也是为什么现在运行环境的开发者正在用Go语言重写运行环境的大部分代码。无法用Go语言重写的部分(比如调度器的核心代码和垃圾回收器)会在特殊的栈上运行。这个特殊栈的大小由运行环境的开发者设置。
这些改变除了使栈复制成为可能,它也允许我们在将来实现并行垃圾回收。
另外一种不同的栈处理方式就是在虚拟内存中分配大内存段。由于物理内存只是在真正使用时才会被分配,因此看起来好似你可以分配一个大内存段并让操 作系统处理它。下面是这种方法的一些问题
首先,32位系统只能支持4G字节虚拟内存,并且应用只能用到其中的3G空间。由于同时运行百万goroutines的情况并不少见,因此你很可 能用光虚拟内存,即便我们假设每个goroutine的stack只有8K。
第二,然而我们可以在64位系统中分配大内存,它依赖于过量内存使用。所谓过量使用是指当你分配的内存大小超出物理内存大小时,依赖操作系统保证 在需要时能够分配出物理内存。然而,允许过量使用可能会导致一些风险。由于一些进程分配了超出机器物理内存大小的内存,如果这些进程使用更多内存 时,操作系统将不得不为它们补充分配内存。这会导致操作系统将一些内存段放入磁盘缓存,这常常会增加不可预测的处理延迟。正是考虑到这个原因,一 些新系统关闭了对过量使用的支持。
Goroutine和Channel的作用分别是什么? link link
进程是内存资源管理和cpu调度的执行单元。为了有效利用多核处理器的优势,将进程进一步细分,允许一个进程里存在多个线程,这多个线程还是共享同一片内存空间,但cpu调度的最小单元变成了线程。
那协程又是什么呢,以及与线程的差异性?
- 协程就是由用户控制的,能支持保存任意函数的调用现场,保存起来并重新执行的实现。
- goroutine是Go语言提供的一种协程。它和其他语言不同的是:
- goroutine可以实现并行,多个协程可以在多个处理器同时跑。而其他协程同一时刻只能在一个处理器上跑。
- 多个goroutine之间的通信是通过channel,而其他协程的通信是通过yield和resume()操作。
- 从PMG的角度看,goroutine可以在一个或多个CPU中同时被执行。设置 runtime.GOMAXPROCS(1)时,那么程序将会根据操作系统的 CPU 核数而启动对应数量的 P,导致多个 M,即线程的启动。那么我们程序中的协程,就会被分配到不同的线程里面去了。当设置数量 1时,协程都被分配到了同一个线程里面,存于线程的协程队列里面,等待被执行或调度。
- 因为协程的调度切换不是线程切换,而是由程序自身控制,因此,没有线程切换的开销,和多线程比,线程数量越多,协程的性能优势就越明显。调度发生在应用态而非内核态。协程内存的花销,使用其所在的线程的内存,意味着线程的内存可以供多个协程使用。
- 当只有这一个线程时,协程的调度不需要多线程的锁机制,因为只有一个线程,也不存在同时写变量冲突,所以执行效率比多线程高很多。当利用多核并行开启多个线程时,go协程还是需要加锁的。
channel在goroutines之间通信的过程:
- 可以把channel形象比喻为工厂里的传送带,一头的生产者goroutine往传输带放东西,另一头的消费者goroutinue则从输送带取东西。
- channel实际上是一个有类型的消息队列,遵循先进先出的特点。
- channel的收、发操作是原子的。
- 没有缓冲(buffer)的channel只能容纳一个元素。只有收、发双方都准备好,才能通信,否则会阻塞。
- 带有缓冲(buffer)的channel则可以非阻塞容纳N个元素。发送数据到缓冲(buffer) channel不会被阻塞,除非channel已满;同样的,从缓冲(buffer) channel取数据也不会被阻塞,除非channel空了。
怎么查看Goroutine的数量?link
监视Goroutine的数量,属于性能分析范畴
可以通过标准库内置的net/http/pprof监听pprof数据,并开启http服务器下载pprof性能分析报告
package main

import (
    _ "net/http/pprof"
    "net/http"
	"log"
)

func main() {

        go func() {
                log.Println(http.ListenAndServe("localhost:6060", nil))
        }()

        select{}
}
浏览器访问127.0.0.1:6060/debug/pprof/goroutine下载goroutine文件到本地。
来到文件所在文件夹,执行
go tool pprof -http=”:8081” goroutine
会自动打开浏览器,访问:http://localhost:8081/ui/

在图中可以清晰的看到goroutine的数量以及调用关系。
左侧的菜单栏,可以查看Top、Graph、Flame Graph等。
pprof也可以用于CPU、内存等分析,以及用火焰图分析代码性能。
火焰图分析性能 link
火焰图的调用顺序从下到上,每个方块代表一个函数,它上面一层表示这个函数会调用哪些函数,方块的大小代表了占用 CPU 使用的长短。
如何改变Goroutine可开启的最大数量?
在Golang中,GOMAXPROCS中控制的是未被阻塞的所有Goroutine,可以被 Multiplex 到多少个线程上运行,通过 GOMAXPROCS可以查看Goroutine的数量。
在Go1.8版本以后,它被自动设置为主机上的逻辑CPU数量。
在代码中,可以通过runtime.GOMAXPROCS(1)指定最大Process(可用CPU数量)= 1。
import (
	"fmt"
	"runtime"
)

func main(){
	cpuNum := runtime.NumCPU()
	fmt.Println("当前机器的逻辑CPU数量为:",cpuNum)
	runtime.GOMAXPROCS(cpuNum - 2)
}
怎么限制Goroutine的数量(设计协程池)
在Golang中,Goroutine虽然很好,但是数量太多了,往往会带来很多麻烦,比如耗尽系统资源导致程序崩溃,或者CPU使用率过高导致系统忙不过来。
所以我们可以限制下Goroutine的数量,这样就需要在每一次执行go之前判断goroutine的数量,如果数量超了,就要阻塞go的执行。
所以通常我们第一时间想到的就是使用通道。每次执行的go之前向通道写入值,直到通道满的时候就阻塞了。但是新的问题于是就出现了,因为并不是所有的goroutine都执行完了,在main函数退出之后,还有一些goroutine没有执行完就被强制结束了。这个时候我们就需要用到sync.WaitGroup。使用WaitGroup等待所有的goroutine退出。
package main

import (
    "fmt"
    "runtime"
    "sync"
    "time"
)

// Pool Goroutine Pool
type Pool struct {
    queue chan int
    wg *sync.WaitGroup
}

// New 新建一个协程池
func NewPool(size int) *Pool{
    if size <=0{
        size = 1
    }
    return &Pool{
        queue:make(chan int,size),
        wg:&sync.WaitGroup{},
    }
}

// Add 新增一个执行
func (p *Pool)Add(delta int){
    // delta为正数就添加
    for i :=0;i<delta;i++{
        p.queue <-1
    }
    // delta为负数就减少
    for i:=0;i>delta;i--{
        <-p.queue
    }
    p.wg.Add(delta)
}

// Done 执行完成减一
func (p *Pool) Done(){
    <-p.queue
    p.wg.Done()
}

// Wait 等待Goroutine执行完毕
func (p *Pool) Wait(){
    p.wg.Wait()
}

func main(){
    // 这里限制5个并发
    pool := NewPool(5)
    fmt.Println("the NumGoroutine begin is:",runtime.NumGoroutine())
    for i:=0;i<20;i++{
        pool.Add(1)
        go func(i int) {
            time.Sleep(time.Second)
            fmt.Println("the NumGoroutine continue is:",runtime.NumGoroutine())
            pool.Done()
        }(i)
    }
    pool.Wait()
    fmt.Println("the NumGoroutine done is:",runtime.NumGoroutine())
}
其中,Go的GOMAXPROCS默认值已经设置为CPU的核数, 这里允许我们的Go程序充分使用机器的每一个CPU,最大程度的提高我们程序的并发性能。
分析上述代码。
假设我们要运行20个协程,但是限制同时只能有5个协程并发。就需要设计一个协程池。NewPool()用于新建携程池,池子数据结构有两个字段,queue表示带size个缓冲的信道,用于控制并发数量,wg用于向下传递wg以及主协程Wait。
Go中的锁有哪些?
三种锁:读写锁,互斥锁,还有map的安全的锁
- 互斥锁
Go并发程序对共享资源进行访问控制的主要手段,由标准库代码包中sync中的Mutex结构体表示。
sync.Mutex包中的类型只有两个公开的指针方法Lock和Unlock。
// Locker表示可以锁定和解锁的对象。
type Locker interface {
   Lock()
   Unlock()
}

// 锁定当前的互斥量
// 如果锁已被使用,则调用goroutine
// 阻塞直到互斥锁可用。
func (m *Mutex) Lock()

// 对当前互斥量进行解锁
// 如果在进入解锁时未锁定m,则为运行时错误。
// 锁定的互斥锁与特定的goroutine无关。
// 允许一个goroutine锁定Mutex然后安排另一个goroutine来解锁它。
func (m *Mutex) Unlock()
可能会犯一个错误:忘记及时解开已被锁住的锁,从而导致流程异常。但Go由于存在defer,所以此类问题出现的概率极低。defer解锁的方式如下:
var mutex sync.Mutex
func Write()  {
   mutex.Lock()
   defer mutex.Unlock()
}
不可重入。如果对一个已经上锁的对象再次上锁,那么就会导致该锁定操作被阻塞,直到该互斥锁回到被解锁状态.
func main() {
    var mutex sync.Mutex
    fmt.Println("begin lock")
    mutex.Lock()
    fmt.Println("get locked")
    for i := 1; i <= 3; i++ {
        go func(i int) {
            fmt.Println("begin lock ", i)
            mutex.Lock()
            fmt.Println("get locked ", i)
        }(i)
    }
    time.Sleep(time.Second)
    fmt.Println("Unlock the lock")
    mutex.Unlock()
    fmt.Println("get unlocked")
    time.Sleep(time.Second)
}
在for循环之前开始加锁,然后在每一次循环中创建一个协程,并对其加锁,但是由于之前已经加锁了,所以这个for循环中的加锁会陷入阻塞直到main中的锁被解锁。 time.Sleep(time.Second) 是为了能让系统有足够的时间运行for循环,输出:
> go run mutex.go
begin lock
get locked
begin lock  3
begin lock  1
begin lock  2
Unlock the lock
get unlocked
get locked  3
这里,main解锁后,三个协程会重新抢夺互斥锁权,最终协程3获胜。
虽然互斥锁可以被多个协程共享,但还是建议将对同一个互斥锁的加锁解锁操作放在同一个层次的代码中。
互斥锁锁定操作的逆操作并不会导致协程阻塞,但是有可能导致引发一个无法恢复的运行时的panic,比如对一个未锁定的互斥锁进行解锁时就会发生panic。避免这种情况的最有效方式就是使用defer。
我们知道如果遇到panic,可以使用recover方法进行恢复,但是如果对重复解锁互斥锁引发的panic却是无用的(Go 1.8及以后)。
- 读写锁
读写锁是针对读写操作的互斥锁,可以分别针对读操作与写操作进行锁定和解锁操作 。
读写锁的访问控制规则如下:
- 多个写操作之间是互斥的
- 写操作与读操作之间也是互斥的
- 多个读操作之间不是互斥的
在这样的控制规则下,读写锁可以大大降低性能损耗。
在Go的标准库代码包中sync中的RWMutex结构体表示为:
// RWMutex是一个读/写互斥锁,可以由任意数量的读操作或单个写操作持有。
// RWMutex的零值是未锁定的互斥锁。
// **首次使用后,不得复制RWMutex**。
// 如果goroutine持有RWMutex进行读取而另一个goroutine可能会调用Lock,那么在释放初始读锁之前,goroutine不应该期望能够获取读锁定。
// 特别是,这种禁止递归读锁定。 这是为了确保锁最终变得可用; 阻止的锁定会阻止新读操作获取锁定。
type RWMutex struct {
     w           Mutex  //如果有待处理的写操作就持有
     writerSem   uint32 // 写操作等待读操作完成的信号量
     readerSem   uint32 //读操作等待写操作完成的信号量
     readerCount int32  // 待处理的读操作数量
     readerWait  int32  // number of departing readers
}
sync中的RWMutex有以下几种方法:
//对读操作的锁定
func (rw *RWMutex) RLock()

//对读操作的解锁
func (rw *RWMutex) RUnlock()

//对写操作的锁定
func (rw *RWMutex) Lock()

//对写操作的解锁
func (rw *RWMutex) Unlock()

//返回一个实现了sync.Locker接口类型的值,实际上是回调rw.RLock and rw.RUnlock.
func (rw *RWMutex) RLocker() Locker
Unlock方法会试图唤醒所有想进行读锁定而被阻塞的协程,而RUnlock方法只会在已无任何读锁定的情况下,试图唤醒一个因欲进行写锁定而被阻塞的协程。
若对一个未被写锁定的读写锁进行写解锁,就会引发一个不可恢复的panic,同理对一个未被读锁定的读写锁进行读写锁也会如此。
由于读写锁控制下的多个读操作之间不是互斥的,因此对于读解锁更容易被忽视。对于同一个读写锁,添加多少个读锁定,就必要有等量的读解锁,这样才能其他协程有机会进行操作。
因此Go中读写锁,在多个读线程可以同时访问共享数据,写线程必须等待所有读线程都释放锁以后,才能取得锁.
同样的,读线程必须等待写线程释放锁后,才能取得锁,也就是说读写锁要确保的是如下互斥关系,可以同时读,但是读-写,写-写都是互斥的。
- sync.Map安全锁
golang中的sync.Map是并发安全的,其实也就是sync包中golang自定义的一个名叫Map的结构体。
sync.Map的数据结构:
type Map struct {
 // 该锁用来保护dirty
 mu Mutex
 // 存读的数据,因为是atomic.value类型,只读类型,所以它的读是并发安全的
 read atomic.Value // readOnly
 //包含最新的写入的数据,并且在写的时候,会把read 中未被删除的数据拷贝到该dirty中,因为是普通的map存在并发安全问题,需要用到上面的mu字段。
 dirty map[interface{}]*entry
 // 从read读数据的时候,会将该字段+1,当等于len(dirty)的时候,会将dirty拷贝到read中(从而提升读的性能)。
 misses int
}
sync.Map是通过冗余的两个数据结构(read、dirty),实现性能的提升。
为了提升性能,load、delete、store等操作尽量使用只读的read;为了提高read的key击中概率,采用动态调整,将dirty数据提升为read;对于数据的删除,采用延迟标记删除法,只有在提升dirty的时候才删除。
具体过程:todo
Channel是同步的还是异步的
Channel是异步进行的, channel存在3种状态:
- nil,未初始化的状态,只进行了声明,或者手动赋值为nil
- active,正常的channel,可读或者可写
- closed,已关闭,千万不要误认为关闭channel后,channel的值是nil
下面我们对channel的三种操作解析:
- 零值(nil)通道;
- 非零值但已关闭的通道;
- 非零值并且尚未关闭的通道。
| 操作 | 一个零值nil通道 | 一个非零值但已关闭的通道 | 一个非零值且尚未关闭的通道 |
|---|---|---|---|
| 关闭 | 产生恐慌 | 产生恐慌 | 成功关闭 |
| 发送数据 | 永久阻塞 | 产生恐慌 | 阻塞或者成功发送 |
| 接收数据 | 永久阻塞 | 永不阻塞 | 阻塞或者成功接收 |
Goroutine和线程的区别
从调度上看,goroutine的调度开销远远小于线程调度开销。
OS的线程由OS内核调度,每隔几毫秒,一个硬件时钟中断发到CPU,CPU调用一个调度器内核函数。这个函数暂停当前正在运行的线程,把他的寄存器信息保存到内存中,查看线程列表并决定接下来运行哪一个线程,再从内存中恢复线程的注册表信息,最后继续执行选中的线程。这种线程切换需要一个完整的上下文切换:即保存一个线程的状态到内存,再恢复另外一个线程的状态,最后更新调度器的数据结构。某种意义上,这种操作还是很慢的。
Go运行的时候包涵一个自己的调度器,这个调度器使用一个称为一个M:N调度技术,m个goroutine到n个os线程(可以用GOMAXPROCS来控制n的数量),Go的调度器不是由硬件时钟来定期触发的,而是由特定的go语言结构来触发的,他不需要切换到内核语境,所以调度一个goroutine比调度一个线程的成本低很多。
从栈空间上,goroutine的栈空间更加动态灵活。
每个OS的线程都有一个固定大小的栈内存,通常是2MB,栈内存用于保存在其他函数调用期间哪些正在执行或者临时暂停的函数的局部变量。这个固定的栈大小,如果对于goroutine来说,可能是一种巨大的浪费。作为对比goroutine在生命周期开始只有一个很小的栈,典型情况是2KB, 在go程序中,一次创建十万左右的goroutine也不罕见(2KB*100,000=200MB)。而且goroutine的栈不是固定大小,它可以按需增大和缩小,最大限制可以到1GB。
goroutine没有一个特定的标识。
在大部分支持多线程的操作系统和编程语言中,线程有一个独特的标识,通常是一个整数或者指针,这个特性可以让我们构建一个线程的局部存储,本质是一个全局的map,以线程的标识作为键,这样每个线程可以独立使用这个map存储和获取值,不受其他线程干扰。
goroutine中没有可供程序员访问的标识,原因是一种纯函数的理念,不希望滥用线程局部存储导致一个不健康的超距作用,即函数的行为不仅取决于它的参数,还取决于运行它的线程标识。
Go的Struct能不能比较
- 相同struct类型的可以比较
- 不同struct类型的不可以比较,编译都不过,类型不匹配
Go的defer原理是什么
什么是defer?如何理解 defer 关键字?Go 中使用 defer 的一些坑。
defer 意为延迟,在 golang 中用于延迟执行一个函数。它可以帮助我们处理容易忽略的问题,如资源释放、连接关闭等。但在实际使用过程中,有一些需要注意的地方.
- 若函数中有多个 defer,其执行顺序为 先进后出,可以理解为栈。
- return 会做什么呢?
-
Go 的函数返回值是通过堆栈返回的, return 语句不是原子操作,而是被拆成了两步.
- 给返回值赋值 (rval)
- 调用 defer 表达式
- 返回给调用函数(ret)
func main() {
    fmt.Println(increase(1))
    // 输出:2
}

func increase(d int) (ret int) {
    defer func() {
        ret++
    }()

    return d
}
-
- 若 defer 表达式有返回值,将会被丢弃。
- 在实际开发中,defer 的使用经常伴随着闭包与匿名函数的使用。
-
闭包与匿名函数:
- 匿名函数:没有函数名的函数。
- 闭包:可以使用另外一个函数作用域中的变量的函数。闭包把函数和运行时的引用环境打包成为一个新的整体,当每次调用包含闭包的函数时都将返回一个新的闭包实例,这些实例之间是隔离的,分别包含调用时不同的引用环境现场。
func main() { for i := 0; i < 5; i++ { defer func() { fmt.Println(i) // 输出:5 5 5 5 5 // 因为,defer 表达式中的 i 是对 for 循环中 i 的引用。循环结束,i 加到 5。退出循环,main结束前,执行defer,获取i的值=5,最后全部打印 5。 }() } }- 如果将 i 作为参数传入 defer 表达式中,在传入最初就会进行求值保存,只是没有执行延迟函数而已。
func main() {
for i := 0; i < 5; i++ {
defer func(i int) {
fmt.Println(i)
// 输出:4 3 2 1 0
// 因为,将 i 作为参数传入 defer 表达式中,在传入最初就会进行求值保存,只是没有执行延迟函数而已。
}(i)
}
}
// f1
func f1() (result int) {
    defer func() {
        result++
    }()
    return 0
}
// 输出:1
// result=0;result++;return result;


// f2
func f2() (r int) {
    t := 5
   defer func() {
    t = t + 5
    // fmt.Println(t) // 这里加打印会打印10,因为临时变量t=闭包变量t+5,两个t只是名字相同,编译时不是同一个变量
   }()
   return t
}
// 输出:5
// f2内t:=5;r = f2内t;defer内用到f2内5的值(拷贝),给临时变量t赋值 = f2的t + 5;return r
// 可以理解成:
func f() (r int) {
     t := 5
     r = t // 赋值指令
     func() {        // defer被插入到赋值与返回之间执行,这个例子中返回值r没被修改过
         t = t + 5
     }()
     return        // 空的return指令
}


// f3
func f3() (r int) {
    defer func(r int) {
        r = r + 5
    }(r)
    return 1
}
// 输出:1
// 这里将 r 作为参数传入了 defer 表达式。故 func (r int) 中的 r 非 func f() (r int) 中的 r,只是参数命名相同而已。
// r = 1;defer 用到参数r,赋值给临时变量r,返回也是临时变量r,都和参数r无关。把r=r+5换成r++操作的也是临时变量;return 没有变化的变量r
// 可以理解成:
func f() (r int) {
     r = 1  // 给返回值赋值
     func(r int) {        // 这里改的r是传值传进去的r,不会改变要返回的那个r值
          r = r + 5
     }(r)
     return        // 空的return
}

// 要想在闭包中改变外部变量,需要传入指针(注意,func内由于go语言的特性,*r可以简写成r,编译后是指针)
func f4_omit_pointer() (r int) {
	defer func(*int) {
		r = r + 5
	}(&r)
	return 1
}
// 输出6
Go的select可以用于什么
select, poll, epoll 的功能:监听多个描述符的读/写等事件,一旦某个描述符就绪(一般是读或者写事件发生了),就能够将发生的事件通知给关心的应用程序去处理该事件。
golang 的 select 机制是,监听多个channel,每一个 case 是一个事件,可以是读事件也可以是写事件,随机选择一个执行,可以设置default,它的作用是:监听的多个事件都会阻塞住执行default的逻辑。
goroutine的优雅退出方法有几种 link
goroutine作为Golang并发的核心,我们不仅要关注它们的创建和管理,当然还要关注如何合理的退出这些协程,不(合理)退出不然可能会造成阻塞、panic、程序行为异常、数据结果不正确等问题。goroutine在退出方面,不像线程和进程,不能通过某种手段强制关闭它们,只能等待goroutine主动退出。
-
使用for-range退出
- for-range是使用频率很高的结构,常用它来遍历数据,range能够感知channel的关闭,当channel被发送数据的协程关闭时,range就会结束,接着退出for循环。
- 它在并发中的使用场景是:当协程只从1个channel读取数据,然后进行处理,处理后协程退出。
go func(in <-chan int) { // 补充:channel可以从读写信道转成单向信道,所以用单向信道作为参数是个很好的习惯 // Using for-range to exit goroutine // range has the ability to detect the close/end of a channel for x := range in { fmt.Printf("Process %d\n", x) } }(in) - 在for-select中使用”case val,ok := <-in”退出
- 使用退出通道退出。实际上就是在函数参数中包含一个专门的通道,发送退出的信号
在退出协程的时候需要注意:
- 发送协程主动关闭通道,接收协程不关闭通道。使用技巧:把接收方的通道入参声明为只读,如果接收协程关闭只读协程,编译时就会报错。上面例子中func内是对信道的接收操作,参数声明为只读信道,不用关闭信道。
- 协程处理1个通道,并且是读时,协程优先使用for-range,因为range可以关闭通道的方式自动退出协程。
- ,ok可以处理多个读通道关闭,需要关闭当前使用for-select的协程。
- 显式关闭通道stopCh可以处理主动通知协程退出的场景。
详情todo
Context包的用途是什么
在 Go http包的Server中,每一个请求在都有一个对应的 goroutine 去处理。请求处理函数通常会启动额外的 goroutine 用来访问后端服务,比如数据库和RPC服务。用来处理一个请求的 goroutine 通常需要访问一些与请求特定的数据,比如终端用户的身份认证信息、验证相关的token、请求的截止时间。 当一个请求被取消或超时时,所有用来处理该请求的 goroutine 都应该迅速退出,然后系统才能释放这些 goroutine 占用的资源。
在Google 内部,我们开发了** Context 包,专门用来简化 对于处理单个请求的多个 goroutine 之间与请求域的数据、取消信号、截止时间等相关操作,这些操作可能涉及多个 API 调用**。
context包的作用:处理多个 goroutine 之间共享数据,及多个 goroutine 的管理
需要注意一点的是在goroutine中使用context包的时候,通常我们需要在goroutine中新创建一个上下文的context,原因是:如果直接传递外部context到协程中,一个请求可能在主函数中已经结束,在goroutine中如果还没有结束的话,会直接导致goroutine中的运行的被取消.比如,当api1调用api2时,由于api1花费了太多时间在其他问题上,导致临近context超时时间,然后调用api2后,瞬间超时,这样api1超时影响到了api2的调用,看起来还像是api2超时了一样。
context包的struct Context包含的方法:Done、Err、Deadline、Value(数据必须线程安全)Context 对象是线程安全的,你可以把一个 Context 对象传递给任意个数的 gorotuine,对它执行 取消 操作时,所有 goroutine 都会接收到取消信号。
context.Background函数的返回值是一个空的context,经常作为树的根结点,它一般由接收请求的第一个routine创建,不能被取消、没有值、也没有过期时间。
WithCancel 和 WithTimeout 函数 会返回继承的 Context 对象, 这些对象可以比它们的父 Context 更早地取消。
当请求处理函数返回时,与该请求关联的 Context 会被取消。 当使用多个副本发送请求时,可以使用 WithCancel取消多余的请求。 WithTimeout 在设置对后端服务器请求截止时间时非常有用。
Context上下文数据的存储就像一个树,每个结点只存储一个 key/value对。WithValue()保存一个 key/value对,它将父context嵌入到新的子context,并在节点中保存了 key/value数据。Value()查询key对应的value数据,会从当前context中查询,如果查不到,会递归查询父context中的数据。
值得注意的是,context中的上下文数据并不是全局的,它只查询本节点及父节点们的数据,不能查询兄弟节点的数据。
Context 使用原则:
- 不要把Context放在结构体中,要以参数的方式传递。
- 以Context作为参数的函数方法,应该把Context作为第一个参数,放在第一位。
- 给一个函数方法传递Context的时候,不要传递nil,如果不知道传递什么,就使用context.TODO。
- Context的Value相关方法应该传递必须的数据,不要什么数据都使用这个传递。
- Context是线程安全的,可以放心的在多个goroutine中传递。
Go主协程如何等其余协程完再操作?
sync.WaitGroup。WaitGroup,就是用来等待一组操作完成的。WaitGroup内部实现了一个计数器,用来记录未完成的操作个数.
它提供了三个方法,Add()用来添加(1)或减少(-1)计数。Done()用来在操作结束时调用,使计数减一。Wait()用来等待所有的操作结束,即计数变为0,该函数会在计数不为0时等待,在计数为0时立即返回。
Go的Slice如何扩容
slice是 Go 中的一种基本的数据结构,使用这种结构可以用来管理数据集合。slice常见的操作有 reslice、append、copy。
slice自身并不是动态数组或者数组指针。它内部实现的数据结构通过指针引用底层数组,设定相关属性将数据读写操作限定在指定的区域内。slice本身是一个只读对象,其工作机制类似数组指针的一种封装。
slice是对数组一个连续片段的引用,所以切片是一个引用类型(因此更类似于 C/C++ 中的数组类型,或者 Python 中的 list类型)。这个片段可以是整个数组,或者是由起始和终止索引标识的一些项的子集。
这里需要注意的是,终止索引标识的项不包括在切片内。切片提供了一个指向数组的动态窗口。
slice是可以看做是一个长度可变的数组。
slice数据结构如下:
type slice struct {
    array unsafe.Pointer
    len   int
    cap   int
}
slice的结构体由3部分构成,Pointer 是指向一个数组的指针,len 代表当前切片的长度,cap 是当前切片的容量。cap 总是大于等于 len 的。
通常我们在对slice进行append等操作时,可能会造成slice的自动扩容。
其扩容时的大小增长规则是:
- 如果切片的容量小于1024个元素,那么扩容的时候slice的cap就翻番,乘以2;一旦元素个数超过1024个元素,增长因子就变成1.25,即每次增加原来容量的四分之一。
- 如果扩容之后,还没有触及原数组的容量,那么,切片中的指针指向的位置,就还是原数组,如果扩容之后,超过了原数组的容量,那么,Go就会开辟一块新的内存,把原来的值拷贝过来,这种情况丝毫不会影响到原数组。
map如何顺序读取? link
Golang中map的遍历输出的时候是无序的,不同的遍历会有不同的输出结果。如果想要顺序输出的话,需要额外保存顺序,例如使用slice保存map的key,将slice排序,再通过sort包对slice排序后,按序读取map。
package main

import (
    "fmt"
    "sort"
)

func main() {
    var m = map[string]int{
        "hello":         0,
        "morning":       1,
        "keke":          2,
        "jame":          3,
    }
	// fmt.Println(m) // 打印得到固定顺序:map[hello:0 jame:3 keke:2 morning:1]
    var keys []string
    for k := range m { // 忽略v,把k入slice
		// fmt.Println(k) // 从map读数据是无序的
        keys = append(keys, k)
    }
	// fmt.Println(keys) // 打印会得到不同的顺序,比如:[jame hello morning keke]
    sort.Strings(keys) // 对key slice 原地排序
	// fmt.Println(keys) // 打印得到固定顺序:[hello jame keke morning]
    for _, k := range keys {
        fmt.Println("Key:", k, "Value:", m[k])
    }
}
输出:
Key: hello Value: 0
Key: jame Value: 3
Key: keke Value: 2
Key: morning Value: 1
package main

import (
    "fmt"
    "sort"
)

func main() {
    /* 声明索引类型为字符串的map */
    var testMap = make(map[string]string)
    testMap["Bda"] = "B"
    testMap["Ada"] = "A"
    testMap["Dda"] = "D"
    testMap["Cda"] = "C"
    testMap["Eda"] = "E"

    for key, value := range testMap {
        fmt.Println(key, ":", value)
    }
    var testSlice []string
    testSlice = append(testSlice, "Bda", "Ada", "Dda", "Cda", "Eda")

    /* 对slice数组进行排序,然后就可以根据key值顺序读取map */
    sort.Strings(testSlice)
    fmt.Println("排序输出:")
    for _, Key := range testSlice {
        /* 按顺序从MAP中取值输出 */
        if Value, ok := testMap[Key]; ok {
            fmt.Println(Key, ":", Value)
        }
    }
}
输出:
Bda : B
Ada : A
Dda : D
Cda : C
Eda : E
排序输出:
Ada : A
Bda : B
Cda : C
Dda : D
Eda : E
Go中CAS是怎么回事?
CAS算法(Compare And Swap),是原子操作的一种, CAS算法是一种有名的无锁算法。无锁编程,即不使用锁的情况下实现多线程之间的变量同步,也就是在没有线程被阻塞的情况下实现变量的同步,所以也叫非阻塞同步(Non-blocking Synchronization)。可用于在多线程编程中实现不被打断的数据交换操作,从而避免多线程同时改写某一数据时由于执行顺序不确定性以及中断的不可预知性产生的数据不一致问题。
该操作通过将内存中的值与指定数据进行比较,当数值一样时将内存中的数据替换为新的值。
Go中的CAS操作是借用了CPU提供的原子性指令来实现。CAS操作修改共享变量时候不需要对共享变量加锁,而是通过类似乐观锁的方式进行检查,本质还是不断的占用CPU资源换取加锁带来的开销(比如上下文切换开销)。
sync/atomic包用于原子操作。
package main

import (
    "fmt"
    "sync"
    "sync/atomic"
)

var (
    counter int32          //计数器
    wg      sync.WaitGroup //信号量
)

func main() {
    threadNum := 50000
    wg.Add(threadNum)
    for i := 0; i < threadNum; i++ {
        go incCounter(i)
    }
    wg.Wait()
	fmt.Printf("final counter:%d\n", counter)
}

func incCounter(index int) {
    defer wg.Done()

	// 逻辑:自旋锁中持续CAS,修改成功就break,不成功就进入下一循环(计数+1)
    spinNum := 0 // 自旋失败计数
    for {
        // 原子操作
        old := counter
        ok := atomic.CompareAndSwapInt32(&counter, old, old+1)
        if ok {
            break
        } else {
            spinNum++
        }
    }
	if spinNum > 0 {
		fmt.Printf("thread,%d,spinnum,%d\n", index, spinNum)
	}

}
当协程数量=5时:
主函数main首先创建了5个信号量,然后开启五个线程执行incCounter方法,incCounter内部执行, 使用cas操作递增counter的值,atomic.CompareAndSwapInt32具有三个参数,第一个是变量的地址,第二个是变量当前值,第三个是要修改变量为多少,该函数如果发现传递的old值等于当前变量的值,则使用第三个变量替换变量的值并返回true,否则返回false。
这里之所以使用无限循环是因为在高并发下每个线程执行CAS并不是每次都成功,失败了的线程需要重写获取变量当前的值,然后重新执行CAS操作。
现在把线程数改为50000就会发现输出
...
thread,49946,spinnum,3
thread,49936,spinnum,3
thread,49994,spinnum,3
final counter:50000
这里3就说明该线程尝试了4次CAS操作,前3次都失败了,第4次才成功。
因此呢, go中CAS操作可以有效的减少使用锁所带来的开销,但是需要注意在高并发下这是使用cpu资源做交换的。
其他CAS函数 todo
Go中的逃逸分析是什么?怎么避免内存逃逸?栈内存管理与逃逸分析
在Go中逃逸分析是一种确定指针动态范围的方法,可以分析在程序的哪些地方可以访问到指针。它涉及到指针分析和形状分析。
当一个变量(或对象)在子程序中被分配时,一个指向变量的指针可能逃逸到其它执行线程中,或者去调用子程序。如果使用尾递归优化(通常在函数编程语言中是需要的),对象也可能逃逸到被调用的子程序中。 如果一个子程序分配一个对象并返回一个该对象的指针,该对象可能在程序中的任何一个地方被访问到——这样指针就成功“逃逸”了。
如果指针存储在全局变量或者其它数据结构中,它们也可能发生逃逸,这种情况是当前程序中的指针逃逸。 逃逸分析需要确定指针所有可以存储的地方,保证指针的生命周期只在当前进程或线程中。
导致内存逃逸的情况比较多,有些可能还是官方未能够实现精确的分析逃逸情况的 bug,通常来讲就是如果变量的作用域不会扩大并且其行为或者大小能够在编译的时候确定,一般情况下都是分配到栈上,否则就可能发生内存逃逸分配到堆上。
内存逃逸的五种情况:
- 发送指针的指针或值包含了指针到channel 中,由于在编译阶段无法确定其作用域与传递的路径,所以一般都会逃逸到堆上分配。
- slices 中的值是指针的指针或包含指针字段。一个例子是类似[]*string 的类型。这总是导致 slice 的逃逸。即使切片的底层存储数组仍可能位于堆栈上,数据的引用也会转移到堆中。
- slice 由于 append 操作超出其容量,因此会导致 slice 重新分配。这种情况下,由于在编译时 slice 的初始大小的已知情况下,将会在栈上分配。如果 slice 的底层存储必须基于仅在运行时数据进行扩展,则它将分配在堆上。
- 调用接口类型的方法。接口类型的方法调用是动态调度,实际使用的具体实现只能在运行时确定。考虑一个接口类型为 io.Reader 的变量 r。对 r.Read(b) 的调用将导致 r 的值和字节片b的后续转义并因此分配到堆上。
- 尽管能够符合分配到栈的场景,但是其大小不能够在在编译时候确定的情况,也会分配到堆上.
有效的避免上述的五种逃逸的情况,就可以避免内存逃逸.
Go值接收者和指针接收者的区别
Go中的方法能给用户自定义的类型添加新的行为。它和函数的区别在于方法有一个接收者,给一个函数添加一个接收者,那么它就变成了方法。接收者可以是值接收者,也可以是指针接收者。
在调用方法的时候,值类型既可以调用值接收者的方法,也可以调用指针接收者的方法;指针类型既可以调用指针接收者的方法,也可以调用值接收者的方法。
也就是说,不管方法的接收者是什么类型,该类型的值和指针都可以调用,不必严格符合接收者的类型。
**如果实现了接收者是值类型的方法,会隐含地也实现了接收者是指针类型的方法。
如果方法的接收者是值类型,无论调用者是对象还是对象指针,修改的都是对象的副本,不影响调用者;如果方法的接收者是指针类型,则调用者修改的是指针指向的对象本身。
- 通常我们使用指针作为方法的接收者的理由:
- 使用指针方法能够修改接收者指向的值。
- 可以避免在每次调用方法时复制该值,在值的类型为大型结构体时,这样做会更加高效。
因而呢,我们是使用值接收者还是指针接收者,不是由该方法是否修改了调用者(也就是接收者)来决定,而是应该基于该类型的本质。
如果类型具备“原始的本质”,也就是说它的成员都是由 Go 语言里内置的原始类型,如字符串,整型值等,那就定义值接收者类型的方法。像内置的引用类型,如 slice,map,interface,channel,这些类型比较特殊,声明他们的时候,实际上是创建了一个 header, 对于他们也是直接定义值接收者类型的方法。这样,调用函数时,是直接 copy 了这些类型的 header,而 header 本身就是为复制设计的。
如果类型具备非原始的本质,不能被安全地复制,这种类型总是应该被共享,那就定义指针接收者的方法。比如 sync.WaitGroup就不应该被复制,应该只有一份实体,作为参数传入goroutine时应该用指针:
func (wg *WaitGroup) Wait() {}
接口值的零值是指动态类型和动态值都为 nil。当仅且当这两部分的值都为 nil 的情况下,这个接口值就才会被认为 接口值 == nil。
Go的对象在内存中是怎样分配的
Go的内存分配原则:
Go在程序启动的时候,会先向操作系统申请一块内存(注意这时还只是一段虚拟的地址空间,并不会真正地分配内存),切成小块后自己进行管理。
申请到的内存块被分配了三个区域,在X64上分别是512MB,16GB,512GB大小。

arena区域就是我们所谓的堆区,Go动态分配的内存都是在这个区域,它把内存分割成8KB大小的页,一些页组合起来称为mspan。
todo
栈的内存是怎么分配的
栈和堆只是虚拟内存上2块不同功能的内存区域:
- 栈在高地址,从高地址向低地址增长。
- 堆在低地址,从低地址向高地址增长。
栈和堆相比优势:
- 栈的内存管理简单,分配比堆上快。
- 栈的内存不需要回收,而堆需要,无论是主动free,还是被动的垃圾回收,这都需要花费额外的CPU。
- 栈上的内存有更好的局部性,堆上内存访问就不那么友好了,CPU访问的2块数据可能在不同的页上,CPU访问数据的时间可能就上去了。
堆内存管理怎么分配的
通常在Golang中,当我们谈论内存管理的时候,主要是指堆内存的管理,因为栈的内存管理不需要程序去操心。
堆内存管理中主要是三部分, 1.分配内存块,2.回收内存块, 3.组织内存块。
一个内存块包含了3类信息,如下图所示,元数据、用户数据和对齐字段,内存对齐是为了提高访问效率。下图申请5Byte内存的时候,就需要进行内存对齐。

释放内存实质是把使用的内存块从链表中取出来,然后标记为未使用,当分配内存块的时候,可以从未使用内存块中有先查找大小相近的内存块,如果找不到,再从未分配的内存中分配内存。
上面这个简单的设计中还没考虑内存碎片的问题,因为随着内存不断的申请和释放,内存上会存在大量的碎片,降低内存的使用率。为了解决内存碎片,可以将2个连续的未使用的内存块合并,减少碎片。
todo
在Go函数中为什么会发生内存泄露
通常内存泄漏,指的是能够预期的能很快被释放的内存由于附着在了长期存活的内存上、或生命期意外地被延长,导致预计能够立即回收的内存而长时间得不到回收。
在 Go 中,由于 goroutine 的存在,因此,内存泄漏除了附着在长期对象上之外,还存在多种不同的形式。
- 预期能被快速释放的内存因被根对象引用而没有得到迅速释放。 当有一个全局对象时,可能不经意间将某个变量附着在其上,且忽略的将其进行释放,则该内存永远不会得到释放。
- goroutine 泄漏 Goroutine 作为一种逻辑上理解的轻量级线程,需要维护执行用户代码的上下文信息。在运行过程中也需要消耗一定的内存来保存这类信息,而这些内存在目前版本的 Go 中是不会被释放的。
因此,如果一个程序持续不断地产生新的 goroutine、且不结束已经创建的 goroutine 并复用这部分内存,就会造成内存泄漏的现象.
Go中new和make的区别
在Go中,值类型和引用类型:
- 值类型:int,float,bool,string,struct和array. 变量直接存储值,分配栈区的内存空间,这些变量所占据的空间在函数被调用完后会自动释放。
- 引用类型:slice,map,chan和值类型对应的指针. 变量存储的是一个地址(或者理解为指针),指针指向内存中真正存储数据的首地址。内存通常在堆上分配,通过GC回收。
这里需要注意的是: 对于引用类型的变量,我们不仅要声明变量,更重要的是,我们得手动为它分配空间.
因此new该方法的参数要求传入一个类型,而不是一个值,它会申请一个该类型大小的内存空间,并会初始化为对应的零值,返回指向该内存空间的一个指针。
而make也是用于内存分配,但是和new不同,只用来引用对象slice、map和channel的内存创建,它返回的类型就是类型本身,而不是它们的指针类型。
package main

import "fmt"

type myChan chan int

func main() {
	var1 := make(chan int)
	var2 := make(myChan)
	var3 := new(myChan)

	fmt.Printf("%T, %T, %T", var1, var2, var3) // 输出chan int, main.myChan, *main.myChan
}
Go中的锁如何实现
锁是一种同步机制,用于在多任务环境中限制资源的访问,以满足互斥需求。
go源码sync包中经常用于同步操作的方式:
- 原子操作
- 互斥锁
- 读写锁
-
waitgroup
- 互斥锁sync.Mutex
- sync.Mutex 有两种模式,正常模式和饥饿模式。
- 饥饿模式是在 Go 语言 1.9 版本引入的优化的,引入的目的是保证互斥锁的公平性(Fairness)。
- 如果一个 Goroutine 获得了互斥锁并且它在队列的末尾或者它等待的时间少于 1ms,那么当前的互斥锁就会被切换回正常模式。
- 相比于饥饿模式,正常模式下的互斥锁能够提供更好地性能,饥饿模式的能避免 Goroutine 由于陷入等待无法获取锁而造成的高尾延时。
- 互斥锁的加锁过程比较复杂,它涉及自旋、信号量以及调度等概念:
- 如果互斥锁处于初始化状态,就会直接通过置位 mutexLocked 加锁;
- 如果互斥锁处于 mutexLocked 并且在普通模式下工作,就会进入自旋,执行 30 次 PAUSE 指令消耗 CPU 时间等待锁的释放;
- 如果当前 Goroutine 等待锁的时间超过了 1ms,互斥锁就会切换到饥饿模式;
- 互斥锁在正常情况下会通过runtime.sync_runtime_SemacquireMutex函数将尝试获取锁的 Goroutine 切换至休眠状态,等待锁的持有者唤醒当前 Goroutine;
- 如果当前 Goroutine 是互斥锁上的最后一个等待的协程或者等待的时间小于 1ms,当前 Goroutine 会将互斥锁切换回正常模式;
- 互斥锁的解锁过程与之相比就比较简单,其代码行数不多、逻辑清晰,也比较容易理解:
- 当互斥锁已经被解锁时,那么调用sync.Mutex.Unlock 会直接抛出异常;
- 当互斥锁处于饥饿模式时,会直接将锁的所有权交给队列中的下一个等待者,等待者会负责设置mutexLocked 标志位;
- 当互斥锁处于普通模式时,如果没有 Goroutine 等待锁的释放或者已经有被唤醒的 Goroutine 获得了锁,就会直接返回;在其他情况下会通过sync.runtime_Semrelease 唤醒对应的 Goroutine.
- 读写互斥锁sync.RWMutex
- 读写互斥锁 sync.RWMutex 是细粒度的互斥锁,它不限制资源的并发读,但是读写、写写操作无法并行执行。
- 读写互斥锁(sync.RWMutex)虽然提供的功能非常复杂,不过因为它是在互斥锁( sync.Mutex)的基础上,所以整体的实现上会简单很多。
- 调用sync.RWMutex.Lock 尝试获取写锁时;
- 每次 sync.RWMutex.RUnlock 都会将 readerCount 其减一,当它归零时该 Goroutine 就会获得写锁, 将 readerCount 减少 rwmutexMaxReaders 个数以阻塞后续的读操作.
- 调用sync.RWMutex.Unlock 释放写锁时,会先通知所有的读操作,然后才会释放持有的互斥锁;
- 读写互斥锁在互斥锁之上提供了额外的更细粒度的控制,能够在读操作远远多于写操作时提升性能。
atomic 和 waitGroup 略
todo
Go中的channel的实现
Channel 收发操作均遵循了先入先出(FIFO)的设计,具体规则如下:
- 先从 Channel 读取数据的 Goroutine 会先接收到数据;
- 先向 Channel 发送数据的 Goroutine 会得到先发送数据的权利;
Channel 通常会有以下三种类型:
- 同步 Channel — 不需要缓冲区,发送方会直接将数据交给(Handoff)接收方;
- 异步 Channel — 基于环形缓存的传统生产者消费者模型;
- chan struct{} 类型的异步Channel 的struct{} 类型不占用内存空间,不需要实现缓冲区和直接发送(Handoff)的语义;
- 省内存,尤其在事件通信的时候。
- struct零值就是本身,读取close的channel返回零值
常用用法:
一般都是用来实现同步。channel 不需要发送任何的数据,只用来通知子协程(goroutine)执行任务,或只用来控制协程并发度。
举例:
package main

import "fmt"

func worker(ch chan struct{}) {
	ch <- struct{}{}
	fmt.Println("do something")
	close(ch) // 技巧:虽然gc可以回收ch,但是消耗资源。所以写信道操作结束后最好关闭信道
}

func main() {
	ch := make(chan struct{})
	go worker(ch)
	<-ch
}
Go中的map的实现
Go中Map是一个KV对集合。底层使用 hash table,用链表来解决冲突 ,出现冲突时,不是每一个Key都申请一个结构通过链表串起来,而是以bmap为最小粒度挂载,一个bmap可以放8个kv。
选择hash函数主要考察的是两点:性能、碰撞概率。
bmap 就是我们常说的“桶”(bucket),桶里面会最多装 8 个 key,这些 key之所以会落入同一个桶,是因为它们经过哈希计算后,哈希结果是“一类”的,关于key的定位我们在map的查询和赋值中详细说明。
todo
在桶内,又会根据key计算出来的hash值的高8位来决定 key到底落入桶内的哪个位置(一个桶内最多有8个位置)。
Go中的http包的实现原理
Golang中http包中处理 HTTP 请求主要跟两个东西相关:ServeMux 和 Handler。
ServeMux 本质上是一个 HTTP 请求路由器(或者叫多路复用器,Multiplexor)。它把收到的请求与一组预先定义的 URL 路径列表做对比,然后在匹配到路径的时候调用关联的处理器(Handler)。
处理器(Handler)负责输出HTTP响应的头和正文。任何满足了http.Handler接口的对象都可作为一个处理器。通俗的说,对象只要有个如下签名的ServeHTTP方法即可:
ServeHTTP(http.ResponseWriter, *http.Request)
Go 语言的 HTTP 包自带了几个函数用作常用处理器,比如 FileServer,NotFoundHandler 和 RedirectHandler。
举例:
package main

import (
    "log"
    "net/http"
)

func main() {
    mux := http.NewServeMux()

    rh := http.RedirectHandler("http://www.baidu.com", 307)
    mux.Handle("/foo", rh)

    log.Println("Listening...")
    http.ListenAndServe(":3000", mux)
    // 访问http://localhost:3000/foo
}
// net/http/server.go

type Handler interface {
	ServeHTTP(ResponseWriter, *Request)
}

// 重定向处理方法
func RedirectHandler(url string, code int) Handler {
	return &redirectHandler{url, code}
}
type redirectHandler struct {
	url  string
	code int
}
// 重定向处理方法实现了ServeHTTP,使得rh成为Handler接口类型
func (rh *redirectHandler) ServeHTTP(w ResponseWriter, r *Request) {
	Redirect(w, r, rh.url, rh.code)
}

// 1. 创建mux
func NewServeMux() *ServeMux { return new(ServeMux) }

// 2. 给mux绑定pattern和处理过程(只要实现ServerHttp方法,就成为Handle接口类型)
func (mux *ServeMux) Handle(pattern string, handler Handler) {}

// 3. 开启服务
func ListenAndServe(addr string, handler Handler) error {
	server := &Server{Addr: addr, Handler: handler}
	return server.ListenAndServe()
}
在这个应用示例中,首先在 main 函数中我们只用了 http.NewServeMux 函数来创建一个空的 ServeMux。 然后我们使用 http.RedirectHandler 函数创建了一个新的处理器,这个处理器会对收到的所有请求,都执行307重定向操作到 http://www.baidu.com。
接下来我们使用 ServeMux.Handle 函数将处理器注册到新创建的 ServeMux,所以它在 URL 路径 /foo 上收到所有的请求都交给这个处理器。 最后我们创建了一个新的服务器,并通过 http.ListenAndServe 函数监听所有进入的请求,通过传递刚才创建的 ServeMux来为请求去匹配对应处理器。
在浏览器中访问 http://localhost:3000/foo,你应该能发现请求已经成功的重定向了。
此刻你应该能注意到一些有意思的事情:ListenAndServer 的函数签名是 ListenAndServe(addr string, handler Handler) ,但是第二个参数我们传递的是个 ServeMux。
通过这个例子我们就可以知道,net/http包在编写golang web应用中有很重要的作用,它主要提供了基于HTTP协议进行工作的client实现和server实现,可用于编写HTTP服务端和客户端。
Goroutine发生了泄漏如何检测 gops
可以通过Go自带的工具pprof或者使用Gops去检测诊断当前在系统上运行的Go进程的占用的资源.
pprof过程在上面,略。
gops用来获取go进程运行时信息。
可以查看:
- 当前有哪些go语言进程,哪些使用gops的go进程
- 进程的概要信息
- 进程的调用栈
- 进程的内存使用情况
- 构建程序的Go版本
- 运行时统计信息
可以获取:
- trace cpu profile和memory profile
- 让进程进行1次GC
- 设置GC百分比
gops的原理是,代码中导入gops/agent,建立agent服务,gops命令连接agent读取进程信息。
package main

import (
	"log"
	"runtime"
	"time"

	"github.com/google/gops/agent"
)

func main() {
	if err := agent.Listen(agent.Options{
		Addr:            "0.0.0.0:8848",
		// ConfigDir:       "/home/centos/gopsconfig", // 最好使用默认
		ShutdownCleanup: true}); err != nil {
		log.Fatal(err)
	}

    // 测试代码
	_ = make([]int, 1000, 1000)
	runtime.GC()

	_ = make([]int, 1000, 2000)
	runtime.GC()

	time.Sleep(time.Hour)
}
$ go get github.com/google/gops
agent有3个配置:
- Addr:agent要监听的ip和端口,默认ip为环回地址,端口随机分配。
- ConfigDir:该目录存放的不是agent的配置,而是每一个使用了agent的go进程信息,文件以pid命名,内容是该pid进程所监听的端口号,所以其中文件的目的是形成pid到端口的映射。默认值为~/.config/gops
- ShutdownCleanup:进程退出时,是否清理ConfigDir中的文件,默认值为false,不清理
通常可以把Addr设置为要监听的IP,把ShutdownCleanup设置为ture,进程退出后,残留在ConfigDir目录的文件不再有用,最好清除掉。
分析过程:
gops可以列出当前机器上的go进程,其中带”*“的是agent进程。也可以通过lsof -i:8848查到agent监听的进程id
下面是一些常用命令:
- 查看进程树:gops tree
- 查看进程概要(非gops进程也可以):gops 进程pid
- 查看使用gops的进程的调用栈:gops stack 进程pid
- 查看gops进程内存使用情况:gops memstats 进程pid
- 查看运行时信息(协程数量统计等):gops stats 进程pid
- 获取当前运行5s的trace信息,会打开网页:gops trace 进程pid
- 获取cpu profile,并进入交互模式:gops pprof-cpu 进程pid
- 获取memory profile,并进入交互模式:gops pprof-heap 进程pid
对于内存泄露分析,就可以用memstats查看内存数据
$ gops memstats 67944
alloc: 136.80KB (140088 bytes) // 当前分配出去未收回的内存总量
total-alloc: 152.08KB (155728 bytes) // 已分配出去的内存总量
sys: 67.25MB (70518784 bytes) // 当前进程从OS获取的内存总量
lookups: 0
mallocs: 418 // 分配的对象数量
frees: 82 // 释放的对象数量
heap-alloc: 136.80KB (140088 bytes) // 当前分配出去未收回的堆内存总量
heap-sys: 63.56MB (66650112 bytes) // 当前堆从OS获取的内存
heap-idle: 62.98MB (66035712 bytes) // 当前堆中空闲的内存量
heap-in-use: 600.00KB (614400 bytes) // 当前堆使用中的内存量
heap-released: 62.89MB (65945600 bytes)
heap-objects: 336 // 堆中对象数量
stack-in-use: 448.00KB (458752 bytes) // 栈使用中的内存量
stack-sys: 448.00KB (458752 bytes) // 栈从OS获取的内存总量
stack-mspan-inuse: 10.89KB (11152 bytes)
stack-mspan-sys: 16.00KB (16384 bytes)
stack-mcache-inuse: 13.56KB (13888 bytes)
stack-mcache-sys: 16.00KB (16384 bytes)
other-sys: 1.01MB (1062682 bytes)
gc-sys: 2.21MB (2312192 bytes)
next-gc: when heap-alloc >= 4.00MB (4194304 bytes) // 下次GC的条件
last-gc: 2020-03-16 10:06:26.743193 +0800 CST // 上次GC的时间
gc-pause-total: 83.84µs // GC总暂停时间
gc-pause: 44891 // 上次GC暂停时间,单位纳秒
num-gc: 2 // 已进行的GC次数
enable-gc: true // 是否开始GC
debug-gc: false
支持远程主机:
- 修改程序,在Option中设置监听的地址和端口
agent.Listen(agent.Options{Addr:"0.0.0.0:8848"}) - 在远程主机上重新编译、重启进程,确认进程监听的端口
- 在本地主机上使用gops连接远端go进程,并查看数据
gops stats 192.168.9.137:8848
Go函数返回局部变量的指针是否安全
在 Go 中是安全的,Go 编译器将会对每个局部变量进行逃逸分析。如果发现局部变量的作用域超出该函数,则不会将内存分配在栈上,而是分配在堆上
Go中两个Nil可能不相等吗
Go中两个Nil可能不相等。
接口(interface) 是对非接口值(例如指针,struct等)的封装,内部实现包含 2 个字段,类型 T 和 值 V。一个接口等于 nil,当且仅当 T 和 V 处于 unset 状态(T=nil,V is unset)。
两个接口值比较时,会先比较 T,再比较 V。 接口值与非接口值比较时,会先将非接口值尝试转换为接口值,再比较。
func main() {
    var p *int = nil
    var i interface{} = p
    fmt.Println(i == p) // true
    fmt.Println(p == nil) // true
    fmt.Println(i == nil) // false
}
将一个nil非接口值p赋值给接口i,此时,i的内部字段为(T=*int, V=nil),i与p作比较时,将 p 转换为接口后再比较,因此 i == p。
p 与 nil 比较,直接比较值,所以 p == nil
当 i 与nil比较时,会将nil转换为接口(T=nil, V=nil),与i(T=*int, V=nil)不相等,因此 i != nil。因此 V 为 nil ,但 T 不为 nil 的接口不等于 nil。
为何GPM调度要有P
GM 模型的缺点:
Go1.0 的 GM 模型的 Goroutine 调度器限制了用 Go 编写的并发程序的可扩展性,尤其是高吞吐量服务器和并行计算程序。
GM调度存在的问题:
- 存在单一的全局 mutex(Sched.Lock)和集中状态管理:
- mutex 需要保护所有与 goroutine 相关的操作(创建、完成、重排等),导致锁竞争严重。
- Goroutine 传递的问题:todo
- goroutine(G)交接(G.nextg):工作者线程(M’s)之间会经常交接可运行的 goroutine。 而且可能会导致延迟增加和额外的开销。每个 M 必须能够执行任何可运行的 G,特别是刚刚创建 G 的 M。
- 每个 M 都需要做内存缓存(M.mcache):会导致资源消耗过大(每个 mcache 可以吸纳到 2M 的内存缓存和其他缓存),数据局部性差。
频繁的线程阻塞/解阻塞: 在存在 syscalls 的情况下,线程经常被阻塞和解阻塞。这增加了很多额外的性能开销。
为了解决 GM 模型的以上诸多问题,在 Go1.1 时,Dmitry Vyukov 在 GM 模型的基础上,新增了一个 P(Processor)组件。并且实现了 Work Stealing 算法来解决一些新产生的问题。
加了 P 之后会带来什么改变呢?
每个 P 有自己的本地队列,大幅度的减轻了对全局队列的直接依赖,所带来的效果就是锁竞争的减少。而 GM 模型的性能开销大头就是锁竞争。 每个 P 相对的平衡上,在 GMP 模型中也实现了Work Stealing 算法,如果 P 的本地队列为空,则会从全局队列或其他 P 的本地队列中窃取可运行的 G 来运行,减少空转,提高了资源利用率。
为什么要有P呢?
一般来讲,M 的数量都会多于 P。像在 Go 中,M 的数量默认是 10000,P 的默认数量的 CPU 核数。另外由于 M 的属性,也就是如果存在系统阻塞调用,阻塞了 M,又不够用的情况下,M 会不断增加。
M 不断增加的话,如果本地队列挂载在 M 上,那就意味着本地队列也会随之增加。这显然是不合理的,因为本地队列的管理会变得复杂,且 Work Stealing 性能会大幅度下降。
M 被系统调用阻塞后,我们是期望把他既有未执行的任务分配给其他继续运行的,而不是一阻塞就导致全部停止。
因此使用 M 是不合理的,那么引入新的组件 P,把本地队列关联到 P 上,就能很好的解决这个问题。
IO多路复用与Epoll原理、Socket连接中的应用? link
- 五种IO模型
- 同步阻塞IO(Blocking IO):即传统的IO模型。即用户需要等待read将socket中的数据读取到buffer后,才继续处理接收的数据。整个IO请求的过程中,用户线程是被阻塞的,这导致用户在发起IO请求时,不能做任何事情,对CPU的资源利用率不够。
- 同步非阻塞IO(Non-blocking IO):默认创建的socket都是阻塞的,非阻塞IO要求socket被设置为NONBLOCK。虽然用户线程每次发起IO请求后可以立即返回,但是为了等到数据,仍需要不断地轮询、重复请求,消耗了大量的CPU的资源。一般很少直接使用这种模型,而是在其他IO模型中使用非阻塞IO这一特性。
- IO多路复用(IO Multiplexing):即经典的Reactor设计模式,主要作用是可以避免同步非阻塞IO模型中轮询等待的问题,可达到在同一个线程内同时处理多个IO请求的目的。
- 信号驱动 I/O( signal driven IO):信号驱动IO在实际中并不常用。
- 异步IO(Asynchronous IO):即经典的Proactor设计模式,也称为异步非阻塞IO。
前四种IO都是同步IO。对于一次read IO访问,数据会先被拷贝到操作系统内核的缓冲区中,然后才会从操作系统内核的缓冲区拷贝到应用程序的地址空间。
同步和异步的主要区别在于谁负责拷贝数据:同步方式下由用户线程将数据拷贝到用户空间;异步方式下由内核负责将数据拷贝到用户空间,拷贝完成后会通知用户线程或者调用用户线程注册的回调函数进行后续处理。
阻塞和非阻塞的主要区别在于是否需要等待完成:阻塞和非阻塞主要是针对同步方式,阻塞是指IO操作需要彻底完成后才返回到用户空间;而非阻塞是指IO操作被调用后立即返回给用户一个状态值,无需等到IO操作彻底完成。
- Reactor设计模式
-
I/O多路复用(multiplexing)
- 本质是通过一种机制(系统内核缓冲I/O数据),让单个进程可以监视多个文件描述符,一旦某个描述符就绪(读就绪或写就绪),就通知程序进行相应的读写操作。
- select、poll和epoll都是Linux API提供的IO复用方式。注意select,poll,epoll本质上都是同步I/O,因为这些就绪的IO上的数据都由用户线程进行拷贝。
-
select函数
- select()的机制中提供一种fd_set的数据结构,实际上是一个long类型的数组,每一位代表一个对应的文件描述符,通过宏进行添加和删除。当调用select()时,由内核根据IO状态修改fd_set的内容,由此来返回那些就绪IO。
- 相比同步阻塞模型,select增加了添加监听文件描述符以及调用select函数的额外操作,还有返回后的遍历代价。其最大的优势是用户可以在一个线程内同时处理多个socket的IO请求。
-
poll函数
- poll的机制与select类似,与select在本质上没有多大差别,管理多个描述符也是进行轮询,根据描述符的状态进行处理,但是poll没有最大文件描述符数量的限制。
-
epoll函数
- epoll在Linux2.6内核正式提出,是基于事件驱动的I/O方式,相对于select来说,epoll没有描述符个数限制,使用一个文件描述符管理多个描述符,将用户关心的文件描述符的事件存放到内核的一个事件表中,这样在用户空间和内核空间只需copy一次。
- epoll机制的好处在于:分清了频繁调用和不频繁调用的操作。例如,epoll_ctrl是不太频繁调用的,而epoll_wait是非常频繁调用的。这时,epoll_wait却几乎没有入参,这比select的效率高出一大截,而且,它也不会随着并发连接的增加使得入参越发多起来,导致内核执行效率下降。
- epoll高效的一个原因在于ET机制的引入减少epoll_wait的调用,而poll相对select优势在于不用重复遍历设置监听文件描述符集合,而epoll相对poll和select的优势在于不用来回在内核和用户空间copy监听集合,能快速返回活跃IO集合。
- epoll的核心数据结构在于红黑树+双向链表。首先调用epoll_create时内核帮我们在epoll文件系统里建了个file结点;除此之外在内核cache里建立红黑树用于存储以后epoll_ctl传来的socket,当有新的socket连接来时,先遍历红黑书中有没有这个socket存在,如果有就立即返回,没有就插入红黑数,然后给内核中断处理程序注册一个钩子函数,每当有事件发生时就通过钩子函数把这些文件描述符放到用来存储就绪事件的链表中。epoll_wait并不监听文件句柄,而是等待就绪链表不空or收到信号or超时这三种条件后返回。epoll_wait返回时,会将就绪链表上的事件摘除,在LT模式下,这些就绪socke事件会再次被放回到刚刚清空的准备就绪链表,保证所有的事件都得到正确的处理。如果到timeout时间后链表中没有数据也立刻返回。
- 当监测的fd数目较小,或者fd数目多且各个fd都比较活跃,建议使用select或者poll;当监测的fd数目非常大,成千上万,且单位时间只有其中的一部分fd处于就绪状态,这个时候使用epoll能够明显提升性能,比如ngix web服务器就是使用epoll实现的。
-
应用场景
- 一个游戏服务器,tcpserver负责接收客户端的连接,dbserver负责处理数据信息,一个webserver负责处理服务器的web请求,gameserver负责游戏的逻辑处理,所有这些服务都和另外一个gateserver相连,gateserver负责服务器间的通信和转发(进程间通信),只要游戏服务器在服务状态,这些连接几乎不会断开(异常情况可能会断开),并且这些连接数量一般不会很多。
- 这种情况,gateserver是选择select还是epoll呢?很明显是select,因为每时每刻这些连接的socket都有事件发生(比如:服务期间的心跳信息,还有大型网络游戏的同步信息(一般每秒在20-30次)),最重要的是,这种场景下,并发量也不会很大。如果此时用epoll,为此所建立的文件系统,红黑书和链表对于此来说就是杀鸡用牛刀,效率反而不高。
- 但是这里的tcpserver负责大量的客户端的连接,毫无疑问epoll是首选,它接受大量的客户端连接,收到客户端的消息之后把消息转发发给select网络模型的gateserver,gateserver再转发给gameserver进行逻辑处理,最后返回给客户端就over了。
- 因此在如果在并发量低,socket都比较活跃的情况下,select就不见得比epoll慢了。
-
总结
- epoll建立红黑树和链表、调用回调函数都需要开销,适用于高并发而活跃连接较少的情况。select和poll的代价在于用户空间与内核态的数据拷贝和遍历处理,适用于连接量较少但其中大多数都比较活跃的情况。

- epoll建立红黑树和链表、调用回调函数都需要开销,适用于高并发而活跃连接较少的情况。select和poll的代价在于用户空间与内核态的数据拷贝和遍历处理,适用于连接量较少但其中大多数都比较活跃的情况。
Log包线程安全吗 link std
安全
其他包:std todo
常用测试工具,压测工具,方法(goconvey,vegeta) link
四个测试框架:
- GoConvey
- GoStub
- GoMock
- Monkey
todo
复杂的单元测试怎么测试,比如有外部接口mysql接口的情况
模拟接口调用方法,有明确的参数值与返回值,就是最简单的打桩。
桩,或称桩代码,是指用来代替关联代码或者未实现代码的代码。如果函数 B 用 B1 来代替,那么,B 称为原函数,B1 称为桩函数。打桩就是编写或生成桩代码。
HttpMock - 模拟 http 请求 - 官方自带的 http 包
SqlMock - 模拟数据库请求
互斥锁,读写锁,死锁问题是怎么解决,死锁产生条件,预防、避免、检测、解除死锁,剥夺资源、撤销进程)
编码细节
编码细节
- uint不能直接相减(结果是负数会变成一个很大的uint,这点对动态语言出身的会可能坑)
- channel一定记得close。
- goroutine记得return或者中断(不然容易造成goroutine占用大量CPU)
- 从slice创建slice的时候,注意原slice的操作可能导致底层数组变化。(如果你要创建一个很长的slice,尽量创建成一个slice里存引用,这样可以分批释放,避免gc在低配机器上stop the world)
go struct能不能比较
同一个struct的两个实例可比较也不可比较,当结构不包含不可直接比较成员变量时可直接比较,否则不可直接比较
基本数据类型哪些是可比较的,哪些是不可比较的:
- 可比较:Integer,Floating-point,String,Boolean,Complex(复数型),Pointer,Channel,Interface,Array
- 不可比较:Slice,Map,Function
但在平时的实践过程中,当我们需要对含有不可直接比较的数据类型的结构体实例进行比较时,是不是就没法比较了呢? 事实上并非如此,golang还是友好滴,我们可以借助 reflect.DeepEqual 函数 来对两个变量进行比较。 DeepEqual函数用来判断两个值是否深度一致。具体比较规则如下:
- 不同类型的值永远不会深度相等
- 当两个数组的元素对应深度相等时,两个数组深度相等
- 当两个相同结构体的所有字段对应深度相等的时候,两个结构体深度相等
- 当两个函数都为nil时,两个函数深度相等,其他情况不相等(相同函数也不相等)
- 当两个interface的真实值深度相等时,两个interface深度相等
- map的比较需要同时满足以下几个
- 两个map都为nil或者都不为nil,并且长度要相等
- 相同的map对象或者所有key要对应相同
- map对应的value也要深度相等
- 指针,满足以下其一即是深度相等
- 两个指针满足go的==操作符
- 两个指针指向的值是深度相等的
- 切片,需要同时满足以下几点才是深度相等
- 两个切片都为nil或者都不为nil,并且长度要相等
- 两个切片底层数据指向的第一个位置要相同或者底层的元素要深度相等
- 注意:空的切片跟nil切片是不深度相等的
- 其他类型的值(numbers, bools, strings, channels)如果满足go的==操作符,则是深度相等的。要注意不是所有的值都深度相等于自己,例如函数,以及嵌套包含这些值的结构体,数组等
client如何实现长连接?
todo
slice,len,cap,共享,扩容
todo
实现set?bitset? link
对于Set类型的数据结构,其实本质上跟List没什么多大的区别。无非是Set不能含有重复的Item的特性,Set有初始化、Add、Clear、Remove、Contains等操作。
在Java中很容易知道HashSet的底层实现是HashMap,核心就是用一个常量来填充Map键值对中的Value选项。除此之外,重点关注Go中Map的数据结构,Key是不允许重复的。
两种 go 实现 set 的思路, 分别是 map 和 bitset。
map 的 key 肯定是唯一的,而这恰好与 set 的特性一致,天然保证 set 中成员的唯一性。而且通过 map 实现 set,在检查是否存在某个元素时可直接使用 _, ok := m[key] 的语法,效率高。
set := make(map[string]bool) // New empty set
set["Foo"] = true            // Add
for k := range set {         // Loop
    fmt.Println(k)
}
delete(set, "Foo")    // Delete
size := len(set)      // Size
exists := set["Foo"]  // Membership
但是map 的 value 是布尔类型,这会导致 set 多占一定内存空间,而 set 不该有这个问题。
设置 value 为空结构体,在 Go 中,空结构体不占任何内存。当然,如果不确定,也可以来证明下这个结论。
unsafe.Sizeof(struct{}{}) // 结果为 0
优化后:
type void struct{}
var member void

set := make(map[string]void) // New empty set
set["Foo"] = member          // Add
for k := range set {         // Loop
    fmt.Println(k)
}
delete(set, "Foo")      // Delete
size := len(set)        // Size
_, exists := set["Foo"] // Membership
然后按照这个思路做封装,初始化,添加、包含、长度、清除(重新初始化)、set相等(遍历两个set的每个元素)、子集(遍历判断包含),过程如下:link
其实,github 上已经有个成熟的包,名为 golang-set,它也是采用这个思路实现的。访问地址 golang-set,描述中说 Docker 用的也是它。包中提供了两种 set 实现,线程安全的 set 和非线程安全的 set。
一个demo:
package main

import (
    "fmt"
    mapset "github.com/deckarep/golang-set"
)

func main() {
    // 默认创建的线程安全的,如果无需线程安全
    // 可以使用 NewThreadUnsafeSet 创建,使用方法都是一样的。
    s1 := mapset.NewSet(1, 2, 3, 4)
    fmt.Println("s1 contains 3: ", s1.Contains(3))
    fmt.Println("s1 contains 5: ", s1.Contains(5))
    fmt.Println("s1 length: ", s1.Cardinality()) // 基数(集合长度)

    // interface 参数,可以传递任意类型
    s1.Add("poloxue")
    fmt.Println("s1 contains poloxue: ", s1.Contains("poloxue"))
    s1.Remove(3)
    fmt.Println("s1 contains 3: ", s1.Contains(3))

    s2 := mapset.NewSet(1, 3, 4, 5)

    // 并集
    fmt.Println(s1.Union(s2))
}
- bitset
bitset 中每个数字用一个 bit 即能表示,对于一个 int8 的数字,我们可以用它表示 8 个数字,能帮助我们大大节省数据的存储空间。
bitset 最常见的应用有 bitmap 和 flag,即位图和标志位。这里,我们先尝试用它表示一些操作的标志位。比如某个场景,我们需要三个 flag 分别表示权限1、权限2和权限3,而且几个权限可以共存。我们可以分别用三个常量 F1、F2、F3 表示位 Mask。
示例:
type Bits uint8

const (
    F0 Bits = 1 << iota
    F1
    F2
)

func Set(b, flag Bits) Bits    { return b | flag }
func Clear(b, flag Bits) Bits  { return b &^ flag }
func Toggle(b, flag Bits) Bits { return b ^ flag }
func Has(b, flag Bits) bool    { return b&flag != 0 }

func main() {
    var b Bits
    b = Set(b, F0)
    b = Toggle(b, F2)
    for i, flag := range []Bits{F0, F1, F2} {
        fmt.Println(i, Has(b, flag))
    }
}
例子中,我们本来需要三个数才能表示这三个标志,但现在通过一个 uint8 就可以。bitset 的一些操作,如设置 Set、清除 Clear、切换 Toggle、检查 Has 通过位运算就可以实现,而且非常高效。 bitset 对集合操作有着天然的优势,直接通过位运算符便可实现。比如交集、并集、和差集,示例如下:
交集:a & b 并集:a | b 差集:a & (~b)
底层的语言、库、框架常会使用这种方式设置标志位。
bitset 包也有人实现了,github地址 yourbasic/bit
举例:
package main

import (
    "fmt"
    "github.com/yourbasic/bit"
)

func main() {
    s := bit.New(2, 3, 4, 65, 128)
    fmt.Println("s contains 65", s.Contains(65))
    fmt.Println("s contains 15", s.Contains(15))

    s.Add(15)
    fmt.Println("s contains 15", s.Contains(15))

    fmt.Println("next 20 is ", s.Next(20))
    fmt.Println("prev 20 is ", s.Prev(20))

    s2 := bit.New(10, 22, 30)

    s3 := s.Or(s2)
    fmt.Println("next 20 is ", s3.Next(20))

    s3.Visit(func(n int) bool {
        fmt.Println(n)
        return false  // 返回 true 表示终止遍历
    })
}
bitset 和前面的 set 的区别:
bitset 的成员只能是 int 整型,没有 set 灵活。平时的使用场景也比较少,主要用在对效率和存储空间要求较高的场景。
实现消息队列(多生产者,多消费者) link
- 通过channel实现生产者消费者模型
- 生产者消费者模型主要用到了channel的以下特性:任意时刻只能有一个协程能够对channel中某一个item进行访问。
- 单生产者单消费者模型
- 把生产者和消费者都放到一个无限循环中,这个和我们的服务器端的任务处理非常相似。生产者不断的向channel中放入数据,而消费者不断的从channel中取出数据,并对数据进行处理(打印)。由于生产者的协程不会退出,所以channel的写入会永久存在,这样当channel中没有放入数据时,消费者端将会阻塞,等待生产者端放入数据。
- 多生产者消费者模型
- 可以利用channel在某个时间点只能有一个协程能够访问其中的某一个数据,的特性来实现生产者消费者模型。由于channel具有这样的特性,我们在放数据和消费数据时可以不需要加锁。
- 问题:
- 当消费者的速度小于生产者时,channel就有可能产生拥塞,导致占用内存增加,所以,在实际场景中需要考虑channel的缓冲区的大小。设置了channel的大小,当生产的数据大于channel的容量时,生产者将会阻塞,这些问题都是要在实际场景中需要考虑的。
- 一个解决办法就是使用一个固定的数组或切片作为环形缓冲区,而非channel,通过Sync包的机制来进行同步,实现生产者消费者模型,这样可以避免由于channel满而导致消费者端阻塞。但,对于环形缓冲区而言,可能会覆盖老的数据,同样需要考虑具体的使用场景。
golang分布式与微服务
概念与理解
微服务是什么?特点、优缺点
传统的单体应用程序将所有的功能都封装在一个单元中。相反,在微服务架构中,应用程序被划分为可以单独部署、升级和替换的小型独立服务。每个微服务都是针对单个业务目的而构建的,它使用轻量级机制与其他微服务通信。
微服务架构是一种构建系统的方式,其中,几个独立的服务按定义好的方式彼此通信(通常通过 Web RESTful 服务)。关键在于每个微服务都可以独立更新和部署。
采用微服务的主要风险,尤其是当起步于一个单体应用时,是设计的服务不是真正独立的。这将增加服务间通信的开销和复杂性。
从一开始就使用微服务架构可能存在风险,因为它主要适用于大型系统和大型团队。
亚马逊的“双披萨团队”原则。该原则规定,如果一个负责微服务的团队两个披萨都不够吃,那么这个团队就太大了。
微服务允许你使用不同的技术,因为在理想情况下,每个微服务都由一个独立的团队处理。
简单来说微服务架构是:
采用一组服务的方式来构建一个应用,服务独立部署在不同的进程中,不同服务通过一些轻量级交互机制来通信,例如 RPC、HTTP 等,服务可独立扩展伸缩,每个服务定义了明确的边界,不同的服务甚至可以采用不同的编程语言来实现,由独立的团队来维护。
微服务架构设计包括:
- 服务熔断降级限流机制 熔断降级的概念(Rate Limiter 限流器,Circuit breaker 断路器).
- 框架调用方式解耦方式 Kit 或 Istio 或 Micro 服务发现(consul zookeeper kubeneters etcd ) RPC调用框架.
- 链路监控,zipkin和prometheus.
- 多级缓存.
- 网关 (kong gateway).
- Docker部署管理 Kubenetters.
- 自动集成部署 CI/CD 实践.
- 自动扩容机制规则.
- 压测 优化.
- Trasport 数据传输(序列化和反序列化).
- Logging 日志.
- Metrics 指针对每个请求信息的仪表盘化.
具体架构,参考:pdf
设计微服务的最佳实践是什么 link
当从单体应用正确的迁移到微服务架构的时候,可以获得以下收益:
- 你可以根据自己的意愿选择一门语言开发微服务,按照自己的节奏独立发布它,并独立扩展。
- 组织中的不同团队可以独立的拥有自己特定的微服务,并且随着并行开发以及重用的增加,产品发布的时间会更快。
- 可以更好的隔离故障,因为发生在特定微服务中的错误会在对应的服务中被处理掉,因此不会影响到生态系统中的其他服务。
- 单一责任原则
举例:你正在构建用于订购披萨的微服务。你可以基于功能构建下面这些组件,诸如InventoryService,OrderService,PaymentService,UserProfileService,DeliveryNotificationService等。InventoryService仅仅有获取或更新披萨种类或配料库存相关的API,同样的,其他也只会提供对应功能的API。
- 独立的数据存储
如果你的所有微服务都共享一个数据库,这就违背了使用微服务的目的。对这个数据库的任何的改变或者故障都会影响使用该数据库的所有微服务。
理想情况下,任何需要访问该数据的其他微服务只能通过拥有写权限的微服务提供的API来访问。
- 使用异步通信实现松散耦合
为了避免构建出一个紧密耦合的组件网格(Mesh),可以考虑在微服务之间使用异步通信。
a. 对依赖的服务异步调用,如下例子。
例如:有一个服务A依赖服务B的例子。当服务B返回响应消息,服务A再返回成功给调用服务A的调用者。如果调用者对服务B的内容不关心,那么服务A可以异步调用服务B,并且这个时候可以立即返回成功给调用者。
b. 一个更好的选择是在微服务通信之间使用事件机制。你的微服务可以发布一个事件消息到消息总线上,可以用来通知一个状态的改变或者一个失败事件,并且任何对该事件感兴趣的微服务都可以获得该消息然后做出相应的处理。
例如:上面提到的披萨订单系统中,当客户的订单被接收到或者订单已经完成以及运输的状态消息都可以使用异步通信给客户发送通知消息。通知服务可以监听订单提交的消息事件然后将相应的通知推送给客户。
- 使用熔断器快速实现故障容错
如果你的微服务依赖于另一个系统来提供响应,并且该系统需要很长时间才会响应,那么你的总体响应SLA将会受到影响。为了避免这种场景并且快速做出响应,你需要遵循的一个简单的微服务最佳实践是使用熔断器来使外部的调用超时,然后返回一个默认响应或者错误。熔断器模式可以参考最下面的引用。这种方式可以隔离故障服务,而不会导致级联故障,可以让你的服务保持在健康的状态。你可以选择使用流行的产品,比如Netflix开发的Hystrix。这要比使用HTTP CONNECT_TIMEOUT和READ_TIMEOUT设置更好,因为它不会启动超出配置范围的其他线程。
- 通过API网关代理微服务请求
相比于系统中的每个微服务都单独提供API授权,请求/响应日志以及限流功能,使用一个单独API网关做这些事情会更有价值。调用你微服务的客户端可以连接到API网关而不是直接调用微服务接口。这种方式可以让你的微服务避免做那些额外的调用,并且微服务内部URL可以被隐藏,这可以让你更灵活的从API网关重定向流量到一个微服务的更新版本。当允许第三方访问你的微服务时,那么更有必要使用这种方式,因为你可以在请求到达微服务之前对传入流量进行限流以及拒绝来自API网关的未授权请求。你也可以选择一个单独的外部网关,让它可以接收外部网络的流量。
- 确保API变更向后兼容
你可以安全的对API进行变更并且快速的发布它们,只要这些改变不影响已有的调用者。一种可能的选项是通知你的调用者,让他们通过集成测试来对做出的变更进行验证。但是,这种代价会比较高,因为所有依赖项都需要在一个环境中排队,这会使你的协调工作变慢。一个更好的选项是对你的API使用合约测试。你的API消费者对API提供预期响应结果的合约。作为API提供者的你可以集成这些合约测试作为你构建的一部分并且这些可以安全的保证重大的API变更。消费者可以测试你发布的存根(stubs)作为他们构建的一部分。这种方式可以让你通过独立测试合约变更来更快速的发布产品。
- 版本化微服务重大变更
不可能让变更总是保持向后兼容。当你做了一个重大的变更的时候,同时需要继续支持老的接口,这时候可以暴露一个新版本的接口。消费者可以在方便的时候选择新的版本。但是有太多版本的API对于维护相应的代码人来说会是一场噩梦。因此,有一种规范的方法是通过和客户端一起协作或在内部将流量重新路由到较新的版本,从而弃用较旧的版本。
- 使用专用基础设施托管微服务
将你的微服务基础设施与其他组件隔离可以实现故障隔离和最佳性能。隔离微服务依赖的组件基础设施也同样重要。
例如:上面披萨订单的案例中,库存微服务使用库存数据库。使用专用的托管机器不仅对于库存微服务很重要,而且对于库存数据库同样也很重要。
- 创建独立的发布通道
你的微服务需要有一个单独的发布通道,这个通道不和你所在组织中的其他组件关联。这样的话你就不会和别人有冲突以及浪费和多个团队协调的时间。
- 建立组织效率
尽管微服务给你提供了独立开发和发布的自由,但是对于跨领域关注(cross cutting concerns)来说,某些标准还是需要遵循的,这样才不会让每个团队都花费时间为这些问题创建独特的解决方案。这在诸如微服务分布式架构中是非常重要的,在这种架构中,你需要能够连接难题(puzzle)中的所有部分才能看清全局。因此,对于API安全,日志聚合,监控,API文档,秘钥管理,配置管理,分布式追踪等,企业级解决方案是必须要有的。
微服务架构如何运作? link
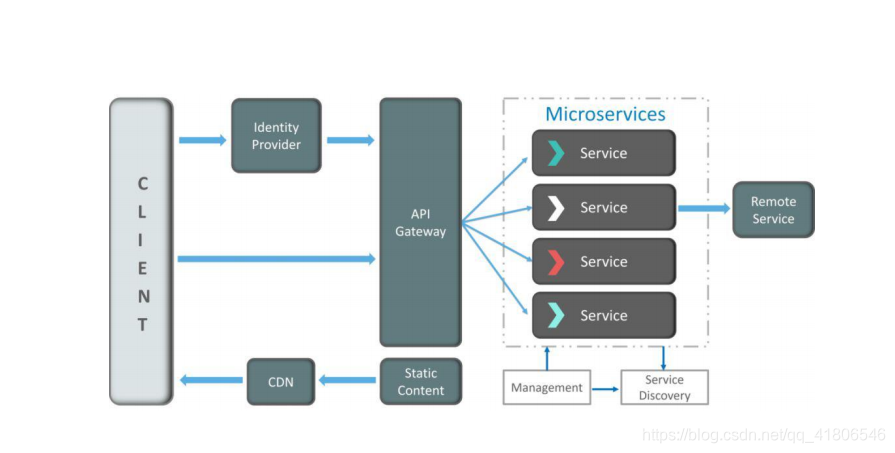
- 客户端 – 来自不同设备的不同用户发送请求。
- 身份提供商 – 验证用户或客户身份并颁发安全令牌。
- API 网关 – 处理客户端请求。
- 静态内容 – 容纳系统的所有内容。
- 管理 – 在节点上平衡服务并识别故障。
- 服务发现 – 查找微服务之间通信路径的指南。
- 内容交付网络 – 代理服务器及其数据中心的分布式网络。
- 远程服务 – 启用驻留在 IT 设备网络上的远程访问信息。
什么是REST / RESTful以及它的用途是什么 link
- REST全称是Representational State Transfer,中文意思是表述(编者注:通常译为表征)性状态转移。如果一个架构符合REST的约束条件和原则,我们就称它为RESTful架构。
- REST本身并没有创造新的技术、组件或服务,而隐藏在RESTful背后的理念就是使用Web的现有特征和能力, 更好地使用现有Web标准中的一些准则和约束。虽然REST本身受Web技术的影响很深, 但是理论上REST架构风格并不是绑定在HTTP上,只不过目前HTTP是唯一与REST相关的实例。 所以我们这里描述的REST也是通过HTTP实现的REST。
- REST全称是表述性状态转移,那究竟指的是什么的表述? 其实指的就是资源。要让一个资源可以被识别,需要有个唯一标识,在Web中这个唯一标识就是URI(Uniform Resource Identifier)。
- RESTful架构应该遵循统一接口原则,统一接口包含了一组受限的预定义的操作,不论什么样的资源,都是通过使用相同的接口进行资源的访问。接口应该使用标准的HTTP方法如GET,PUT和POST,并遵循这些方法的语义。
- 如果按照HTTP方法的语义来暴露资源,那么接口将会拥有安全性和幂等性的特性,目的是为了安全和重试。例如GET和HEAD请求都是安全的, 无论请求多少次,都不会改变服务器状态。而GET、HEAD、PUT和DELETE请求都是幂等的,无论对资源操作多少次, 结果总是一样的,后面的请求并不会产生比第一次更多的影响。
- 下面列出了GET,DELETE,PUT和POST的典型用法:
GET
安全且幂等
获取表示
变更时获取表示(缓存)
200(OK) - 表示已在响应中发出
204(无内容) - 资源有空表示
301(Moved Permanently) - 资源的URI已被更新
303(See Other) - 其他(如,负载均衡)
304(not modified)- 资源未更改(缓存)
400 (bad request)- 指代坏请求(如,参数错误)
404 (not found)- 资源不存在
406 (not acceptable)- 服务端不支持所需表示
500 (internal server error)- 通用错误响应
503 (Service Unavailable)- 服务端当前无法处理请求

POST
不安全且不幂等
使用服务端管理的(自动产生)的实例号创建资源
创建子资源
部分更新资源
如果没有被修改,则不过更新资源(乐观锁)
200(OK)- 如果现有资源已被更改
201(created)- 如果新资源被创建
202(accepted)- 已接受处理请求但尚未完成(异步处理)
301(Moved Permanently)- 资源的URI被更新
303(See Other)- 其他(如,负载均衡)
400(bad request)- 指代坏请求
404 (not found)- 资源不存在
406 (not acceptable)- 服务端不支持所需表示
409 (conflict)- 通用冲突
412 (Precondition Failed)- 前置条件失败(如执行条件更新时的冲突)
415 (unsupported media type)- 接受到的表示不受支持
500 (internal server error)- 通用错误响应
503 (Service Unavailable)- 服务当前无法处理请求

PUT
不安全但幂等
用客户端管理的实例号创建一个资源
通过替换的方式更新资源
如果未被修改,则更新资源(乐观锁)
200 (OK)- 如果已存在资源被更改
201 (created)- 如果新资源被创建
301(Moved Permanently)- 资源的URI已更改
303 (See Other)- 其他(如,负载均衡)
400 (bad request)- 指代坏请求
404 (not found)- 资源不存在
406 (not acceptable)- 服务端不支持所需表示
409 (conflict)- 通用冲突
412 (Precondition Failed)- 前置条件失败(如执行条件更新时的冲突)
415 (unsupported media type)- 接受到的表示不受支持
500 (internal server error)- 通用错误响应
503 (Service Unavailable)- 服务当前无法处理请求

DELETE
不安全但幂等
删除资源
200 (OK)- 资源已被删除
301 (Moved Permanently)- 资源的URI已更改
303 (See Other)- 其他,如负载均衡
400 (bad request)- 指代坏请求
404 (not found)- 资源不存在
409 (conflict)- 通用冲突
500 (internal server error)- 通用错误响应
503 (Service Unavailable)- 服务端当前无法处理请求
实践中常见的问题:
-
POST和PUT用于创建资源时有什么区别?
- 大多数情况下,人们会直接把POST、GET、PUT、DELETE直接对应上CRUD,但是实际上二者有如下区别。
- 所创建的资源的名称(URI)是否由客户端决定。 POST使用服务端管理的(自动产生)的实例号创建资源,PUT用客户端管理的实例号创建一个资源。
- POST不幂等,PUT幂等
- POST用于创建资源,也可以部分更新资源。PUT通过替换的方式更新资源
- 客户端不一定都支持这些HTTP方法吧?
- 的确有这种情况,特别是一些比较古老的基于浏览器的客户端,只能支持GET和POST两种方法。
- 在实践上,客户端和服务端都可能需要做一些妥协。例如rails框架就支持通过隐藏参数_method=DELETE来传递真实的请求方法, 而像Backbone这样的客户端MVC框架则允许传递_method传输和设置X-HTTP-Method-Override头来规避这个问题。
-
统一资源接口对URI有什么指导意义?
- 统一资源接口要求使用标准的HTTP方法对资源进行操作,所以URI只应该来表示资源的名称,而不应该包括资源的操作。
- 通俗来说,URI不应该使用动作来描述。例如,下面是一些不符合统一接口要求的URI:
- GET /getUser/1
- POST /createUser
- PUT /updateUser/1
- DELETE /deleteUser/1
-
直接忽视缓存可取吗?
- 即使你按各个动词的原本意图来使用它们,你仍可以轻易禁止缓存机制。 最简单的做法就是在你的HTTP响应里增加这样一个报头: Cache-control: no-cache。 但是,同时你也对失去了高效的缓存与再验证的支持(使用Etag等机制)。
- 对于客户端来说,在为一个REST式服务实现程序客户端时,也应该充分利用现有的缓存机制,以免每次都重新获取表示。
-
响应代码的处理有必要吗?
- HTTP的响应代码可用于应付不同场合,正确使用这些状态代码意味着客户端与服务器可以在一个具备较丰富语义的层次上进行沟通。
- 例如,201(”Created”)响应代码表明已经创建了一个新的资源,其URI在Location响应报头里。
- 假如你不利用HTTP状态代码丰富的应用语义,那么你将错失提高重用性、增强互操作性和提升松耦合性的机会。
-
客户端如何知道服务端提供哪种表述形式呢?
- 可以通过HTTP内容协商,客户端可以通过Accept头请求一种特定格式的表述,服务端则通过Content-Type告诉客户端资源的表述形式。
-
在URI里边带上版本号
- http://api.example.com/1.0/foo
- 如果我们把版本号理解成资源的不同表述形式的话,就应该只是用一个URL,并通过Accept头部来区分
- 当服务器不支持所请求的表述格式,那么应该怎么办?
若服务器不支持,它应该返回一个HTTP 406响应,表示拒绝处理该请求。
- 应用状态与资源状态
实际上,状态应该区分应用状态和资源状态,客户端负责维护应用状态,而服务端维护资源状态。
客户端与服务端的交互必须是无状态的,并在每一次请求中包含处理该请求所需的一切信息。
服务端不需要在请求间保留应用状态,只有在接受到实际请求的时候,服务端才会关注应用状态。
这种无状态通信原则,使得服务端和中介能够理解独立的请求和响应。
在多次请求中,同一客户端也不再需要依赖于同一服务器,方便实现高可扩展和高可用性的服务端。
但有时候我们会做出违反无状态通信原则的设计,例如利用Cookie跟踪某个服务端会话状态,常见的像J2EE里边的JSESSIONID。
这意味着,浏览器随各次请求发出去的Cookie是被用于构建会话状态的。
当然,如果Cookie保存的是一些服务器不依赖于会话状态即可验证的信息(比如认证令牌),这样的Cookie也是符合REST原则的。
什么是不同类型的微服务测试?
在使用微服务时,由于有多个微服务协同工作,测试变得非常复杂。因此,测试分为不同的级别。
- 在底层,我们有面向技术的测试,如单元测试和性能测试。这些是完全自动化的。
- 在中间层面,我们进行了诸如压力测试和可用性测试之类的探索性测试。
- 在顶层, 我们的验收测试数量很少。这些验收测试有助于利益相关者理解和验证软件功能。
什么是领域驱动(DDD)设计?为什么需要?什么是有界上下文? link
说到DDD(Domain-driven design 领域驱动设计),绕不开MVC,在MVC三层架构中,我们进行功能开发的之前,拿到需求,解读需求。往往最先做的一步就是先设计表结构,在逐层设计上层dao,service,controller。对于产品或者用户的需求都做了一层自我理解的转化。
用户需求在被提出之后经过这么多层的转化后,特别是研发需求在数据库结构这一层转化后,将业务以主观臆断行为进行了转化。一旦业务边界划分模糊,考虑不全,大量的逻辑补充堆积到了代码层实现,变得越来越难维护。
DDD的特点:
- 消除信息不对称
- 常规MVC三层架构中自底向上的设计方式做一个反转,以业务为主导,自顶向下的进行业务领域划分
- 将大的业务需求进行拆分,分而治之
举个栗子: 以电商订单场景为例。假如我们现在要做一个电商订单下单的需求。涉及到用户选定商品,下订单,支付订单,对用户下单时的订单发货。 MVC架构里面,我们常见的做法是在分析好业务需求之后,就开始设计表结构了,订单表,支付表,商品表等等。然后编写业务逻辑。这是第一个版本的需求,功能迭代了,订单支付后我可以取消,下单的商品我们退换货,是不是又需要进行加表,紧跟着对于的实现逻辑也进行修改。功能不断迭代,代码就不断的层层往上叠。 DDD架构里面,我们先进行划分业务边界。这里面核心是订单。那么订单就是这个业务领域里面的聚合逻辑体现。支付,商品信息,地址等等都是围绕着订单实体。订单本身的属性决定之后,类似于地址只是一个属性的体现。当你将订单的领域模型构建好之后,后续的逻辑边界与仓储设计也就可以在此基础上设计了。
- DDD基础
- DDD划分不同的层级,最里层是值、属性、唯一标识等,这个是最基本的数据单位,但不能直接使用。
- 然后是实体,这个把基础的数据进行封装,可以直接使用,在代码中就是封装好的一个个实体对象。
- 之后就是领域层,它按照业务划分为不同的领域,比如订单领域、商品领域、支付领域等。
- 最后是应用服务,它对业务逻辑进行编排,也可以理解为业务层。
通用语言:就是能够简单、清晰、准确描述业务涵义和规则的语言。
限界上下文:用来封装通用语言和领域对象,提供上下文环境,保证在领域之内的一些术语、业务相关对象等(通用语言)有一个确切的含义,没有二义性。
其他:todo
什么是双因素身份验证,双因素身份验证的凭据类型有哪些
双因素身份验证为帐户登录过程启用第二级身份验证。假设用户必须只输入用户名和密码,那么这被认为是单因素身份验证。

什么是幂等(Idempotence)以及它在哪里使用
幂等性是能够以这样的方式做两次事情的特性,即最终结果将保持不变,即好像它只做了一次。
用法:在远程服务或数据源中使用 Idempotence,这样当它多次接收指令时,它只处理指令一次。
加入api put超时,需要重试,就需要保证api幂等
什么是OAuth wikipedia OAuth2.0腾讯开放文档
OAuth: OAuth(开放授权)是一个开放标准,允许用户授权第三方应用访问他们存储在另外的服务提供者上的信息,而不需要将用户名和密码提供给第三方移动应用或分享他们数据的所有内容。
wikipedia对OAuth的解释:OAuth允许用户提供一个令牌,而不是用户名和密码来访问他们存放在特定服务提供者的数据。每一个令牌授权一个特定的网站(例如,视频编辑网站)在特定的时段(例如,接下来的2小时内)内访问特定的资源(例如仅仅是某一相册中的视频)。这样,OAuth让用户可以授权第三方网站访问他们存储在另外服务提供者的某些特定信息,而非所有内容。
QQ登录OAuth2.0总体处理流程如下:
- 接入申请,获取appid和apikey;
- 放置QQ登录按钮;
- 通过用户登录验证和授权,获取Access Token;
- 通过Access Token获取用户的OpenID;
- 调用OpenAPI,来请求访问或修改用户授权的资源。
todo:设计OAuth api
什么是端到端微服务测试
每个阶段的测试过程涉及面不同。端到端测试指客户端到服务端,只是不包括UI测试的完整测试。

Docker的目的是什么?容器Container在微服务中的用途是什么
容器是管理基于微服务的应用程序以便单独开发和部署它们的好方法。您可以将微服务封装在容器映像及其依赖项中,然后可以使用它来运行按需实例的微服务,而无需任何额外的工作。
您对微服务架构中的语义监控有何了解?有什么微服务监控工具?prometheus 高可用
语义监控,也称为 综合监控,将自动化测试与监控应用程序相结合,以检测业务失败因素。
Prometheus是由SoundCloud开发的开源监控报警系统和时间序列数据库(TSDB)。Prometheus使用Go语言开发,是Google BorgMon监控系统的开源版本。
特点
- 多维度数据模型。
- 灵活的查询语言。
- 不依赖分布式存储,单个服务器节点是自主的。
- 通过基于HTTP的pull方式采集时序数据。
- 可以通过中间网关进行时序列数据推送。
- 通过服务发现或者静态配置来发现目标服务对象。
- 支持多种多样的图表和界面展示,比如Grafana等。
基本原理
- 通过HTTP协议周期性抓取被监控组件的状态,任意组件只要提供对应的HTTP接口就可以接入监控。不需要任何SDK或者其他的集成过程。
- 这样做非常适合做虚拟化环境监控系统,比如VM、Docker、Kubernetes等。输出被监控组件信息的HTTP接口被叫做exporter 。目前互联网公司常用的组件大部分都有exporter可以直接使用,比如Varnish、Haproxy、Nginx、MySQL、Linux系统信息(包括磁盘、内存、CPU、网络等等)。
服务过程
- Prometheus Daemon负责定时去目标上抓取metrics(指标)数据,每个抓取目标需要暴露一个http服务的接口给它定时抓取。
- Prometheus支持通过配置文件、文本文件、Zookeeper、Consul、DNS SRV Lookup等方式指定抓取目标.
- Prometheus采用PULL的方式进行监控,即服务器可以直接通过目标PULL数据或者间接地通过中间网关来Push数据。
- Prometheus在本地存储抓取的所有数据,并通过一定规则进行清理和整理数据,并把得到的结果存储到新的时间序列中。
- Prometheus通过PromQL和其他API可视化地展示收集的数据。Prometheus支持很多方式的图表可视化,例如Grafana、自带的Promdash以及自身提供的模版引擎等等。Prometheus还提供HTTP API的查询方式,自定义所需要的输出。
- PushGateway支持Client主动推送metrics到PushGateway,而Prometheus只是定时去Gateway上抓取数据。
- Alertmanager是独立于Prometheus的一个组件,可以支持Prometheus的查询语句,提供十分灵活的报警方式。
Grafana
- Grafana是用于可视化大型测量数据的开源程序,它提供了强大和优雅的方式去创建、共享、浏览数据。
- Dashboard中显示了你不同metric数据源中的数据。
- Grafana最常用于因特网基础设施和应用分析,但在其他领域也有用到,比如:工业传感器、家庭自动化、过程控制等等。
- Grafana支持热插拔控制面板和可扩展的数据源,目前已经支持Graphite、InfluxDB、OpenTSDB、Elasticsearch、Prometheus等。 todo
测试非确定性因素有哪些
非确定性测试(NDT)基本上是不可靠的测试。所以,有时可能会发生它们通过,显然有时它们也可能会失败。当它们失败时,它们会重新运行通过。
从测试中删除非确定性的一些方法如下:
- 隔离
- 异步
- 远程服务
- 隔离
- 时间
- 资源泄漏
todo
单元测试中Mock或Stub有什么区别?基准测试呢? 单元测试
平时开发的业务代码,单个函数往往不是独立的,它需要依赖于其他模块、第三方库、数据库、消息交互的结果等等。
但是单元测试一般不允许有任何外部依赖(文件依赖,网络依赖,数据库依赖等),我们不会在测试代码中去连接数据库,调用api等。这些外部依赖在执行测试的时候需要被模拟(mock/stub)。在测试的时候,我们使用模拟的对象来模拟真实依赖下的各种行为。所以在做单元测试的时候,我们只需要让这些被依赖的其他函数返回我们期望的数据,就可以继续测试我们当前需要测试的函数。
区别:
- Mock:是模拟的意思,指的是在测试包中创建一个结构体,满足某个外部依赖的接口 interface{}。
- Stub: 是桩的意思,指的是在测试包中创建一个模拟方法,用于替换生成代码中的方法。
Mock示例
生产代码
//auth.go
//假设我们有一个依赖http请求的鉴权接口
type AuthService interface{
    Login(username string,password string) (token string,e error)
    Logout(token string) error
}
Mock代码
//auth_test.go
type authService struct {}
func (auth *authService) Login (username string,password string) (string,error){
    return "token", nil
}
func (auth *authService) Logout(token string) error{
    return nil
}
在这里我们用 authService实现了 AuthService接口,这样测试 Login,Logout就不再需需要依赖网络请求了。而且我们也可以模拟一些错误的情况进行测试:
//auth_test.go
//模拟登录失败
type authLoginErr struct {
	auth AuthService  //可以使用组合的特性,Logout方法我们不关心,只用“覆盖”Login方法即可
}
func (auth *authLoginErr) Login (username string,password string) (string,error) {
	return "", errors.New("用户名密码错误")
}

//模拟api服务器宕机
type authUnavailableErr struct {
}
func (auth *authUnavailableErr) Login (username string,password string) (string,error) {
	return "", errors.New("api服务不可用")
}
func (auth *authUnavailableErr) Logout(token string) error{
	return errors.New("api服务不可用")
}
Stub示例
Stub:在测试包中创建一个模拟方法,用于替换生成代码中的方法。
生成代码
//storage.go
//发送邮件
var notifyUser = func(username, msg string) { //<--将发送邮件的方法变成一个全局变量
    auth := smtp.PlainAuth("", sender, password, hostname)
    err := smtp.SendMail(hostname+":587", auth, sender,
        []string{username}, []byte(msg))
    if err != nil {
        log.Printf("smtp.SendEmail(%s) failed: %s", username, err)
    }
}
//检查quota,quota不足将发邮件
func CheckQuota(username string) {
    used := bytesInUse(username)
    const quota = 1000000000 // 1GB
    percent := 100 * used / quota
    if percent < 90 {
        return // OK
    }
    msg := fmt.Sprintf(template, used, percent)
    notifyUser(username, msg) //<---发邮件
}
//storage_test.go
func TestCheckQuotaNotifiesUser(t *testing.T) {
    var notifiedUser, notifiedMsg string
    notifyUser = func(user, msg string) {  //<-看这里就够了,在测试中,覆盖了发送邮件的全局变量
        notifiedUser, notifiedMsg = user, msg
    }

    // ...simulate a 980MB-used condition...

    const user = "joe@example.org"
    CheckQuota(user)
    if notifiedUser == "" && notifiedMsg == "" {
        t.Fatalf("notifyUser not called")
    }
    if notifiedUser != user {
        t.Errorf("wrong user (%s) notified, want %s",
            notifiedUser, user)
    }
    const wantSubstring = "98% of your quota"
    if !strings.Contains(notifiedMsg, wantSubstring) {
        t.Errorf("unexpected notification message <<%s>>, "+
            "want substring %q", notifiedMsg, wantSubstring)
    }
}
在Go中,如果要用stub,那将是侵入式的,必须将生产代码设计成可以用stub方法替换的形式。
上述例子体现出来的结果就是:为了测试,专门用一个全局变量 notifyUser来保存了具有外部依赖的方法。然而在不提倡使用全局变量的Go语言当中,这显然是不合适的。所以,并不提倡这种Stub方式。
mock+stub:todo
什么是持续集成(CI) link
持续集成(CI)是每次团队成员提交版本控制更改时自动构建和测试代码的过程。这鼓励开发人员通过在每个小任务完成后将更改合并到共享版本控制存储库来共享代码和单元测试。
todo
架构师在微服务架构中的角色是什么
- 决定整个软件系统的布局。
- 帮助确定组件的分区。因此,他们确保组件相互粘合,但不紧密耦合。
- 与开发人员共同编写代码,了解日常生活中面临的挑战。
- 为开发微服务的团队提供某些工具和技术的建议。
- 提供技术治理,以便技术开发团队遵循微服务原则。
我们可以用微服务创建状态机吗
我们知道拥有自己的数据库的每个微服务都是一个可独立部署的程序单元,这反过来又让我们可以创建一个状态机。因此,我们可以为特定的微服务指定不同的状态和事件。
例如,我们可以定义Order微服务。订单可以具有不同的状态。Order状态的转换可以是Order微服务中的独立事件。
什么是微服务中的反应性扩展
Reactive Extensions也称为Rx。这是一种设计方法,我们通过调用多个服务来收集结果,然后编译组合响应。这些调用可以是同步或异步,阻塞或非阻塞。Rx是分布式系统中非常流行的工具,与传统流程相反。
grpc使用什么作为传输协议? microsoft
什么是 gRPC? gRPC 是一种新式的高性能框架,它发展了基于 RPC (远程) 调用。 在应用程序级别,gRPC 简化了客户端和后端服务之间的消息传递。
典型的 gRPC 客户端应用将公开实现业务操作的本地进程内函数。 在此之下,该本地函数在远程计算机上调用另一个函数。 似乎是本地调用实质上成为对远程服务的透明进程外调用。 RPC 管道提取计算机之间的点到点网络通信、序列化和执行。
在云原生应用程序中,开发人员通常跨编程语言、框架和技术工作。 这种 互操作性 使消息协定和跨平台通信所需的管道变得复杂。 gRPC 提供”统一的水平层”来抽象这些问题。 开发人员在本机平台中编写代码,专注于业务功能,而 gRPC 处理通信管道。
gRPC 使用 HTTP/2 作为传输协议。 虽然与 HTTP 1.1 兼容,但 HTTP/2 具有许多高级功能:
- 用于数据传输的二进制帧协议 - 与 HTTP 1.1 不同,HTTP 1.1 是基于文本的。
- 支持对通过同一连接发送多个并行请求的多路复用,可实现并行 - HTTP 1.1 将处理限制为一次处理一个请求/响应消息。(可展开比较http1.1串行长连接与http2多路复用)
- 双向全双工通信,用于同时发送客户端请求和服务器响应。
- 内置流式处理,支持对大型数据集进行异步流式处理的请求和响应。
- 减少网络使用率的标头压缩。
gRPC 轻量且性能高。 它可以比 JSON 序列化快 8 倍,消息小 60-80%。
gRPC 采用名为协议缓冲区 的开放源代码技术。 它们提供高度高效且与平台无关的序列化格式,用于序列化服务相互发送的结构化消息。 开发人员使用跨平台接口定义语言 (IDL) **为每个微服务定义服务协定。 作为基于文本的文件实现的协定描述了每个服务 .proto 的方法、输入和输出。 **同一proto文件可用于基于不同开发平台构建的 gRPC 客户端和服务。
Protobuf 编译器使用 proto 文件为目标平台生成客户端 protoc 和服务代码。 该代码包括以下组件:
- 由客户端和服务共享的强类型对象,表示消息的服务操作和数据元素。
- 具有远程 gRPC 服务可以继承和扩展的所需网络管道的强类型基类。
- 一个客户端存根,其中包含调用远程 gRPC 服务所需的管道。 运行时,每条消息都序列化为标准 Protobuf 表示形式,在客户端和远程服务之间交换。 与 JSON 或 XML 不同,Protobuf 消息被序列化为编译的二进制字节。
对于以下情况,倾向于使用 gRPC:
- 需要立即响应才能继续处理的同步后端微服务到微服务通信。
- 需要支持混合编程平台的 Polyglot 环境。
- 性能至关重要的低延迟和高吞吐量通信。
- 点到点实时通信 - gRPC 无需轮询即可实时推送消息,并且对双向流式处理具有出色的支持。
- 网络约束环境 - 二进制 gRPC 消息始终小于等效的基于文本的 JSON 消息。 在撰写本文时,gRPC 主要用于后端服务。 新式浏览器无法提供支持前端 gRPC 客户端所需的 HTTP/2 控制级别。
实现与原理
分布式锁实现原理与实现过程,用过吗?三种实现方式(DB、Cache、zk) link
一般我们使用分布式锁有两个场景:
- 效率:使用分布式锁可以避免不同节点重复相同的工作,这些工作会浪费资源。比如用户付了钱之后有可能不同节点会发出多封短信。
- 正确性:加分布式锁同样可以避免破坏正确性的发生,如果两个节点在同一条数据上面操作,比如多个节点机器对同一个订单操作不同的流程有可能会导致该笔订单最后状态出现错误,造成损失。
特点:
- 互斥性:和我们本地锁一样互斥性是最基本,但是分布式锁需要保证在不同节点的不同线程的互斥。
- 可重入性:同一个节点上的同一个线程如果获取了锁之后那么也可以再次获取这个锁。
- 锁超时:和本地锁一样支持锁超时,防止死锁。
- 高效,高可用:加锁和解锁需要高效,同时也需要保证高可用防止分布式锁失效,可以增加降级。
- 支持阻塞和非阻塞:和ReentrantLock一样支持lock和trylock以及tryLock(long timeOut)。trylock非阻塞立即返回是否可以获取锁true/false。
- 支持公平锁和非公平锁(可选):公平锁的意思是按照请求加锁的顺序获得锁,非公平锁就相反是无序的。这个一般来说实现的比较少。
一般实现分布式锁有以下几个方式:
- MySql
- Zk
- Redis
-
自研分布式锁:如谷歌的Chubby。
- MySQL
创建一个锁表保存锁信息:
阻塞锁:
- lock一般是阻塞式的获取锁,意思就是不获取到锁誓不罢休,那么我们可以写一个死循环来执行其操作,循环最后没拿到锁加ms延迟再继续重试,不需要超时时间判断
- lcok内部是一个sql,为了达到可重入锁的效果那么我们应该先进行查询,如果有值,那么需要比较node_info是否一致,这里的node_info可以用机器IP和线程名字来表示,如果一致那么就加可重入锁count的值,如果不一致那么就返回false。如果没有值那么直接插入一条数据。
- 要注意的是这一段代码需要加事务,必须要保证这一系列操作的原子性
非阻塞锁:
- tryLock()是非阻塞获取锁,如果获取不到那么就会马上返回
- 如果获取不到锁或超时就返回false,获取到就返回true
解锁:
- 表中count=1的记录需要删除,>1的要自减1
锁超时:
- 我们有可能会遇到我们的机器节点挂了,那么这个锁就不会得到释放,我们可以启动一个定时任务,通过计算一般我们处理任务的一般的时间,比如是5ms,那么我们可以稍微扩大一点,当这个锁超过20ms(通过记录的创建和更新时间的差值,注意重入锁不会创建新记录)没有被释放我们就可以认定是节点挂了然后将其直接释放。
分析:
- 适用场景: Mysql分布式锁一般适用于资源不存在数据库的情况。如果数据库存在比如订单,那么可以直接对这条数据加行锁,不需要我们上面多的繁琐的步骤,比如一个订单,那么我们可以用select * from order_table where id = ‘xxx’ for update进行加行锁,那么其他的事务就不能对其进行修改。
- 优点:理解起来简单,不需要维护额外的第三方中间件(比如Redis,Zk)。
- 缺点:虽然容易理解但是实现起来较为繁琐,需要自己考虑锁超时,加事务等等。性能局限于数据库,一般对比缓存来说性能较低。对于高并发的场景并不是很适合。
乐观锁:
前面我们介绍的都是悲观锁,这里想额外提一下乐观锁,在我们实际项目中也是经常实现乐观锁,因为我们加行锁的性能消耗比较大,通常我们会对于一些竞争不是那么激烈,但是其又需要保证我们并发的顺序执行使用乐观锁进行处理,我们可以对我们的表加一个版本号字段,那么我们查询出来一个版本号之后,update或者delete的时候需要依赖我们查询出来的版本号,判断当前数据库和查询出来的版本号是否相等,如果相等那么就可以执行,如果不等那么就不能执行。这样的一个策略很像我们的CAS(Compare And Swap),比较并交换是一个原子操作。这样我们就能避免加select * for update行锁的开销。
ZooKeeper
ZooKeeper也是我们常见的实现分布式锁方法,相比于数据库如果没了解过ZooKeeper可能上手比较难一些。ZooKeeper是以Paxos算法为基础分布式应用程序协调服务。Zk的数据节点和文件目录类似,所以我们可以用此特性实现分布式锁。我们以某个资源为目录,这个目录下面的节点就是我们需要获取锁的客户端,未获取到锁的客户端注册需要注册Watcher到上一个客户端
/lock是我们用于加锁的目录,/resource_name是我们锁定的资源,其下面的节点按照我们加锁的顺序排列。
锁超时
Zookeeper不需要配置锁超时,由于我们设置节点是临时节点,我们的每个机器维护着一个ZK的session,通过这个session,ZK可以判断机器是否宕机。如果我们的机器挂掉的话,那么这个临时节点对应的就会被删除,所以我们不需要关心锁超时。
ZK小结
- 优点:ZK可以不需要关心锁超时时间,实现起来有现成的第三方包,比较方便,并且支持读写锁,ZK获取锁会按照加锁的顺序,所以其是公平锁。对于高可用利用ZK集群进行保证。
- 缺点:ZK需要额外维护,增加维护成本,性能和Mysql相差不大,依然比较差。并且需要开发人员了解ZK是什么。
Redis
加锁了之后如果机器宕机那么这个锁就不会得到释放所以会加入过期时间,加入过期时间需要和setNx同一个原子操作,在Redis2.8之前我们需要使用Lua脚本达到我们的目的,但是redis2.8之后redis支持nx和ex操作是同一原子操作。
redis原子命令set:
SET key value [EX seconds] [PX milliseconds] [NX|XX]
从 Redis 2.6.12 版本开始, SET 命令的行为可以通过一系列参数来修改:
- EX seconds : 将键的过期时间设置为 seconds 秒。 执行 SET key value EX seconds 的效果等同于执行 SETEX key seconds value 。
- PX milliseconds : 将键的过期时间设置为 milliseconds 毫秒。 执行 SET key value PX milliseconds 的效果等同于执行 PSETEX key milliseconds value 。
- NX : 只在键不存在时, 才对键进行设置操作。 执行 SET key value NX 的效果等同于执行 SETNX key value 。
- XX : 只在键已经存在时, 才对键进行设置操作。
对于分布式锁,就可以 set resourceName value ex 5 nx
Redisson
- 并没有使用我们的sexNx来进行操作,而是使用的hash结构,我们的每一个需要锁定的资源都可以看做是一个HashMap,锁定资源的节点信息是Key,锁定次数是value。通过这种方式可以很好的实现可重入的效果,只需要对value进行加1操作,就能实现可重入锁。当然这里也可以用之前我们说的本地计数进行优化(减少网络耗时)。
- 如果尝试加锁失败,判断是否超时,如果超时则返回false。
- 如果加锁失败之后,没有超时,那么需要在名字为redisson_lock__channel+lockName的channel上进行订阅,用于订阅解锁消息,然后一直阻塞直到超时,或者有解锁消息。
- 重试步骤1,2,3,直到最后获取到锁,或者某一步获取锁超时。
- unlock方法比较简单也是通过lua脚本进行解锁,如果是可重入锁,只是减1。如果是非加锁线程解锁,那么解锁失败。
- Redission还有公平锁的实现,对于公平锁其利用了list结构和hashset结构分别用来保存我们排队的节点,和我们节点的过期时间
RedLock
- 场景:集群中,当机器A申请到一把锁之后,如果Redis主宕机了,这个时候从机并没有同步到这一把锁,那么机器B再次申请的时候就会再次申请到这把锁,为了解决这个问题Redis作者提出了RedLock红锁的算法。
- 首先生成多个Redis集群的Rlock,并将其构造成RedLock。
- 依次循环对三个集群进行加锁。
- 如果循环加锁的过程中加锁失败,那么需要判断加锁失败的次数是否超出了最大值,这里的最大值是根据集群的个数,比如三个那么只允许失败一个,五个的话只允许失败两个,要保证多数(n/2+1)成功。
- 加锁的过程中需要判断是否加锁超时,有可能我们设置加锁只能用3ms,第一个集群加锁已经消耗了3ms了。那么也算加锁失败。
- 4步里面加锁失败的话,那么就会进行解锁操作。解锁时会对所有的集群在请求一次解锁。
Redis小结
- 优点:对于Redis实现简单,性能比ZK和Mysql好。如果不需要特别复杂的要求,那么自己就可以利用setNx进行实现,如果自己需要复杂的需求的话那么可以利用或者借鉴Redission。对于一些要求比较严格的场景来说的话可以使用RedLock。
- 缺点:需要维护Redis集群,如果要实现RedLock那么需要维护更多的集群。

etcd
etcd、consul,这种服务发现的分布式应用,都可以做分布式锁。
在对一致性要求很高的业务场景下(电商、银行支付),一般选择使用zookeeper或者etcd。对比zookeeper与etcd,如果考虑性能、并发量、维护成本来看。由于etcd是用Go语言开发,直接编译为二进制可执行文件,并不依赖其他任何东西,则更具有优势。
在CAP理论中,由于分布式系统中多节点通信不可避免出现网络延迟、丢包等问题一定会造成网络分区,在造成网络分区的情况下,一般有两个选择:CP or AP。
- 选择AP模型实现分布式锁时,client在通过集群主节点加锁成功之后,则立刻会获取锁成功的反馈。此时,在主节点还没来得及把数据同步给从节点时发生down机的话,系统会在从节点中选出一个节点作为新的主节点,新的主节点没有老的主节点对应的锁数据,导致其他client可以在新的主节点上拿到相同的锁。这个时候,就会导致多个进程/线程/协程来操作相同的临界资源数据,从而引发数据不一致性等问题。
- 选择CP模型实现分布式锁,只有在主节点把数据同步给大于1/2的从节点之后才被视为加锁成功。此时,主节点由于某些原因down机,系统会在从节点中选取出来数据比较新的一个从节点作为新的主节点,从而避免数据丢失等问题。
所以,对于分布式锁来说,在对数据有强一致性要求的场景下,AP模型不是一个好的选择。如果可以容忍少量数据丢失,出于维护成本等因素考虑,AP模型的Redis可优先选择。
etcd实现分布式锁的相关接口
对于分布式锁,主要用到etcd对应的添加、删除、续约接口。
// KV:键值相关操作
type KV interface {
    // 存放.
    Put(ctx context.Context, key, val string, opts ...OpOption) (*PutResponse, error)
    // 获取.
    Get(ctx context.Context, key string, opts ...OpOption) (*GetResponse, error)
    // 删除.
    Delete(ctx context.Context, key string, opts ...OpOption) (*DeleteResponse, error)
    // 压缩rev指定版本之前的历史数据.
    Compact(ctx context.Context, rev int64, opts ...CompactOption) (*CompactResponse, error)
    // 通用的操作执行命令,可用于操作集合的遍历。Put/Get/Delete也是基于Do.
    Do(ctx context.Context, op Op) (OpResponse, error)
    // 创建一个事务,只支持If/Then/Else/Commit操作.
    Txn(ctx context.Context) Txn
}


// Lease:租约相关操作
type Lease interface {
    // 分配一个租约.
    Grant(ctx context.Context, ttl int64) (*LeaseGrantResponse, error)
    // 释放一个租约.
    Revoke(ctx context.Context, id LeaseID) (*LeaseRevokeResponse, error)
    // 获取剩余TTL时间.
    TimeToLive(ctx context.Context, id LeaseID, opts ...LeaseOption) (*LeaseTimeToLiveResponse, error)
    // 获取所有租约.
    Leases(ctx context.Context) (*LeaseLeasesResponse, error)
    // 续约保持激活状态.
    KeepAlive(ctx context.Context, id LeaseID) (<-chan *LeaseKeepAliveResponse, error)
    // 仅续约激活一次.
    KeepAliveOnce(ctx context.Context, id LeaseID) (*LeaseKeepAliveResponse, error)
    // 关闭续约激活的功能.
    Close() error
}
etcd实现分布式锁代码示例
package main

import (
    "context"
    "fmt"
    "go.etcd.io/etcd/clientv3"
    "time"
)

var conf clientv3.Config

// 锁结构体
type EtcdMutex struct {
    Ttl int64//租约时间

    Conf   clientv3.Config    //etcd集群配置
    Key    string//etcd的key
    cancel context.CancelFunc //关闭续租的func

    txn     clientv3.Txn
    lease   clientv3.Lease
    leaseID clientv3.LeaseID
}

// 初始化锁
func (em *EtcdMutex) init() error {
    var err error
    var ctx context.Context

    client, err := clientv3.New(em.Conf)
    if err != nil {
        return err
    }

    em.txn = clientv3.NewKV(client).Txn(context.TODO())
    em.lease = clientv3.NewLease(client)
    leaseResp, err := em.lease.Grant(context.TODO(), em.Ttl)

    if err != nil {
        return err
    }

    ctx, em.cancel = context.WithCancel(context.TODO())
    em.leaseID = leaseResp.ID
    _, err = em.lease.KeepAlive(ctx, em.leaseID)

    return err
}

// 获取锁
func (em *EtcdMutex) Lock() error {
    err := em.init()
    if err != nil {
        return err
    }

    // LOCK
    em.txn.If(clientv3.Compare(clientv3.CreateRevision(em.Key), "=", 0)).
        Then(clientv3.OpPut(em.Key, "", clientv3.WithLease(em.leaseID))).Else()

    txnResp, err := em.txn.Commit()
    if err != nil {
        return err
    }

    // 判断txn.if条件是否成立
    if !txnResp.Succeeded {
        return fmt.Errorf("抢锁失败")
    }

    returnnil
}

//释放锁
func (em *EtcdMutex) UnLock() {
    // 租约自动过期,立刻过期
    // cancel取消续租,而revoke则是立即过期
    em.cancel()
    em.lease.Revoke(context.TODO(), em.leaseID)

    fmt.Println("释放了锁")
}

// groutine1
func try2lock1() {
    eMutex1 := &EtcdMutex{
        Conf: conf,
        Ttl:  10,
        Key:  "lock",
    }

    err := eMutex1.Lock()
    if err != nil {
        fmt.Println("groutine1抢锁失败")
        return
    }
    defer eMutex1.UnLock()

    fmt.Println("groutine1抢锁成功")
    time.Sleep(10 * time.Second)
}

// groutine2
func try2lock2() {
    eMutex2 := &EtcdMutex{
        Conf: conf,
        Ttl:  10,
        Key:  "lock",
    }

    err := eMutex2.Lock()
    if err != nil {
        fmt.Println("groutine2抢锁失败")
        return
    }

    defer eMutex2.UnLock()
    fmt.Println("groutine2抢锁成功")
}

// 测试代码
func EtcdRunTester() {
    conf = clientv3.Config{
        Endpoints:   []string{"127.0.0.1:2379"},
        DialTimeout: 5 * time.Second,
    }

    // 启动两个协程竞争锁
    go try2lock1()
    go try2lock2()

    time.Sleep(300 * time.Second)
}
总结:数据要求强一致性推荐支持CP的etcd、zookeeper,数据允许少量丢失、不要求强一致性的推荐支持AP的Redis
etcd实现分布式锁,raft算法保证数据强一致性的原理 link
etcd 支持以下功能,正是依赖这些功能来实现分布式锁的:
- Lease 机制:即租约机制(TTL,Time To Live),Etcd 可以为存储的 KV 对设置租约,当租约到期,KV 将失效删除;同时也支持续约,即 KeepAlive。
- Revision 机制:每个 key 带有一个 Revision 属性值,etcd 每进行一次事务对应的全局 Revision 值都会加一,因此每个 key 对应的 Revision 属性值都是全局唯一的。通过比较 Revision 的大小就可以知道进行写操作的顺序。
- 在实现分布式锁时,多个程序同时抢锁,根据 Revision 值大小依次获得锁,可以避免 “羊群效应” (也称 “惊群效应”),实现公平锁。
- Prefix 机制:即前缀机制,也称目录机制。可以根据前缀(目录)获取该目录下所有的 key 及对应的属性(包括 key, value 以及 revision 等)。
- Watch 机制:即监听机制,Watch 机制支持 Watch 某个固定的 key,也支持 Watch 一个目录(前缀机制),当被 Watch 的 key 或目录发生变化,客户端将收到通知。
实现过程:
- 准备
客户端连接 Etcd,以 /lock/mylock 为前缀创建全局唯一的 key,假设第一个客户端对应的 key=”/lock/mylock/UUID1”,第二个为 key=”/lock/mylock/UUID2”;客户端分别为自己的 key 创建租约 - Lease,租约的长度根据业务耗时确定,假设为 15s;
- 创建定时任务作为租约的“心跳”
当一个客户端持有锁期间,其它客户端只能等待,为了避免等待期间租约失效,客户端需创建一个定时任务作为“心跳”进行续约。此外,如果持有锁期间客户端崩溃,心跳停止,key 将因租约到期而被删除,从而锁释放,避免死锁。
- 客户端将自己全局唯一的 key 写入 Etcd 进行 put 操作,将步骤 1 中创建的 key 绑定租约写入 Etcd,根据 Etcd 的 Revision 机制,假设两个客户端 put 操作返回的 Revision 分别为 1、2,客户端需记录 Revision 用以接下来判断自己是否获得锁。
- 客户端判断是否获得锁 客户端以前缀 /lock/mylock 读取 keyValue 列表(keyValue 中带有 key 对应的 Revision),判断自己 key 的 Revision 是否为当前列表中最小的,如果是则认为获得锁;否则监听列表中前一个 Revision 比自己小的 key 的删除事件,一旦监听到删除事件或者因租约失效而删除的事件,则自己获得锁。
步骤 5: 执行业务 获得锁后,操作共享资源,执行业务代码。
步骤 6: 释放锁 完成业务流程后,删除对应的key释放锁。
选举
etcd有多种使用场景,Master选举是其中一种。说起Master选举,过去常常使用zookeeper,通过创建EPHEMERAL_SEQUENTIAL节点(临时有序节点),我们选择序号最小的节点作为Master,逻辑直观,实现简单是其优势,但是要实现一个高健壮性的选举并不简单,同时zookeeper繁杂的扩缩容机制也是沉重的负担。
master 选举根本上也是抢锁,与zookeeper直观选举逻辑相比,etcd的选举则需要在我们熟悉它的一系列基本概念后,调动我们充分的想象力:
- MVCC,key存在版本属性,没被创建时版本号为0;
- CAS操作,结合MVCC,可以实现竞选逻辑,if(version == 0) set(key,value),通过原子操作,确保只有一台机器能set成功;
- Lease租约,可以对key绑定一个租约,租约到期时没预约,这个key就会被回收;
- Watch监听,监听key的变化事件,如果key被删除,则重新发起竞选。 至此,etcd选举的逻辑大体清晰了,但这一系列操作与zookeeper相比复杂很多,有没有已经封装好的库可以直接拿来用?etcd clientv3 concurrency中有对选举及分布式锁的封装。后面进一步发现,etcdctl v3里已经有master选举的实现了
分布式的CAP理论是什么
一个分布式系统最多只能同时满足一致性(Consistency)、可用性(Availability)和分区容错性(Partition tolerance)这三项中的两项。
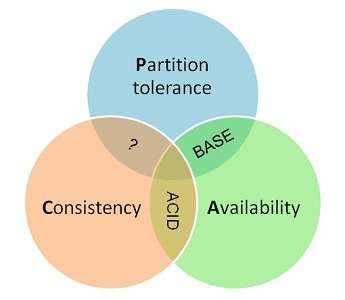
Consistency 一致性
- 一致性指“all nodes see the same data at the same time”,即所有节点在同一时间的数据完全一致。
- 一致性是因为多个数据拷贝下并发读写才有的问题,因此理解时一定要注意结合考虑多个数据拷贝下并发读写的场景。
Availability 可用性 可用性指“Reads and writes always succeed”,即服务在正常响应时间内一直可用。
Partition Tolerance分区容错性 分区容错性指“the system continues to operate despite arbitrary message loss or failure of part of the system”,即分布式系统在遇到某节点或网络分区故障的时候,仍然能够对外提供满足一致性或可用性的服务。
grpc内部原理是什么 link
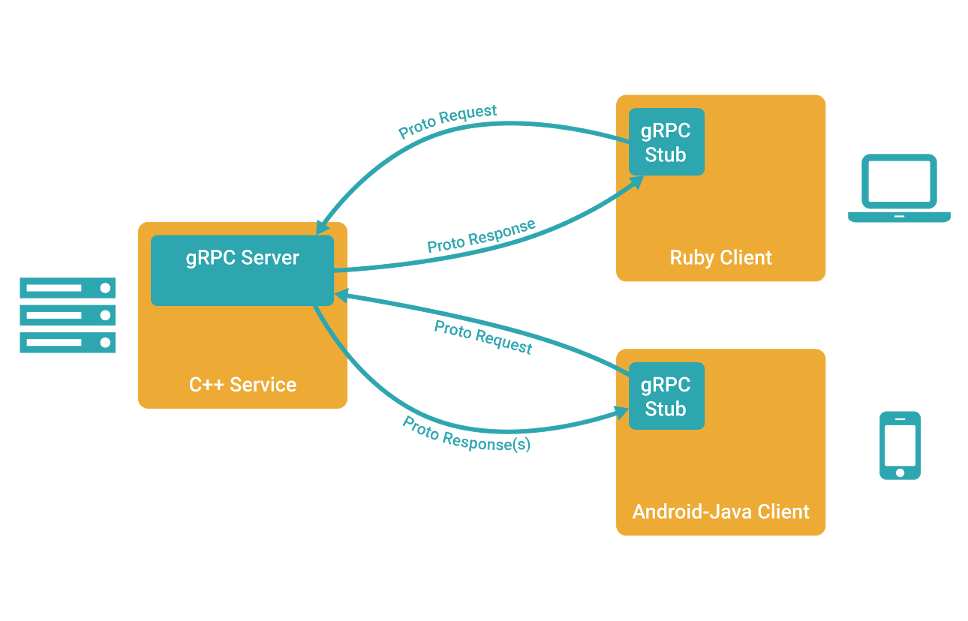
1、客户端(gRPC Stub)调用 A 方法,发起 RPC 调用。
2、对请求信息使用 Protobuf 进行对象序列化压缩(IDL)。
3、服务端(gRPC Server)接收到请求后,解码请求体,进行业务逻辑处理并返回。
4、对响应结果使用 Protobuf 进行对象序列化压缩(IDL)。
5、客户端接受到服务端响应,解码请求体。回调被调用的 A 方法,唤醒正在等待响应(阻塞)的客户端调用并返回响应结果。
配置中心如何保证一致性 link
配置通常都只会有一个入口修改,因此可以考虑在配置修改后,通知应用服务清理本地缓存和分布式缓存。这里可以引入mq或ZooKeeper。最后通过,推拉相结合的方式,完成数据的一致性。
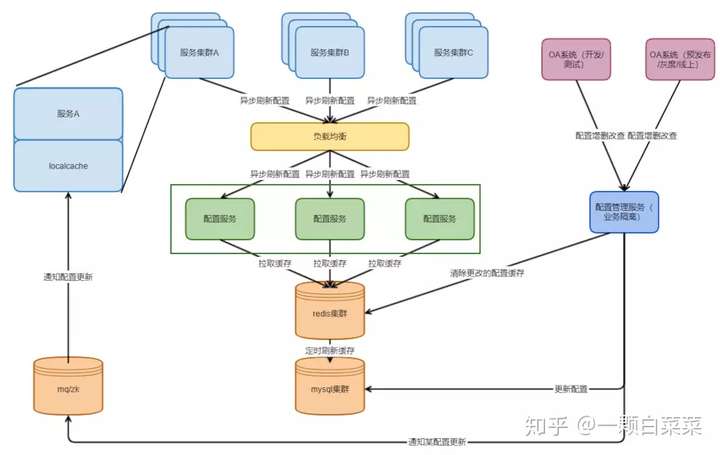
load balance原理
负载均衡(Load Balancing),简单地说就是将多台服务器组成一个服务器集群,然后根据我们设置的规则给服务器集群分配“工作任务”。

多种方案:
- HTTP重定向 当用户发来请求的时候,Web服务器通过修改HTTP响应头中的Location标记来返回一个新的url,然后浏览器再继续请求这个新url,实际上就是页面重定向。 通过重定向,来达到“负载均衡”的目标。重定向的HTTP返回码是302。 但是,它在大规模访问量下,性能不佳。而且,给用户的体验也不好,实际请求发生重定向,增加了网络延时。
- 反向代理负载均衡 反向代理服务的核心工作主要是转发HTTP请求,扮演了浏览器端和后台Web服务器中转的角色。因为它工作在HTTP层(应用层),也就是网络七层结构中的第七层,因此也被称为“七层负载均衡”。可以做反向代理的软件很多,比较常见的一种是Nginx。 Nginx是一种非常灵活的反向代理软件,可以自由定制化转发策略,分配服务器流量的权重等。反向代理中,常见的一个问题,就是Web服务器存储的session数据,因为一般负载均衡的策略都是随机分配请求的。同一个登录用户的请求,无法保证一定分配到相同的Web机器上,会导致无法找到session的问题。
解决方案主要有两种: 1)配置反向代理的转发规则,让同一个用户的请求一定落到同一台机器上(通过分析cookie),复杂的转发规则将会消耗更多的CPU,也增加了代理服务器的负担。 2)将session这类的信息,专门用某个独立服务来存储,例如Redis/memchache,这个方案是比较推荐的。
反向代理服务,也是可以开启缓存的,如果开启了,会增加反向代理的负担,需要谨慎使用。这种负载均衡策略实现和部署非常简单,而且性能表现也比较好。 但是,它有“单点故障”的问题,如果挂了,会带来很多的麻烦。而且,到了后期Web服务器继续增加,它本身可能成为系统的瓶颈。
- DNS负载均衡 DNS(Domain Name System)负责域名解析的服务,域名url实际上是服务器的别名,实际映射是一个IP地址,解析过程,就是DNS完成域名到IP的映射。而一个域名是可以配置成对应多个IP的。因此,DNS也就可以作为负载均衡服务。 这种负载均衡策略,配置简单,性能极佳。但是,不能自由定义规则,而且,变更被映射的IP或者机器故障时很麻烦,还存在DNS生效延迟的问题。
- CDN/GSLB负载均衡 我们常用的CDN(Content Delivery Network,内容分发网络)实现方式,其实就是在同一个域名映射为多IP的基础上更进一步,通过GSLB(Global Server Load Balance,全局负载均衡)按照指定规则映射域名的IP。 一般情况下都是按照地理位置,将离用户近的IP返回给用户,减少网络传输中的路由节点之间的跳跃消耗。
CDN在Web系统中,一般情况下是用来解决较大的静态资源(html/Js/Css/图片/视频/文件等)的加载问题,让这些比较依赖网络下载的内容,尽可能离用户更近,提升用户体验。 这种方式,和前面的DNS负载均衡一样,性能极佳,而且支持配置多种策略。但是,搭建和维护成本非常高。互联网一线公司,会自建CDN服务,中小型公司一般使用第三方提供的CDN。
- IP负载均衡 IP负载均衡服务是工作在网络层(修改IP)和传输层(修改端口,第四层),比起工作在应用层(第七层)性能要高出非常多。 原理是,他是对IP层的数据包的IP地址和端口信息进行修改,达到负载均衡的目的。这种方式,也被称为“四层负载均衡”。 常见的负载均衡方式,是LVS,通过IPVS(IP Virtual Server,IP虚拟服务)来实现。
golang高并发
您对分布式事务(Distributed Transaction)有何了解?分布式一致性原则是什么?
分布式事务是指单个事件导致两个或多个不能以原子方式提交的单独数据源的突变的任何情况。在微服务的世界中,它变得更加复杂,因为每个服务都是一个工作单元,并且大多数时候多个服务必须协同工作才能使业务成功。
CAP 略(上面有了)
ACID(Atomicity原子性,Consistency一致性,Isolation隔离性,Durability持久性)是事务的特点,具有强一致性,一般用于单机事务,分布式事务若采用这个原则会丧失一定的可用性,属于CP系统。
BASE(Basically Availabe基本可用,Soft state软状态,Eventually consistency最终一致性)理论是对大规模的互联网分布式系统实践的总结,用弱一致性来换取可用性,不同于ACID,属于AP系统。
如何保证服务宕机造成的分布式服务节点处理问题 link
在高并发领域,在分布式系统中,可能因为一个小小的功能扛不住压力,宕机了,导致其他服务也跟随宕机,最终导致整个系统宕机。所以需要熔断器,避免雪崩。
如果你的微服务依赖于另一个系统来提供响应,并且该系统需要很长时间才会响应,那么你的总体响应SLA将会受到影响。为了避免这种场景并且快速做出响应,你需要遵循的一个简单的微服务最佳实践是使用熔断器来使外部的调用超时,然后返回一个默认响应或者错误。熔断器模式可以参考最下面的引用。这种方式可以隔离故障服务,而不会导致级联故障,可以让你的服务保持在健康的状态。你可以选择使用流行的产品,比如Netflix开发的Hystrix。这要比使用HTTP CONNECT_TIMEOUT和READ_TIMEOUT设置更好,因为它不会启动超出配置范围的其他线程。
熔断本质上是一个过载保护机制。
做熔断的思路大体上就是:一个中心思想,分四步走。
首先,需秉持的一个中心思想是:量力而行。因为软件和人不同,没有奇迹会发生,什么样的性能撑多少流量是固定的。这是根本。
然后,这四步走分别是:
- 定义一个识别是否处于“不可用”状态的策略
- 切断联系
- 定义一个识别是否处于“可用”状态的策略,并尝试探测
- 重新恢复正常
识别:
- 是不是能调通
- 如果能调通,耗时是不是超过预期的长
切断联系:
我们不能将偶发的瞬时异常等同于系统“不可用”(避免以偏概全)。由此我们需要引入一个「时间窗口」的概念,这个时间窗口用来“放宽”判定“不可用”的区间,也意味着多给了系统几次证明自己“可用”机会。但是,如果系统还是在这个时间窗口内达到了你定义“不可用”标准,那么我们就要“断臂求生”了。
这个标准可以有两种方式来指定。
- 阈值。比如,在10秒内出现100次“无法连接”或者出现100次大于5秒的请求。
- 百分比。比如,在10秒内有30%请求“无法连接”或者30%的请求大于5秒。
作为客户端一方,在自己进程内通过代理发起调用之前就可以直接返回失败,不走网络。
尝试探测本质上是一个“试错”,要控制下“试错成本”。所以我们不可能拿100%的流量去验证,在服务端,一般会有以下两种方式:
- 放行一定比例的流量去验证。
- 如果在整个通信框架都是统一的情况下,还可以统一给每个系统增加一个专门用于验证程序健康状态检测的独立接口。这个接口额外可以多返回一些系统负载信息用于判断健康状态,如CPU、I/O的情况等。
恢复:
一旦通过了衡量是否“可用”的验证,整个系统就恢复到了“正常”状态,此时需要重新开启识别“不可用”的策略。就这样,系统会形成一个循环。
熔断往往应作为最后的选择,我们应优先使用一些「降级」或者「限流」方案。
todo:降级、限流
服务发现怎么实现的 link
服务提供者是什么,简单点说就是一个HTTP服务器,提供了API服务,有一个IP端口作为服务地址。服务消费者是什么,它就是一个简单的进程,想要访问服务提供者提供的服务来干一些事情。一个HTTP服务器既可以是服务提供者对外提供服务,也可以是消费者需要别的服务提供者提供的服务,这就是服务依赖
服务发现有三个角色,服务提供者、服务消费者和服务中介。服务中介是联系服务提供者和服务消费者的桥梁。服务提供者将自己提供的服务地址注册到服务中介,服务消费者从服务中介那里查找自己想要的服务的地址,然后享受这个服务。服务中介提供多个服务,每个服务对应多个服务提供者。
服务中介就是一个字典,字典里有很多key/value键值对,key是服务名称,value是服务提供者的地址列表。服务注册就是调用字典的Put方法塞东西,服务查找就是调用字典的Get方法拿东西。
当服务提供者节点挂掉时,要求服务能够及时取消注册,比便及时通知消费者重新获取服务地址。
当服务提供者新加入时,要求服务中介能及时告知服务消费者,你要不要尝试一下新的服务。
有两种主要的服务发现模式:客户端服务发现(client-side discovery)和服务器端服务发现(server-side discovery)。
- 客户端服务发现模式
当使用客户端服务发现的时候,客户端负责决定可用的服务实例的网络地址,以及围绕他们的负载均衡。客户端向服务注册表(service registry)发送一个请求,服务注册表是一个可用服务实例的数据库。客户端使用一个负载均衡算法,去选择一个可用的服务实例,来响应这个请求
一个服务实例被启动时,它的网络地址会被写到注册表上;当服务实例终止时,再从注册表中删除。这个服务实例的注册表通过心跳机制动态刷新。
客户端的服务发现模式有优势也有缺点。这种模式相对直接,但是除了服务注册表,没有其它动态的部分了。而且,由于客户端知道可用的服务实例,可以做到智能的,应用明确的负载均衡决策,比如一直用hash算法。这种模式的一个重大缺陷在于,客户端和服务注册表是逻辑耦合,必须为服务客户端用到的每一种编程语言和框架实现客户端服务发现逻辑。
- 服务器端服务发现模式
客户端通过负载均衡器向一个服务发送请求,这个负载均衡器会查询服务注册表,并将请求路由到可用的服务实例上。通过客户端的服务发现,服务实例在服务注册表上被注册和注销。
AWS的ELB(Elastic Load Blancer)就是一个服务器端服务发现路由器。一个ELB通常被用来均衡来自互联网的外部流量,也可以用ELB去均衡流向VPC(Virtual Private Cloud)的流量。一个客户端通过ELB发送请求(HTTP或TCP)时,使用的是DNS,ELB会均衡这些注册的EC2实例或ECS(EC2 Container Service)容器的流量。没有另外的服务注册表,EC2实例和ECS容器也只会在ELB上注册。
HTTP服务器和类似Nginx、Nginx Plus的负载均衡器也可以被用做服务器端服务发现负载均衡器。
- 服务注册表(Service Registry)
服务实例必须要从注册表中注册和注销,有很多种方式来处理注册和注销的过程。一个选择是服务实例自己注册,即self-registration模式。另一种选择是其它的系统组件管理服务实例的注册,即第third-party registration模式。
自注册模式(The Self-Registration Pattern)
在self-registration模式中,服务实例负责从服务注册表中注册和注销。如果需要的话,一个服务实例发送心跳请求防止注册过期。
第三方注册模式(The Third-Party Registration Pattern)
在third-party registration模式中,服务实例不会自己在服务注册表中注册,由另一个系统组件service registrar负责。service registrar通过轮询部署环境或订阅事件去跟踪运行中的实例的变化。当它注意到一个新的可用的服务实例时,就会到注册表中去注册。service registrar也会将停止的服务实例注销
third-party registration模式主要的优势在于解耦了服务和服务注册表。不需要为每个语言和框架都实现服务注册逻辑。服务实例注册由一个专用的服务集中实现。缺点是除了被内置到部署环境中,它本身也是一个高可用的系统组件,需要被启动和管理。
服务管理:拆分、调用、注册、发现、下线、发布、依赖、关键度定义、服务调用链路、性能、可用性、健康检查 link
todo
注册中心,服务高可用、配置、注册中心容灾策略 link
todo
业务安全?验签、鉴权 link
在微服务架构下,我们更倾向于将 Oauth 和 JWT 结合使用,Oauth 一般用于第三方接入的场景,管理对外的权限,所以比较适合和 API 网关结合,针对于外部的访问进行鉴权(当然,底层 Token 标准采用 JWT 也是可以的)。 JWT 更加轻巧,在微服务之间进行访问鉴权已然足够,并且可以避免在流转过程中和身份认证服务打交道。当然,从能力实现角度来说,类似于分布式 Session 在很多场景下也是完全能满足需求,具体怎么去选择鉴权方案,还是要结合实际的需求来。
消息中间件:rabbitmq、kafka
日志
elasticsearch、fluentd、kubana
序列化protobuf、json,序列化过程。跨语言、proto3语法、库
golang框架:kratos、gin、beego、go-micro、leaf
微服务框架的功能实现、模块
wire依赖注入
部署与测试
调试
对接第三方库与中间件
从gin理解net/http库与路由、中间件实现过程
beego实现mvc过程
go-micro与kratos性能比较,grpc与其他协议性能比较
leaf游戏框架实现原理和应用
golang开源:gorm、go-redis、redigo、ent、boltdb、goleveldb、kingshard
gorm,预处理,避免sql注入
go-redis,连接池,配置参数优化,集群操作
redigo,自己编写连接池,redis命令
ent,原理,使用
boltdb,原理,优缺点,应用(etcd)
goleveldb,原理,优缺点,与boltdb、rocksdb等对比,应用(pika等)
kingshard,DB proxy,读写分离
其他开源,docker、consul(注册中心)、k8s、tidb(分布式mysql)、influxdb(时序数据库)、cockroachdb(云原生分布式数据库,new sql)、go-kit(微服务)
kafka重点 link link code config
- 介绍
- 体系架构
- Kafka 是一个分布式消息引擎与流处理平台,经常用做企业的消息总线、实时数据管道,有的还把它当做存储系统来使用。
- Kafka 的设计遵循生产者消费者模式,生产者发送消息到 broker 中某一个 topic 的具体分区里,消费者从一个或多个分区中拉取数据进行消费。
- Kafka 依靠 Zookeeper 做分布式协调服务,负责存储和管理 Kafka 集群中的元数据信息,包括集群中的 broker 信息、topic 信息、topic 的分区与副本信息等.

- 术语和概念
- Producer:生产者,消息产生和发送端。
- Broker:Kafka 实例,多个 broker 组成一个 Kafka 集群,通常一台机器部署一个 Kafka 实例,一个实例挂了不影响其他实例。
- Consumer:消费者,拉取消息进行消费。 一个 topic 可以让若干个消费者进行消费,若干个消费者组成一个 Consumer Group 即消费组,一条消息只能被消费组中一个 Consumer 消费。
- Topic:主题,服务端消息的逻辑存储单元。一个 topic 通常包含若干个 Partition 分区。
- Partition:topic 的分区,分布式存储在各个 broker 中, 实现发布与订阅的负载均衡。若干个分区可以被若干个 Consumer 同时消费,达到消费者高吞吐量。一个分区拥有多个副本(Replica),这是Kafka在可靠性和可用性方面的设计,后面会重点介绍。
- message:消息,或称日志消息,是 Kafka 服务端实际存储的数据,每一条消息都由一个 key、一个 value 以及消息时间戳 timestamp 组成。
- offset:偏移量,分区中的消息位置,由 Kafka 自身维护,Consumer 消费时也要保存一份 offset 以维护消费过的消息位置。
- 作用与特点
- 高吞吐、低延时:这是 Kafka 显著的特点,Kafka 能够达到百万级的消息吞吐量,延迟可达毫秒级;
- 持久化存储:Kafka 的消息最终持久化保存在磁盘之上,提供了顺序读写以保证性能,并且通过 Kafka 的副本机制提高了数据可靠性。
- 分布式可扩展:Kafka 的数据是分布式存储在不同 broker 节点的,以 topic 组织数据并且按 partition 进行分布式存储,整体的扩展性都非常好。
- 高容错性:集群中任意一个 broker 节点宕机,Kafka 仍能对外提供服务。
- 体系架构
- Kafka 消息发送机制

- 异步发送
- 生产端构建的 ProducerRecord 先是经过 keySerializer、valueSerializer 序列化后,再是经过 Partition 分区器处理,决定消息落到 topic 具体某个分区中,最后把消息发送到客户端的消息缓冲池 accumulator 中,交由一个叫作 Sender 的线程发送到 broker 端。
- 缓冲池 accumulator 的最大大小由参数 buffer.memory 控制,默认是 32M,当生产消息的速度过快导致 buffer 满了的时候,将阻塞 max.block.ms 时间,超时抛异常,所以 buffer 的大小可以根据实际的业务情况进行适当调整。
- 批量发送
- 发送到缓冲 buffer 中消息将会被分为一个一个的 batch,分批次的发送到 broker 端,批次大小由参数 batch.size 控制,默认16KB。这就意味着正常情况下消息会攒够 16KB 时才会批量发送到 broker 端,所以一般减小 batch 大小有利于降低消息延时,增加 batch 大小有利于提升吞吐量。
- 生成端消息是不是必须要达到一个 batch 大小时,才会批量发送到服务端呢?答案是否定的,Kafka 生产端提供了另一个重要参数 linger.ms,该参数控制了 batch 最大的空闲时间,超过该时间的 batch 也会被发送到 broker 端。
- 消息重试
- 生产端支持重试机制,对于某些原因导致消息发送失败的,比如网络抖动,开启重试后 Producer 会尝试再次发送消息。该功能由参数 retries 控制,参数含义代表重试次数,默认值为 0 表示不重试,建议设置大于 0 比如 3。
- 异步发送
- Kafka 副本机制
- 分区副本(Replica)的概念
- 副本机制也称 Replication 机制,是 Kafka 实现高可靠、高可用的基础。Kafka 中有 leader 和 follower 两类副本。
- 副本作用
- Kafka 默认只会给分区设置一个副本,由 broker 端参数 default.replication.factor 控制,默认值为 1,通常我们会修改该默认值,或者命令行创建 topic 时指定 replication-factor 参数,生产建议设置 3 副本。
- 副本作用
- 消息冗余存储,提高 Kafka 数据的可靠性;
- 提高 Kafka 服务的可用性,follower 副本能够在 leader 副本挂掉或者 broker 宕机的时候参与 leader 选举,继续对外提供读写服务。
- 读写分离
- Kafka 并不支持读写分区,生产消费端所有的读写请求都是由 leader 副本处理的,follower 副本的主要工作就是从 leader 副本处异步拉取消息,进行消息数据的同步,并不对外提供读写服务。
- Kafka 之所以这样设计,主要是为了保证读写一致性,因为副本同步是一个异步的过程,如果当 follower 副本还没完全和 leader 同步时,从 follower 副本读取数据可能会读不到最新的消息。
- ISR 副本集合
- Kafka 为了维护分区副本的同步,引入 ISR(In-Sync Replicas)副本集合的概念,ISR 是分区中正在与 leader 副本进行同步的 replica 列表,且必定包含 leader 副本。
- ISR 列表是持久化在 Zookeeper 中的,任何在 ISR 列表中的副本都有资格参与 leader 选举。
- ISR 列表是动态变化的,并不是所有的分区副本都在 ISR 列表中,哪些副本会被包含在 ISR 列表中呢?副本被包含在 ISR 列表中的条件是由参数 replica.lag.time.max.ms 控制的,参数含义是副本同步落后于 leader 的最大时间间隔,默认10s,意思就是说如果某一 follower 副本中的消息比 leader 延时超过10s,就会被从 ISR 中排除。Kafka 之所以这样设计,主要是为了减少消息丢失,只有与 leader 副本进行实时同步的 follower 副本才有资格参与 leader 选举,这里指相对实时。

- Unclean leader 选举
- ISR 为空说明 leader 副本也“挂掉”了,此时 Kafka 就要重新选举出新的 leader。但 ISR 为空,怎么进行 leader 选举呢?
- Kafka 把不在 ISR 列表中的存活副本称为“非同步副本”,这些副本中的消息远远落后于 leader,如果选举这种副本作为 leader 的话就可能造成数据丢失。Kafka broker 端提供了一个参数 unclean.leader.election.enable,用于控制是否允许非同步副本参与 leader 选举;如果开启,则当 ISR 为空时就会从这些副本中选举新的 leader,这个过程称为 Unclean leader 选举。
- 如果开启 Unclean leader 选举,可能会造成数据丢失,但保证了始终有一个 leader 副本对外提供服务;如果禁用 Unclean leader 选举,就会避免数据丢失,但这时分区就会不可用。这就是典型的 CAP 理论,即一个系统不可能同时满足一致性(Consistency)、可用性(Availability)和分区容错性(Partition Tolerance)中的两个。所以在这个问题上,Kafka 赋予了我们选择 C 或 A 的权利。
- 建议关闭 Unclean leader 选举,因为通常数据的一致性要比可用性重要的多。
- 分区副本(Replica)的概念
- Kafka 控制器
- 控制器(Controller)是 Kafka 的核心组件,它的主要作用是在 Zookeeper 的帮助下管理和协调整个 Kafka 集群。集群中任意一个 broker 都能充当控制器的角色,但在运行过程中,只能有一个 broker 成为控制器。
- Zookeeper
- 控制器的产生依赖于 Zookeeper 的 ZNode 模型和 Watcher 机制。Zookeeper 的数据模型是类似 Unix 操作系统的 ZNode Tree 即 ZNode 树,ZNode 是 Zookeeper 中的数据节点,是 Zookeeper 存储数据的最小单元,每个 ZNode 可以保存数据,也可以挂载子节点,根节点是 /。
- Zookeeper 有两类 ZNode 节点,分别是持久性节点和临时节点。持久性节点是指客户端与 Zookeeper 断开会话后,该节点依旧存在,直到执行删除操作才会清除节点。临时节点的生命周期是和客户端的会话绑定在一起,客户端与 Zookeeper 断开会话后,临时节点就会被自动删除。
- Watcher 机制是 Zookeeper 非常重要的特性,它可以在 ZNode 节点上绑定监听事件,比如可以监听节点数据变更、节点删除、子节点状态变更等事件,通过这个事件机制,可以基于 ZooKeeper 实现分布式锁、集群管理等功能。
- 控制器选举
- 当集群中的任意 broker 启动时,都会尝试去 Zookeeper 中创建 /controller 节点,第一个成功创建 /controller 节点的 broker 则会被指定为控制器,其他 broker 则会监听该节点的变化。
- 当运行中的控制器突然宕机或意外终止时,其他 broker 能够快速地感知到,然后再次尝试创建 /controller 节点,创建成功的 broker 会成为新的控制器。
- 控制器功能(管理和协调 Kafka 集群)
- 主题管理:创建、删除 topic,以及增加 topic 分区等操作都是由控制器执行。
- 分区重分配:执行 Kafka 的 reassign 脚本对 topic 分区重分配的操作,也是由控制器实现。
- Preferred leader 选举:这里有一个概念叫 Preferred replica 即优先副本,表示的是分配副本中的第一个副本。Preferred leader 选举就是指 Kafka 在某些情况下出现 leader 负载不均衡时,会选择 preferred 副本作为新 leader 的一种方案。这也是控制器的职责范围。
- 集群成员管理:控制器能够监控新 broker 的增加,broker 的主动关闭与被动宕机,进而做其他工作。这里也是利用前面所说的 Zookeeper 的 ZNode 模型和 Watcher 机制,控制器会监听 Zookeeper 中 /- brokers/ids 下临时节点的变化。
- 数据服务:控制器上保存了最全的集群元数据信息,其他所有 broker 会定期接收控制器发来的元数据更新请求,从而更新其内存中的缓存数据。
- 社区改进
- 在 0.11 版本中对控制器进行了重构,其中最大的改进把控制器内部多线程的设计改成了单线程加事件队列的方案,消除了多线程的资源消耗和线程安全问题
- 另外一个改进是把之前同步操作 Zookeeper 改为了异步操作,消除了 Zookeeper 端的性能瓶颈,大大提升了控制器的稳定性。
- Kafka 消费端 Rebalance 机制
- 消费组
- 消费组的概念,一个 topic 可以让若干个消费者进行消费,若干个消费者组成一个 Consumer Group 即消费组 ,一条消息只能被消费组中的一个消费者进行消费。

- 消费组的概念,一个 topic 可以让若干个消费者进行消费,若干个消费者组成一个 Consumer Group 即消费组 ,一条消息只能被消费组中的一个消费者进行消费。
- Rebalance 概念
- 就 Kafka 消费端而言,有一个难以避免的问题就是消费者的重平衡即 Rebalance。Rebalance 是让一个消费组的所有消费者就如何消费订阅 topic 的所有分区达成共识的过程.
- 在 Rebalance 过程中,所有 Consumer 实例都会停止消费,等待 Rebalance 的完成。因为要停止消费等待重平衡完成,因此 Rebalance 会严重影响消费端的 TPS(Throughputs 吞吐量),是应当尽量避免的。
- Rebalance 发生条件
- 何时会发生 Rebalance
- 消费组的消费者成员数量发生变化
- 消费主题的数量发生变化
- 消费主题的分区数量发生变化
- 后两种情况一般是计划内的,比如为了提高消息吞吐量增加 topic 分区数,这些情况一般是不可避免的
- 何时会发生 Rebalance
- Kafka 协调器
- 主要有两类 Kafka 协调器:
- 组协调器(Group Coordinator)
- 消费者协调器(Consumer Coordinator)

- Kafka 为了更好的实现消费组成员管理、位移管理,以及 Rebalance 等,broker 服务端引入了组协调器(Group Coordinator),消费端引入了消费者协调器(Consumer Coordinator)。
- 每个 broker 启动的时候,都会创建一个 GroupCoordinator 实例,负责消费组注册、消费者成员记录、offset 等元数据操作,这里也可以看出每个 broker 都有自己的 Coordinator 组件。另外,每个 Consumer 实例化时,同时会创建一个 ConsumerCoordinator 实例,负责消费组下各个消费者和服务端组协调器之前的通信。
- 客户端的消费者协调器 Consumer Coordinator 和服务端的组协调器 Group Coordinator 会通过心跳不断保持通信。
- 主要有两类 Kafka 协调器:
- 如何避免消费组 Rebalance
- 如何避免组内消费者成员发生变化导致的 Rebalance?组内成员发生变化无非就两种情况,一种是有新的消费者加入,通常是我们为了提高消费速度增加了消费者数量,比如增加了消费线程或者多部署了一份消费程序,这种情况可以认为是正常的;另一种是有消费者退出,这种情况多是和我们消费端代码有关,是我们要重点避免的。
- 正常情况下,每个消费者都会定期向组协调器 Group Coordinator 发送心跳,表明自己还在存活,如果消费者不能及时的发送心跳,组协调器会认为该消费者已经“死”了,就会导致消费者离组引发 Rebalance 问题。
- 这里涉及两个消费端参数:session.timeout.ms 和 heartbeat.interval.ms,含义分别是组协调器认为消费组存活的期限,和消费者发送心跳的时间间隔,其中 heartbeat.interval.ms 默认值是3s,session.timeout.ms 在 0.10.1 版本之前默认 30s,之后默认 10s。
- 0.10.1 版本还有两个值得注意的地方:
- 从该版本开始,Kafka 维护了单独的心跳线程,之前版本中 Kafka 是使用业务主线程发送的心跳。
- 增加了一个重要的参数 max.poll.interval.ms,表示 Consumer 两次调用 poll 方法拉取数据的最大时间间隔,默认值 5min,对于那些忙于业务逻辑处理导致超过 max.poll.interval.ms 时间的消费者将会离开消费组,此时将发生一次 Rebalance。
- 此外,如果 Consumer 端频繁 FullGC 也可能会导致消费端长时间停顿,从而引发 Rebalance。因此,我们总结如何避免消费组 Rebalance 问题,主要从以下几方面入手:
- 合理配置 session.timeout.ms 和 heartbeat.interval.ms,建议 0.10.1 之前适当调大 session 超时时间尽量规避 Rebalance。
- 根据实际业务调整 max.poll.interval.ms,通常建议调大避免 Rebalance,但注意 0.10.1 版本之前没有该参数。
- 监控消费端的 GC 情况避免由于频繁 FullGC 导致线程长时间停顿引发 Rebalance。
- 合理调整以上参数,可以减少生产环境中 Rebalance 发生的几率,提升 Consumer 端的 TPS 和稳定性。
- 消费组
- 安装与配置
- docker-compose.yml文件
version: '3.7'
services:
zookeeper:
  image: wurstmeister/zookeeper
  volumes:
    - ./data:/data
  ports:
    - 2181:2181

kafka:
  image: wurstmeister/kafka
  ports:
    - 9092:9092
  environment:
    KAFKA_BROKER_ID: 0
    KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://127.0.0.1:9092
    KAFKA_CREATE_TOPICS: "kafeidou:2:0"
    KAFKA_ZOOKEEPER_CONNECT: zookeeper:2181
    KAFKA_LISTENERS: PLAINTEXT://0.0.0.0:9092
  volumes:
    - ./kafka-logs:/kafka
  depends_on:
    - zookeeper
- docker-compose.yml文件
注意:KAFKA_LISTENERS和KAFKA_ADVERTISED_LISTENERS中的ip是需要确认的。
- kafka客户端访问kafka是分两步走:
- 不管什么方式,客户端只要能连接到KAFKA_LISTENERS标识的地址,成功完成必要的认证后,就可以得到一个brokers返回地址。
- 通过返回的brokers重新建立和kafka的连接,生成producer/consumer。这个返回的brokers就是KAFKA_ADVERTISED_LISTENERS的值。
- kafka对这两个参数的说明:
- KAFKA_LISTENERS=PLAINTEXT://
: **定义kafka的服务监听地址**,addr可以为空,或者0.0.0.0,表示kafka服务会监听在指定地址。 - KAFKA_ADVERTISED_LISTENERS
kafka发布到zookeeper供客户端使用的服务地址,格式也是PLAINTEXT://
: ,但是addr不能为空。 - 如果KAFKA_ADVERTISED_LISTENERS没有定义,则是取的KAFKA_LISTENERS的值。
- 如果KAFKA_LISTENERS的addr没有定义,则取的java.net.InetAddress.getCanonicalHostName()值。
- KAFKA_LISTENERS=PLAINTEXT://
- 结合我们的例子:
- 容器内定义了:KAFKA_LISTENERS=PLAINTEXT://:9092 标识kafka服务运行在容器内的9092端口,因为没有指定host,所以是0.0.0.0标识所有的网络接口。
- 如果不定义KAFKA_ADVERTISED_LISTENERS 按缺省规则,等同于KAFKA_LISTENERS,即PLAINTEXT://:9092,但由于host不能为空,于是取java.net.InetAddress.getCanonicalHostName(),正好取到localhost。 于是在容器内和宿主机上都能通过地址localhost:9092访问kafka;但其实他们有本质的区别。
- 在宿主机上通过localhost:9092第一次访问kafka,这个localhost是宿主机,9092是映射到宿主机的端口,容器内的kafka服务接到访问请求后,把KAFKA_ADVERTISED_LISTENERS返回给客户端,其本意是我容器主机localhost和容器端口9092,而客户端接到这个返回brokers后重新解析了localhost为宿主机,和宿主机的端口;但他们正好因为映射了同样的端口,所以宿主机访问localhost然后宿主机又连到了容器的9092端口,这样就完成了合作。
- 如果需要在kafka容器内使用命令行测试收发消息,需要保障kafka容器内ip和host宿主机ip在同一网段,否则需要把KAFKA_ADVERTISED_LISTENERS设置为主机局域网ip地址,比如PLAINTEXT://192.168.147.168:9092。
- 修改配置:由于使用docker-compose安装,所以很方便修改,修改完,docker compose up -d 重新重启容器即可。
- 注意:kafka依赖于zk容器,所以需要先启动zk容器
- 应用
- 命令行模式
- 查看版本
# 从根路径查找包含kafka的文件名 $ find / -name \*kafka_\* | head -1 | grep -o '\kafka[^\n]*' # kafka版本号前面是scala版本,后面是kafka版本 kafka_2.13-2.7.1 # 安装路径位于/opt/kafka_2.13-2.7.1 - 文件
- 配置文件位于/opt/kafka_2.13-2.7.1/config,最重要的是server.properties。
- 执行脚本在/opt/kafka_2.13-2.7.1/bin中,比如kafka-server-start.sh。
- 版本可以在libs路径中的文件名中取得,如kafka-clients-2.7.1.jar。
- 命令
# 创建叫做“web_log” 的topic, 它有一个分区和一个副本
$ bin/kafka-topics.sh --create --bootstrap-server localhost:9092 --replication-factor 1 --partitions 1 --topic web_log
# 列出全部topic
$ bin/kafka-topics.sh --list --zookeeper localhost:2181
# 启动生产者,在交互模式下输入消息
$ bin/kafka-console-producer.sh --broker-list localhost:9092 --topic web_log
# 启动消费者,从开始部分消费,会将消息转储到标准输出
bin/kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic web_log --from-beginning
- 查看版本
- Go使用Shopify/sarama包 link
- 生产者 ```Go package main
import ( “fmt” “github.com/Shopify/sarama” )
// 基于sarama第三方库开发的kafka client
func main() { config := sarama.NewConfig() // 默认配置 config.Producer.RequiredAcks = sarama.WaitForAll // 发送完数据需要leader和follow都确认 config.Producer.Partitioner = sarama.NewRandomPartitioner // 新选出一个partition config.Producer.Return.Successes = true // 成功交付的消息将在success channel返回
// 构造一个消息 msg := &sarama.ProducerMessage{} msg.Topic = “web_log” msg.Value = sarama.StringEncoder(“this is a test log”) // 连接kafka client, err := sarama.NewSyncProducer([]string{“127.0.0.1:9092”}, config) if err != nil { fmt.Println(“producer closed, err:”, err) return } defer client.Close()
// 发送消息 pid, offset, err := client.SendMessage(msg) if err != nil { fmt.Println(“send msg failed, err:”, err) return } fmt.Printf(“partition_id:%v offset:%v\n”, pid, offset) }
- 消费者 ```Go package main import ( "fmt" "time" "github.com/Shopify/sarama" ) // kafka consumer func main() { consumer, err := sarama.NewConsumer([]string{"127.0.0.1:9092"}, nil) if err != nil { fmt.Printf("fail to start consumer, err:%v\n", err) return } partitionList, err := consumer.Partitions("web_log") // 根据topic取到所有的分区 if err != nil { fmt.Printf("fail to get list of partition:err%v\n", err) return } fmt.Println(partitionList) for partition := range partitionList { // 遍历所有的分区 // 针对每个分区创建一个对应的分区消费者 pc, err := consumer.ConsumePartition("web_log", int32(partition), sarama.OffsetOldest) // OffsetOldest表示取过去的消息 if err != nil { fmt.Printf("failed to start consumer for partition %d,err:%v\n", partition, err) return } defer pc.AsyncClose() // 异步从每个分区消费信息 go func(sarama.PartitionConsumer) { for msg := range pc.Messages() { fmt.Printf("Partition:%d Offset:%d Key:%v Value:%v", msg.Partition, msg.Offset, msg.Key, string(msg.Value)) } }(pc) } time.Sleep(time.Second * 1) // 延时,等待协程,要用wg代替 }- 其他例子 github
- kafka-go
- 命令行模式
- 场景分析
- 异步处理:异步处理是使用消息中间件的一个主要原因,在工作中最常见的异步场景有用户注册成功后需要发送注册成功邮件、缓存过期时先返回老的数据,然后异步更新缓存、异步写日志等等;通过异步处理,可以减少主流程的等待响应时间,让非主流程或者非重要业务通过消息中间件做集中的异步处理。
- 系统解耦:比如在电商系统中,当用户成功支付完成订单后,需要将支付结果给通知ERP系统、发票系统、WMS、推荐系统、搜索系统、风控系统等进行业务处理;这些业务处理不需要实时处理、不需要强一致,只需要最终一致性即可,因此可以通过消息中间件进行系统解耦。通过这种系统解耦还可以应对未来不明确的系统需求。
- 削峰填谷:当系统遇到大流量时,监控图上会看到一个一个的山峰样的流量图,通过使用消息中间件将大流量的请求放入队列,通过消费者程序将队列中的处理请求慢慢消化,达到消峰填谷的效果。最典型的场景是秒杀系统,在电商的秒杀系统中下单服务往往会是系统的瓶颈,因为下单需要对库存等做数据库操作,需要保证强一致性,此时使用消息中间件进行下单排队和流控,让下单服务慢慢把队列中的单处理完,保护下单服务,以达到削峰填谷的作用。
附加
深拷贝与浅拷贝
深拷贝(deep copy)的是数据本身,创造一个新对象,新对象与原对象不共享内存,新对象在内存中开辟一个新的内存地址,新对象值修改时不会影响原对象值。既然内存地址不同,释放内存地址时,可分别释放。
值类型的数据,默认全部都是深复制,Array、Int、String、Struct、Float,Bool。
浅拷贝(Shallow Copy)拷贝的是数据地址,只复制指向的对象的指针,此时新对象和老对象指向的内存地址是一样的,新对象值修改时老对象也会变化。释放内存地址时,同时释放内存地址。
引用类型的数据,默认全部都是浅复制,Slice,Map。
package main

import (
  "fmt"
  "reflect"
)

func main() {
  s1 := 1
  s2 := &s1
  s3 := s1
  fmt.Println(s1)
  fmt.Println(s2)
  fmt.Println(*s2)
  fmt.Println(reflect.TypeOf(s1))
  fmt.Println(reflect.TypeOf(s2)) // s2被自动声明为*int类型,注意不是int*

  *s2 = 2 // 注意s2是*int类型,不能被赋值为2。所以需要用地址取对应的值再修改。也就是修改了s1内存中的数值。
  fmt.Println(s1)
  fmt.Println(s2)
  s1 = 10
  fmt.Println(s1)
  fmt.Println(s2)
  fmt.Println(*s2)

  s3 = 3
  fmt.Println(s1)
  fmt.Println(s3)
}

/*
输出:
1
0xc000016060
int
*int

2
0xc000016060
10
0xc000016060
10

10
3
*/