cbirdcn.github.io
http://www.zhzq.site
服务端重点-详情
计算机理论与实践
操作系统与网络
OS面试 OS面试 OS面试 网络面试 网络面试 网络面试 TCP/IP协议
网络协议
介绍一下OSI七层模型和TCP五层模型,及每层涉及协议
OSI七层模型从上到下依次为:
- 应用层:为应用程序提供网络服务;如HTTP,FTP,POP3,TELNET,DNS以及DHCP,BOOTP,SSL
- 表示层:数据格式转换、数据压缩和数据加密;
- 会话层:建立、断开和维护通信链接;
- 传输层:为上层协议提供端到端的可靠传输;TCP,UDP
- 网络层:寻址和路由;IP协议包含众多,如多播IGMP,地址解析ARP,认证AH,控制消息(网络、路由检测)ICMP
- 数据链路层:定义通过通信媒介互连的设备之间传输的规范;IEEE802.X包含:点对点隧道PPTP,VPN第二层通道L2TP,以太网上点对点PPPoE等
- 物理层:利用物理传输介质为数据链路层提供物理连接。
TCP五层模型相比OSI七层模型,将OSI的应用层、表示层和会话层合为一层:应用层,其他不变。

TCP/IP协议简介
是利用 IP 进行通信时所必须用到的协议群的统称。IP 或 ICMP、TCP 或 UDP、TELNET 或 FTP、以及 HTTP 等都属于 TCP/IP 协议。
数据包:
每个分层中,都会对所发送的数据附加一个首部。
在这个首部中包含了该层必要的信息,如发送的目标地址以及协议相关信息。
通常,为协议提供的信息为包首部,所要发送的内容为数据。
在下一层的角度看,从上一层收到的包全部都被认为是本层的数据。
首部的结构由协议的具体规范详细定义。
在数据包的首部,明确标明了协议应该如何读取数据。

数据处理流程:
如图

其中:
IP 模块的处理:
    IP 模块接收到 数据后,从包首部中判断此 IP 地址是否与自己的 IP 地址匹配
    如果匹配则根据首部的协议类型将数据发送给对应的模块,如 TCP、UDP。
    对于有路由器的情况,接收端地址往往不是自己的地址。
    此时,需要借助路由控制表,在调查应该送往的主机或路由器之后再进行转发数据。
TCP 模块的处理:
    首先会计算一下校验和,判断数据是否被破坏。
    然后检查是否在按照序号接收数据。
    检查端口号,确定具体的应用程序。
    数据被完整地接收以后,会传给由端口号识别的应用程序。
传输层中的 TCP 和 UDP
传输层协议有两个,分别是 TCP 和 UDP
简介与比较:
TCP是面向连接的、可靠的流协议。
流就是指不间断的数据结构。
当应用程序采用TCP发送消息时,虽然可以保证发送的顺序,但还是犹如没有任何间隔的数据流发送给接收端。
TCP为提供可靠性传输,实行“顺序控制”或“重发控制”机制。
此外还具备“流控制(流量控制)”、“拥塞控制”、提高网络利用率等众多功能。

UDP是不具有可靠性的数据报协议。
细微的处理它会交给上层的应用去完成。
在UDP的情况下,虽然可以确保发送消息的大小,却不能保证消息一定会到达。
因此,应用有时会根据自己的需要进行重发处理。

TCP和UDP的优缺点无法简单地、绝对地去做比较:
    TCP用于在传输层有必要实现可靠传输的情况;
    而在一方面,UDP主要用于那些对高速传输和实时性有较高要求的通信或广播通信。
    TCP和UDP应该根据应用的目的按需使用。
根据端口号识别应用:
数据链路和 IP 中的地址,分别指的是 MAC 地址和 IP 地址。
前者用来识别同一链路中不同的计算机,后者用来识别 TCP/IP 网络中互连的主机和路由器。
在传输层也有这种类似于地址的概念,那就是端口号。
端口号用来识别同一台计算机中进行通信的不同应用程序。
常用端口号:http80,ftp21,ssh22
知名端口号:分布在0~1023之间
其他端口号:1024~49151之间,可用于任何通信用途。
识别一个通信:

UDP详细:
UDP 不提供复杂的控制机制,利用IP提供面向无连接的通信服务。
并且它是将应用程序发来的数据在收到的那一刻,立即按照原样发送到网络上的一种机制。
即使是出现网络拥堵的情况,UDP也无法进行流量控制等避免网络拥塞行为。
此外,传输途中出现丢包,UDP 也不负责重发。
甚至当包的到达顺序出现乱序时也没有纠正的功能。

UDP 常用于以下几个方面:
    1.包总量较少的通信(DNS、SNMP等);
    2.视频、音频等多媒体通信(即时通信);
    3.限定于LAN等特定网络中的应用通信;
    4.广播通信(广播、多播)。
TCP详细:
TCP与UDP的区别相当大。
它充分地实现了数据传输时各种控制功能,可以进行丢包时的重发控制,还可以对次序乱掉的分包进行顺序控制。
而这些在 UDP 中都没有。
此外,TCP 作为一种面向有连接的协议,只有在确认通信对端存在时才会发送数据,从而可以控制通信流量的浪费。
根据 TCP 的这些机制,在IP这种无连接的网络上也能够实现高可靠性的通信( 主要通过检验和、序列号、确认应答、重发控制、连接管理以及窗口控制等机制实现)。
TCP三次握手:
TCP 提供面向有连接的通信传输。
面向有连接是指在数据通信开始之前先做好两端之间的准备工作。
所谓三次握手是指建立一个TCP连接时需要客户端和服务器端总共发送三个包以确认连接的建立。
在socket编程中,这一过程由客户端执行connect来触发。

第一次握手:客户端将标志位SYN置为1,随机产生一个值seq=J,并将该数据包发送给服务器端,客户端进入SYN_SENT状态,等待服务器端确认。
第二次握手:服务器端收到数据包后由标志位SYN=1知道客户端请求建立连接,服务器端将标志位SYN和ACK都置为1,ack=J+1,随机产生一个值seq=K,并将该数据包发送给客户端以确认连接请求,服务器端进入SYN_RCVD状态。
第三次握手:客户端收到确认后,检查ack是否为J+1,ACK是否为1,如果正确则将标志位ACK置为1,ack=K+1,并将该数据包发送给服务器端,服务器端检查ack是否为K+1,ACK是否为1,如果正确则连接建立成功,客户端和服务器端进入ESTABLISHED状态,完成三次握手,随后客户端与服务器端之间可以开始传输数据了。
TCP四次握手:
四次挥手即终止TCP连接,就是指断开一个TCP连接时,需要客户端和服务端总共发送4个包以确认连接的断开。
在socket编程中,这一过程由客户端或服务端任一方执行close来触发。
由于TCP连接是全双工的,因此,每个方向都必须要单独进行关闭。
这一原则是当一方完成数据发送任务后,发送一个FIN来终止这一方向的连接,收到一个FIN只是意味着这一方向上没有数据流动了,即不会再收到数据了,但是在这个TCP连接上仍然能够发送数据,直到这一方向也发送了FIN。
首先进行关闭的一方将执行主动关闭,而另一方则执行被动关闭。

中断连接端可以是客户端,也可以是服务器端。
第一次挥手:客户端发送一个FIN=M,用来关闭客户端到服务器端的数据传送,客户端进入FIN_WAIT_1状态。意思是说"我客户端没有数据要发给你了",但是如果你服务器端还有数据没有发送完成,则不必急着关闭连接,可以继续发送数据。
第二次挥手:服务器端收到FIN后,先发送ack=M+1,告诉客户端,你的请求我收到了,但是我还没准备好,请继续你等我的消息。这个时候客户端就进入FIN_WAIT_2状态,继续等待服务器端的FIN报文。
第三次挥手:当服务器端确定数据已发送完成,则向客户端发送FIN=N报文,告诉客户端,好了,我这边数据发完了,准备好关闭连接了。服务器端进入LAST_ACK状态。
第四次挥手:客户端收到FIN=N报文后,就知道可以关闭连接了,但是他还是不相信网络,怕服务器端不知道要关闭,所以发送ack=N+1后进入TIME_WAIT状态,如果Server端没有收到ACK则可以重传。服务器端收到ACK后,就知道可以断开连接了。客户端等待了2MSL后依然没有收到回复,则证明服务器端已正常关闭,那好,我客户端也可以关闭连接了。最终完成了四次握手。
TCP 有哪些状态、time-wait的作用?link
- 表示收到了对方的FIN报文,并发送出了ACK报文。
- TIME_WAIT状态下的TCP连接会等待2*MSL(Max Segment Lifetime,最大分段生存期,指一个TCP报文在Internet上的最长生存时间。
- 每个具体的TCP协议实现都必须选择一个确定的MSL值,RFC 1122建议是2分钟,但BSD传统实现采用了30秒,Linux可以cat /proc/sys/net/ipv4/tcp_fin_timeout看到本机的这个值),然后即可回到CLOSED 可用状态了。
- 如果FIN_WAIT_1状态下,收到了对方同时带FIN标志和ACK标志的报文时,可以直接进入到TIME_WAIT状态,而无须经过FIN_WAIT_2状态。(这种情况应该就是四次挥手变成三次挥手的那种情况)
通过序列号与确认应答提高可靠性:
- 在 TCP 中,当发送端的数据到达接收主机时,接收端主机会返回一个已收到消息的通知。这个消息叫做确认应答(ACK)。
- 当发送端将数据发出之后会等待对端的确认应答。如果有确认应答,说明数据已经成功到达对端。反之,则数据丢失的可能性很大。
- 在一定时间内没有等待到确认应答,发送端就可以认为数据已经丢失,并进行重发。由此,即使产生了丢包,仍然能够保证数据能够到达对端,实现可靠传输。
- 未收到确认应答并不意味着数据一定丢失。也有可能是数据对方已经收到,只是返回的确认应答在途中丢失。这种情况也会导致发送端误以为数据没有到达目的地而重发数据。
- 此外,也有可能因为一些其他原因导致确认应答延迟到达,在源主机重发数据以后才到达的情况也屡见不鲜。此时,源主机只要按照机制重发数据即可。
- 对于目标主机来说,反复收到相同的数据是不可取的。为了对上层应用提供可靠的传输,目标主机必须放弃重复的数据包。为此我们引入了序列号。
- 序列号是按照顺序给发送数据的每一个字节(8位字节)都标上号码的编号。接收端查询接收数据 TCP 首部中的序列号和数据的长度,将自己下一步应该接收的序列号作为确认应答返送回去。通过序列号和确认应答号,TCP 能够识别是否已经接收数据,又能够判断是否需要接收,从而实现可靠传输。
重发超时的确定:
- 重发超时是指在重发数据之前,等待确认应答到来的那个特定时间间隔。如果超过这个时间仍未收到确认应答,发送端将进行数据重发。最理想的是,找到一个最小时间,它能保证“确认应答一定能在这个时间内返回”。
- TCP 要求不论处在何种网络环境下都要提供高性能通信,并且无论网络拥堵情况发生何种变化,都必须保持这一特性。为此,它在每次发包时都会计算往返时间及其偏差。将这个往返时间和偏差时间相加,重发超时的时间就是比这个总和要稍大一点的值。
- 在 BSD 的 Unix 以及 Windows 系统中,超时都以0.5秒为单位进行控制,因此重发超时都是0.5秒的整数倍。
- 数据被重发之后若还是收不到确认应答,则进行再次发送。此时,等待确认应答的时间将会以2倍、4倍的指数函数延长。
- 此外,数据也不会被无限、反复地重发。达到一定重发次数之后,如果仍没有任何确认应答返回,就会判断为网络或对端主机发生了异常,强制关闭连接。并且通知应用通信异常强行终止。
利用窗口控制提高速度:
- 段:在建立 TCP 连接的同时,也可以确定发送数据包的单位,我们也可以称其为“最大消息长度”(MSS)。最理想的情况是,最大消息长度正好是 IP 中不会被分片处理的最大数据长度。
- TCP 以1个段为单位,每发送一个段进行一次确认应答的处理。这样的传输方式有一个缺点,就是包的往返时间越长通信性能就越低。
- 为解决这个问题,TCP 引入了窗口这个概念。确认应答不再是以每个分段,而是以更大的单位进行确认,转发时间将会被大幅地缩短。也就是说,发送端主机,在发送了一个段以后不必要一直等待确认应答,而是继续发送。如图:

- 窗口控制:窗口大小就是指无需等待确认应答而可以继续发送数据的最大值。上图中窗口大小为4个段。这个机制实现了使用大量的缓冲区,通过对多个段同时进行确认应答的功能。
滑动窗口控制:

- 上图中的窗口内的数据即便没有收到确认应答也可以被发送出去。不过,在整个窗口的确认应答没有到达之前,如果其中部分数据出现丢包,那么发送端仍然要负责重传。为此,发送端主机需要设置缓存保留这些待被重传的数据,直到收到他们的确认应答。
- 在滑动窗口以外的部分包括未发送的数据以及已经确认对端已收到的数据。当数据发出后若如期收到确认应答就可以不用再进行重发,此时数据就可以从缓存区清除。
- 收到确认应答的情况下,将窗口滑动到确认应答中的序列号的位置。这样可以顺序地将多个段同时发送提高通信性能。这种机制也别称为滑动窗口控制。
窗口控制中的重发控制:
在使用窗口控制中, 出现丢包一般分为两种情况:
- 确认应答未能返回的情况。在这种情况下,数据已经到达对端,是不需要再进行重发的。可以通过下一个确认应答进行确认。

- 某个报文段丢失的情况。接收主机如果收到一个自己应该接收的序列号以外的数据时,会针对当前为止收到数据返回确认应答。如下图所示,当某一报文段丢失后,发送端会一直收到序号为1001的确认应答,因此,在窗口比较大,又出现报文段丢失的情况下,同一个序列号的确认应答将会被重复不断地返回。而发送端主机如果连续3次收到同一个确认应答,就会将其对应的数据进行重发。这种机制比之前提到的超时管理更加高效,因此也被称为高速重发控制。
TCP粘包是什么?怎么解决这个问题? link
- TCP粘包就是指发送方发送的若干包数据到达接收方时粘成了一包,从接收缓冲区来看,后一包数据的头紧接着前一包数据的尾
- 出现粘包的原因是多方面的,可能是来自发送方,也可能是来自接收方。
- 发送方原因。TCP默认使用Nagle算法(主要作用:减少网络中报文段的数量),而Nagle算法主要做两件事:
- 只有上一个分组得到确认,才会发送下一个分组
- 收集多个小分组,在一个确认到来时一起发送
- 接收方原因。TCP接收到数据包时,并不会马上交到应用层进行处理,或者说应用层并不会立即处理。TCP将接收到的数据包保存在接收缓存里,然后应用程序主动从缓存读取收到的分组。如果TCP接收数据包到缓存的速度大于应用程序从缓存中读取数据包的速度,多个包就会被缓存,应用程序就有可能读取到多个首尾相接粘到一起的包。
- 什么时候需要处理粘包现象?如果发送方发送的多组数据本来就是同一块数据的不同部分,不处理。如果多个分组毫不相干,要处理
- 如何处理?
- 发送方造成的粘包问题,可以通过关闭Nagle算法来解决,使用TCP_NODELAY选项来关闭算法。
- 接收方没有办法来处理粘包现象,只能将问题交给应用层来处理。
- 应用层解决粘包:不仅能解决接收方的粘包问题,还可以解决发送方的粘包问题。
- 解决办法:循环处理,应用程序从接收缓存中读取分组时,读完一条数据,就应该循环读取下一条数据,直到所有数据都被处理完成,但是如何判断每条数据的长度呢?
- 格式化数据:每条数据有固定的格式(开始符,结束符),这种方法简单易行,但是选择开始符和结束符时一定要确保每条数据的内部不包含开始符和结束符。
- 发送长度:发送每条数据时,将数据的长度一并发送,例如规定数据的前4位是数据的长度,应用层在处理时可以根据长度来判断每个分组的开始和结束位置。
- 解决办法:循环处理,应用程序从接收缓存中读取分组时,读完一条数据,就应该循环读取下一条数据,直到所有数据都被处理完成,但是如何判断每条数据的长度呢?
- UDP会不会产生粘包问题呢?
- 保护消息边界:指传输协议把数据当做一条独立的消息在网上传输,接收端一次只能接受一条独立的消息
- TCP为了保证可靠传输并减少额外的开销(每次发包都要验证),采用了基于流的传输,基于流的传输不认为消息是一条一条的,是无保护消息边界的。
- UDP则是面向消息传输的,是有保护消息边界的,接收方一次只接受一条独立的信息,所以不存在粘包问题。
- 举个例子:有三个数据包,大小分别为2k、4k、6k,如果采用UDP发送的话,不管接受方的接收缓存有多大,我们必须要进行至少三次以上的发送才能把数据包发送完,但是使用TCP协议发送的话,我们只需要接受方的接收缓存有12k的大小,就可以一次把这3个数据包全部发送完毕。
建立TCP服务器的各个系统调用过程是怎样的? link
todo
TCP 协议如何保证可靠传输?
- 校验和
- 在数据传输的过程中,将发送的数据段都当做一个16位的整数。将这些整数加起来。并且前面的进位不能丢弃,补在后面,最后取反,得到校验和。
- 接收方求收到数据,出校验和,与发送方的进行比对
- 序列号与确认应答
- TCP传输时将每个字节的数据都进行了编号.
- 每次接收方收到数据后,都会对传输方进行确认应答。也就是发送ACK报文。这个ACK报文当中带有对应的确认序列号,告诉发送方,接收到了哪些数据,下一次的数据从哪里发。
- 序列号的作用不仅仅是应答的作用,有了序列号能够将接收到的数据根据序列号排序,并且去掉重复序列号的数据。
- 超时重传
- 发送方没有接收到响应的ACK报文
- 连接管理
- 三握四挥
- 流量控制
- 接收端在接收到数据后,对其进行处理。如果发送端的发送速度太快,导致接收端的结束缓冲区很快的填充满了。此时如果发送端仍旧发送数据,那么接下来发送的数据都会丢包,继而导致丢包的一系列连锁反应,超时重传呀什么的。而TCP根据接收端对数据的处理能力,决定发送端的发送速度,这个机制就是流量控制。
- 在TCP协议的报头信息当中,有一个16位字段的窗口大小。窗口大小的内容实际上是接收端接收数据缓冲区的剩余大小。这个数字越大,证明接收端接收缓冲区的剩余空间越大,网络的吞吐量越大。接收端会在确认应答发送ACK报文时,将自己的即时窗口大小填入,并跟随ACK报文一起发送过去。而发送方根据ACK报文里的窗口大小的值的改变进而改变自己的发送速度。
- 拥塞控制
- TCP传输的过程中,发送端开始发送数据的时候,如果刚开始就发送大量的数据,那么就可能造成一些问题。网络可能在开始的时候就很拥堵,如果给网络中在扔出大量数据,那么这个拥堵就会加剧。拥堵的加剧就会产生大量的丢包,就对大量的超时重传,严重影响传输。只拥有一点在运行中必不可少的资源(如程序计数器,一组寄存器和栈),但是它可与同属一个进程的其他的线程共享进程所拥有的全部资源只拥有一点在运行中必不可少的资源(如程序计数器,一组寄存器和栈),但是它可与同属一个进程的其他的线程共享进程所拥有的全部资源
- 所以TCP引入了慢启动的机制,在开始发送数据时,先发送少量的数据探路。探清当前的网络状态如何,再决定多大的速度进行传输。这时候就引入一个叫做拥塞窗口的概念。
- 发送刚开始定义拥塞窗口为 1,每次收到ACK应答,拥塞窗口加 1。在发送数据之前,首先将拥塞窗口与接收端反馈的窗口大小比对,取较小的值作为实际发送的窗口。
- 拥塞窗口的增长是指数级别的。慢启动的机制只是说明在开始的时候发送的少,发送的慢,但是增长的速度是非常快的。为了控制拥塞窗口的增长,不能使拥塞窗口单纯的加倍,设置一个拥塞窗口的阈值,当拥塞窗口大小超过阈值时,不能再按照指数来增长,而是线性的增长。
RTO,RTT和超时重传(自动重传ARQ)?
- RTO(Retransmission TimeOut)即重传超时时间
- TCP超时与重传中一个最重要的部分是对一个给定连接的往返时间(RTT)的测量。由于网络流量的变化,这个时间会相应地发生改变,TCP需要跟踪这些变化并动态调整超时时间RTO。
网络层中的IP协议
网络层的主要作用是“实现终端节点之间的通信”。这种终端节点之间的通信也叫“点对点通信”。
网络的下一层——数据链路层的主要作用是在互连同一种数据链路的节点之间进行包传递。而一旦跨越多种数据链路,就需要借助网络层。网络层可以跨越不同的数据链路,即使是在不同的数据链路上也能实现两端节点之间的数据包传输。
IP 大致分为三大作用模块,它们是 IP 寻址、路由(最终节点为止的转发)以及 IP 分包与组包。
IP地址:
- IP 地址(IPv4 地址)由32位正整数来表示。IP 地址在计算机内部以二进制方式被处理。然而,由于我们并不习惯于采用二进制方式,我们将32位的 IP 地址以每8位为一组,分成4组,每组以 “.” 隔开,再将每组数转换成十进制数。
- IP 地址由网络和主机两部分标识组成。网络标识(如192.168.0.)在数据链路的每个段配置不同的值。网络标识必须保证相互连接的每个段的地址不相重复。而相同段内相连的主机必须有相同的网络地址。IP 地址的“主机标识”(0-255)则不允许在同一个网段内重复出现。由此,可以通过设置网络地址和主机地址,在相互连接的整个网络中保证每台主机的 IP 地址都不会相互重叠。即 IP 地址具有了唯一性。
- 广播:广播地址用于在同一个链路中相互连接的主机之间发送数据包。将 IP 地址中的主机地址部分全部设置为 1,就成了广播地址。
- 多播用于将包发送给特定组内的所有主机。由于其直接使用 IP 地址,因此也不存在可靠传输。相比于广播,多播既可以穿透路由器,又可以实现只给那些必要的组发送数据包。
- 子网掩码:将原网络分为多个物理网络的一种机制。
路由控制:
- 发送数据包时所使用的地址是网络层的地址,即 IP 地址。然而仅仅有 IP 地址还不足以实现将数据包发送到对端目标地址,在数据发送过程中还需要类似于“指明路由器或主机”的信息,以便真正发往目标地址。保存这种信息的就是路由控制表。
- 路由控制表的形成方式有两种:一种是管理员手动设置,另一种是路由器与其他路由器相互交换信息时自动刷新。前者也叫做静态路由控制,而后者叫做动态路由控制。
IP 协议相关:
- IP 旨在让最终目标主机收到数据包,但是在这一过程中仅仅有 IP 是无法实现通信的。必须还有能够解析主机名称和 MAC 地址的功能,以及数据包在发送过程中异常情况处理的功能。
- DNS(Domain Name System)可以将字符串(域名)自动转换为具体的 IP 地址。
- ARP:在底层数据链路层,进行实际通信时却有必要了解每个 IP 地址所对应的 MAC 地址。ARP 是一种解决地址问题的协议。以目标 IP 地址为线索,用来定位下一个应该接收数据分包的网络设备对应的 MAC 地址。不过 ARP 只适用于 IPv4,不能用于 IPv6。
- ICMP:主要包括,确认IP包是否成功送达目标地址,通知在发送过程当中IP包被废弃的具体原因,改善网络设置等。
- DHCP(Dynamic Host Configuration Protocol):自动设置 IP 地址、统一管理 IP 地址分配
- NAT(Network Address Translator):用于在本地网络中使用私有地址,在连接互联网时转而使用全局 IP 地址的技术。
HTTP与HTTPS
简介:
HTTP是一个基于TCP/IP通信协议来传递数据的协议。HTTP协议工作于客户端-服务端架构之上,实现可靠性的传输文字、图片、音频、视频等超文本数据的规范,格式简称为“超文本传输协议”。Http协议属于应用层,用户访问的第一层就是http。
特点:
特点:
- 简单快速:客户端向服务器发送请求时,只需传送请求方法和路径即可。
- 灵活:HTTP允许传输任意类型的数据对象。
- 无连接:限制每次连接只处理一个请求。服务器处理完客户请求,并收到客户应答后,即断开连接。
- 无状态:协议对于事务处理没有记忆能力。
- 支持B/S及C/S模式。
Http和Https的区别?
- 端口不同:Http是80,Https443
- 安全性:http是超文本传输协议,信息是明文传输,https则是通过SSL加密处理的传输协议,更加安全。
- 是否付费:https需要拿到CA证书,需要付费
- 连接方式:http和https使用的是完全不同的连接方式(HTTP的连接很简单,是无状态的;HTTPS协议是由SSL+HTTP协议构建的可进行加密传输、身份认证的网络协议,比http协议安全,但多了一层SSL延时也会有所提高。)
HTTPS工作原理?
- 首先HTTP请求服务端生成证书,客户端对证书的有效期、合法性、域名是否与请求的域名一致、证书的公钥(RSA加密)等进行校验;
- 客户端如果校验通过后,就根据证书的公钥的有效, 生成随机数,随机数使用公钥进行加密(RSA加密);
- 消息体产生的后,对它的摘要进行MD5(或者SHA1)算法加密,此时就得到了RSA签名;
- 发送给服务端,此时只有服务端(RSA私钥)能解密。
- 解密得到的随机数,再用AES加密,作为密钥(此时的密钥只有客户端和服务端知道)。
加密算法?
对称加密,如 AES
基本原理:将明文分成 N 个组,然后使用密钥对各个组进行加密,形成各自的密文,最后把所有的分组密文进行合并,形成最终的密文。
优点:算法公开、计算量小、加密速度快、加密效率高
缺点:双方都使用同样密钥,安全性得不到保证

非对称加密,如 RSA
基本原理:同时生成两把密钥:私钥和公钥,私钥隐秘保存,公钥可以下发给信任客户端
私钥加密,持有私钥或公钥才可以解密
公钥加密,持有私钥才可解密
优点:安全,难以破解
缺点:算法比较耗时

不可逆加密,如 MD5,SHA
基本原理:加密过程中不需要使用密钥,输入明文后由系统直接经过加密算法处理成密文。
这种加密后的数据是无法被解密的,无法根据密文推算出明文。
一次完整的HTTP请求所经历几个步骤?
HTTP协议采用请求/响应模型。客户端向服务器发送一个请求报文,请求报文包含请求方法、URL、协议版本、请求头部和请求数据。服务器以一个状态行作为响应,响应内容包括协议版本、成功或者错误的代码、服务器信息、响应头部和响应数据。
Web浏览器与Web服务器之间将完成下列7个步骤:
- 建立TCP连接,三次握手
- Web浏览器向Web服务器发送请求行
- Web浏览器发送请求头,浏览器发送其请求命令之后,还要以头信息的形式向Web服务器发送一些别的信息,之后浏览器发送了一空白行来通知服务器,它已经结束了该头信息的发送。
- Web服务器应答:客户机向服务器发出请求后,服务器会客户机回送应答, HTTP/1.1 200 OK ,应答的第一部分是协议的版本号和应答状态码。
- Web服务器发送应答头:正如客户端会随同请求发送关于自身的信息一样,服务器也会随同应答向用户发送关于它自己的数据及被请求的文档。
- Web服务器向浏览器发送数据:Web服务器向浏览器发送头信息后,它会发送一个空白行来表示头信息的发送到此为结束,接着,它就以Content-Type应答头信息所描述的格式发送用户所请求的实际数据。
- Web服务器关闭TCP连接
HTTP请求和响应报文?
todo
输入网址到获取页面的过程?
- 浏览器搜索自身的DNS缓存、搜索操作系统的DNS缓存、读取本地的Host文件和向本地DNS服务器进行查询等。
- 对于向本地DNS服务器进行查询,如果要查询的域名包含在本地配置区域资源中,则返回解析结果给客户机,完成域名解析(此解析具有权威性);如果要查询的域名不由本地DNS服务器区域解析,但该服务器已缓存了此网址映射关系,则调用这个IP地址映射,完成域名解析(此解析不具有权威性)。如果本地域名服务器并未缓存该网址映射关系,那么将根据其设置发起递归查询或者迭代查询;
- 浏览器获得域名对应的IP地址以后,浏览器向服务器请求建立链接,发起三次握手;
- TCP/IP链接建立起来后,浏览器向服务器发送HTTP请求;
- 服务器接收到这个请求,并根据路径参数映射到特定的请求处理器进行处理,并将处理结果及相应的视图返回给浏览器;
- 浏览器解析并渲染视图,若遇到对js文件、css文件及图片等静态资源的引用,则重复上述步骤并向服务器请求这些资源;
- 浏览器根据其请求到的资源、数据渲染页面,最终向用户呈现一个完整的页面
http版本的对比?
-
HTTP1.0版本的特性:
- 早先1.0的HTTP版本,是一种无状态、无连接的应用层协议。(短连接)
- HTTP1.0规定浏览器和服务器保持短暂的连接,浏览器的每次请求都需要与服务器建立一个TCP连接,服务器处理完成后立即断开TCP连接(无连接),服务器不跟踪每个客户端也不记录过去的请求(无状态)。
-
HTTP1.1版本新特性(长连接):
- 默认持久连接节省通信量
- 只要客户端服务端任意一端没有明确提出断开TCP连接,就一直保持连接,可以发送多次HTTP请求管线化,客户端可以同时发出多个HTTP请求,而不用一个个等待响应断点续传原理
-
HTTP2.0版本的特性:
- 二进制分帧(采用二进制格式的编码将其封装)
- 首部压缩(设置了专门的首部压缩设计的HPACK算法。)
- 流量控制(设置了接收某个数据流的多少字节一些流量控制)
- 多路复用(可以在共享TCP链接的基础上同时发送请求和响应)
- 请求优先级(可以通过优化这些帧的交错和传输顺序进一步优化性能)
- 服务器推送(就是服务器可以对一个客户端请求发送多个响应。服务器向客户端推送资源无需客户端明确的请求。(重大更新))
HTTP Keep-Alive是什么?如何工作?link
- 在http早期,每个http请求都要求打开一个tpc socket连接,并且使用一次之后就断开这个tcp连接。
- 使用keep-alive可以改善这种状态,即在一次TCP连接中可以持续发送多份数据而不会断开连接。通过使用keep-alive机制,可以减少tcp连接建立次数,也意味着可以减少TIME_WAIT状态连接,以此提高性能和提高httpd服务器的吞吐率(更少的tcp连接意味着更少的系统内核调用,socket的accept()和close()调用)。
- 但是,keep-alive并不是免费的午餐,长时间的tcp连接容易导致系统资源无效占用。配置不当的keep-alive,有时比重复利用连接带来的损失还更大。所以,正确地设置keep-alive timeout时间非常重要。
- Httpd守护进程,一般都提供了keep-alive timeout时间设置参数。比如nginx的keepalive_timeout,和Apache的KeepAliveTimeout。
http keep-alive与tcp keep-alive:
- http keep-alive是为了让tcp活得更久一点,以便在同一个连接上传送多个http,提高socket的效率。
- tcp keep-alive是TCP的一种检测TCP连接状况的保鲜机制。
- 当网络两端建立了TCP连接之后,闲置idle(双方没有任何数据流发送往来)了tcp_keepalive_time后,服务器内核就会尝试向客户端发送侦测包,来判断TCP连接状况(有可能客户端崩溃、强制关闭了应用、主机不可达等等)。如果没有收到对方的回答(ack包),则会在 tcp_keepalive_intvl后再次尝试发送侦测包,直到收到对对方的ack,如果一直没有收到对方的ack,一共会尝试 tcp_keepalive_probes次,每次的间隔时间在这里分别是15s, 30s, 45s, 60s, 75s。如果尝试tcp_keepalive_probes,依然没有收到对方的ack包,则会丢弃该TCP连接。TCP连接默认闲置时间是2小时,一般设置为30分钟足够了。
keep-alive与TIME_WAIT:
- 使用http keep-alvie,可以减少服务端TIME_WAIT数量(因为由服务端httpd守护进程主动关闭连接)
- 启用keep-alive,建立的tcp连接更少了,自然要被关闭的tcp连接也相应更少了。

常用HTTP状态码是怎么分类的,有哪些常见的状态码?
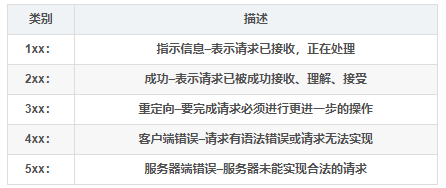
常用状态码:
200: 请求被正常处理
204: 请求被受理但没有资源可以返回
301: 永久性重定向
302: 临时重定向
304: 已缓存
400: 请求报文语法有误,服务器无法识别
403: 请求的对应资源禁止被访问
404: 服务器无法找到对应资源
500: 服务器内部错误
503: 服务器正忙
todo,认证等
HTTP协议中的请求方式(动词,Method)?
- GET:用于请求访问已经被URI(统一资源标识符)识别的资源,可以通过URL传参给服务器
- POST:用于传输信息给服务器,主要功能与GET方法类似,但一般推荐使用POST方式。
- PUT: 传输文件,报文主体中包含文件内容,保存到对应URI位置。
- HEAD:获得报文首部,与GET方法类似,只是不返回报文主体,一般用于验证URI是否有效。
- PATCH: 客户端向服务器传送的数据取代指定的文档的内容(部分取代)
- TRACE: 回显客户端请求服务器的原始请求报文,用于”回环”诊断
- DELETE: 删除文件,与PUT方法相反,删除对应URI位置的文件。
- OPTIONS: 查询相应URI支持的HTTP方法。
RESTful API中http method的含义?
todo
GET方法与POST方法的区别?
- 功能上: GET一般用来从服务器上获取资源,POST一般用来更新服务器上的资源;
- 安全性: GET是不安全的,因为GET请求提交的数据将明文出现在URL上(请求头上),可能会泄露私密信息;POST请求参数则被包装到请求体中,相对更安全。
- 数据量: Get传输的数据量小,因为受URL长度限制,但效率较高; Post可以传输大量数据,所以上传文件时只能用Post方式;
Session 与 Cookie 的对比?
HTTP协议本身是无状态的,无法判断用户身份。所以需要cookie或者session。
cookie:
- cookie是由Web服务器保存在用户浏览器上的文件(key-value格式),可以包含用户相关的信息。
- 客户端向服务器发起请求时,会携带服务端之前创建的cookie,服务端通过cookie中携带的数据区分不同的用户。
session:
- session 是浏览器和服务器会话过程中,服务器会分配的一块储存空间给session。
- 服务器默认会为客户浏览器的cookie中设置sessionid,这个sessionid就和cookie对应,浏览器在向服务器请求过程中传输的cookie 包含 sessionid ,服务器根据传输cookie 中的 sessionid 获取出会话中存储的信息,然后确定会话的身份信息。
比较:
- 安全性:cookie数据存放在客户端上,安全性较差,session数据放在服务器上,安全性相对更高
- 大小限制:cookie有大小限制,单个cookie保存的数据不能超过4K,session无此限制,理论上只与服务器的内存大小有关;
- 服务器资源消耗:Session是保存在服务器端上会存在一段时间才会消失,当访问增多,对服务器性能有影响
- 实现机制:Session的实现常常依赖于Cookie机制,通过Cookie机制回传SessionID;
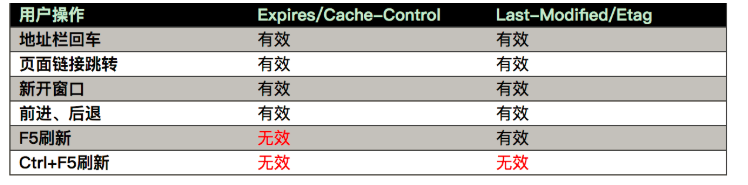
http强缓存与协商缓存? link
浏览器第一次向一个web服务器发起http请求后,服务器会返回请求的资源,并且在响应头中添加一些有关缓存的字段如:Cache-Control、Expires、Last-Modified、ETag、Date等等。之后浏览器再向该服务器请求该资源就可以视情况使用强缓存和协商缓存。
- 强缓存:浏览器直接从本地缓存中获取数据,不与服务器进行交互。
- 协商缓存:浏览器发送请求到服务器,服务器判定是否可使用本地缓存。
- 联系与区别:两种缓存方式最终使用的都是本地缓存;前者无需与服务器交互,后者需要。
强缓存-几个Cache-Control的常用指令:
- no-cache:含义是不使用本地缓存,需要使用协商缓存,也就是先与服务器确认缓存是否可用。
- no-store:禁用缓存。
- public:表明其他用户也可使用缓存,适用于公共缓存服务器的情况。
- private:表明只有特定用户才能使用缓存,适用于公共缓存服务器的情况。
若缓存未过期,返回状态码为200,则直接从本地读取缓存。如果缓存过期,则进入协商缓存或服务器返回新资源过程
协商缓存:
当浏览器发现缓存过期后,缓存并不一定不能使用了,因为服务器端的资源可能仍然没有改变,所以需要与服务器协商,让服务器判断本地缓存是否还能使用。
浏览器会判断缓存中是否有ETag或Last-Modified字段,如果没有,则发起一个http请求,服务器根据请求返回资源;如果有这两个字段,则在请求头中添加If-None-Match字段(有ETag字段的话添加)、If-Modified-Since字段(有Last-Modified字段的话添加)。
服务器判断缓存是否可用。如果与服务器内容不一致,则视情况返回其他状态码,并返回所请求资源。
用户行为对浏览器缓存的影响:
Http能不能一次连接多次请求,不等后端返回? link
首先,分析浏览器在与服务器建立了一个 TCP 连接后是否会在一个 HTTP 请求完成后断开?什么情况下会断开?
- 在 HTTP/1.0 中,一个服务器在发送完一个 HTTP 响应后,会断开 TCP 链接。但是这样每次请求都会重新建立和断开 TCP 连接,代价过大。
- 某些服务器对 Connection: keep-alive 的 Header 进行了支持。意思是说,完成这个 HTTP 请求之后,不要断开 HTTP 请求使用的 TCP 连接。这样的好处是连接可以被重新使用,之后发送 HTTP 请求的时候不需要重新建立 TCP 连接,以及如果维持连接,那么 SSL 的开销也可以避免
- 既然维持 TCP 连接好处这么多,HTTP/1.1 就把 Connection 头写进标准,并且默认开启持久连接,除非请求中写明 Connection: close,那么浏览器和服务器之间是会维持一段时间的 TCP 连接,不会一个请求结束就断掉。
- 所以,默认情况下建立 TCP 连接不会断开,只有在请求报头中声明 Connection: close 才会在请求完成后关闭连接。
HTTP/1.1 存在一个问题,单个 TCP 连接在同一时刻只能处理一个请求,意思是说:两个请求的生命周期不能重叠,任意两个 HTTP 请求从开始到结束的时间在同一个 TCP 连接里不能重叠。 虽然 HTTP/1.1 规范中规定了 Pipelining 来试图解决这个问题,但是这个功能在浏览器中默认是关闭的。
实践中会出现许多问题,所以默认不开启Pipelining:
- 一些代理服务器不能正确的处理 HTTP Pipelining。
- 正确的流水线实现是复杂的。
- Head-of-line Blocking 连接头阻塞:在建立起一个 TCP 连接之后,假设客户端在这个连接连续向服务器发送了几个请求。按照标准,服务器应该按照收到请求的顺序返回结果,假设服务器在处理首个请求时花费了大量时间,那么后面所有的请求都需要等着首个请求结束才能响应。
HTTP2 提供了 Multiplexing 多路传输特性,可以在一个 TCP 连接中同时完成多个 HTTP 请求。

绿色是发起请求到请求返回的等待时间,蓝色是响应的下载时间,可以看到都是在同一个 Connection,并行完成的
那么在 HTTP/1.1 时代,浏览器是如何提高页面加载效率的呢?
- 维持和服务器已经建立的 TCP 连接,在同一连接上顺序处理多个请求。
- 和服务器建立多个 TCP 连接。
浏览器对同一 Host 建立 TCP 连接到数量有没有限制?
- 假设我们还处在 HTTP/1.1 时代,那个时候没有多路传输,当浏览器拿到一个有几十张图片的网页该怎么办呢?肯定不能只开一个 TCP 连接顺序下载,那样用户肯定等的很难受,但是如果每个图片都开一个 TCP 连接发 HTTP 请求,那电脑或者服务器都可能受不了。所以,Chrome 最多允许对同一个 Host 建立六个 TCP 连接。
- 浏览器在 SSL 握手之后会和服务器商量能不能用 HTTP2,如果能的话就使用 Multiplexing 功能在这个连接上进行多路传输。不过也未必会所有挂在这个域名的资源都会使用一个 TCP 连接去获取,但是可以确定的是 Multiplexing 很可能会被用到。
WebSocket link
- 高并发与用户实时响应是Web应用经常面临的问题,比如金融证券的实时信息、社交网络的实时消息推送等。
- WebSocket出现前我们实现推送技术,用的都是轮询,在特定的时间间隔,浏览器自动发出请求,将服务器的消息主动的拉回来,这种情况下,我们需要不断的向服务器发送请求,并且HTTP 请求 的header非常长,里面包含的数据可能只是一个很小的值,这样会占用很多的带宽和服务器资源,并且服务器不能主动向客户端推送数据。在这种情况下需要一种高效节能的双向通信机制来保证数据的实时传输,于是基于HTML5规范的WebSocket应运而生。
- 概括:WebSocket是HTML5下一种新的协议。它实现了浏览器与服务器全双工通信,能更好的节省服务器资源和带宽并达到实时通讯的目的。
WebSocket与TCP,HTTP的关系?
- WebSocket与http协议一样都是基于TCP的,所以他们都是可靠的协议,调用的WebSocket的send函数在实现中最终都是通过TCP的系统接口进行传输的。
- WebSocket和Http协议一样都属于应用层的协议,WebSocket在建立握手连接时,数据是通过http协议传输的,但是在建立连接之后,真正的数据传输阶段是不需要http协议参与的。
在JavaScript中创建了WebSocket后,会有一个HTTP请求发送到服务器以发起连接。取得服务器响应后,建立的连接使用HTTP升级,从HTTP协议交换为WebSocket协议。即,使用标准的HTTP服务器无法实现WebSocket,只有支持这种协议的专门服务器才能正常工作。 WebSocket使用了自定义的协议,未加密的连接不再是http://,而是ws://,默认端口为80,加密的连接也不是https://,而是wss://,默认端口为443。 WebSocket模式客户端与服务器请求响应模式如图:
|  |
WebSocket是类似Socket的TCP长连接通讯模式。一旦WebSocket连接建立后,后续数据都以帧序列的形式传输。在客户端断开WebSocket连接或Server端中断连接前,不需要客户端和服务端重新发起连接请求。在海量并发及客户端与服务器交互负载流量大的情况下,极大的节省了网络带宽资源的消耗,有明显的性能优势,且客户端发送和接受消息是在同一个持久连接上发起,实时性优势明显。
WebSocket API?
todo
网络时延由哪几部分组成,产生于何处 link
时延(delay或latency)是指数据(一个报文或分组,甚至比特)从网络(或链路)的一端传送到另一端所需的时间。有时也称为延迟或迟延。
- 发送时延。是主机或路由器发送数据帧所需要的时间,也就是从发送数据帧的第一个比特算起,到该帧的最后一个比特发送完毕所需的时间。
- 传播时延。是电磁波在信道中传播一定的距离需要花费的时间。电磁波在自由空间的传播速率是光速,即3.0×los km/s。电磁波在网络传输媒体中的传播速率比在自由空间要略低一些
- 处理时延。主机或路由器在收到分组时要花费一定的时间进行处理,例如分析分组的首部、从分组中提取数据部分、进行差错检验或查找适当的路由等等。
- 排队时延。分组在经过网络传输时,要经过许多路由器。但分组在进入路由器后要先在输入队列中排队等待处理。在路由器确定了转发接口后,还要在输出队列中排队等待转发。这就产生了排队时延。排队时延的长短往往取决于网络当时的通信量。当网络的通信量很大时会发生队列溢出,使分组丢失,这相当于排队时延为无穷大。
DNS域名系统工作原理? link
DNS用来将主机名和域名转换为IP地址的工作。
域名系统作为一个层次结构和分布式数据库,包含各种类型的数据,包括主机名和域名。DNS数据库中的名称形成一个分层树状结构称为域命名空间。
查询过程:
- 用户主机上运行着DNS的客户端,就是我们的PC机或者手机客户端运行着DNS客户端了。
- 浏览器将接收到的url中抽取出域名字段,就是访问的主机名,比如http://www.baidu.com/,并将这个主机名传送给DNS应用的客户端。
- DNS客户机端向DNS服务器端发送一份查询报文,报文中包含着要访问的主机名字段(中间包括一些列缓存查询以及分布式DNS集群的工作)。
- 该DNS客户机最终会收到一份回答报文,其中包含有该主机名对应的IP地址。
- 一旦该浏览器收到来自DNS的IP地址,就可以向该IP地址定位的HTTP服务器发起TCP连接。
DNS为什么不采用单点的集中式的设计方式,而是使用分布式集群的工作方式?
因特网有着数量巨大并且在持续增长的主机,分布式集群解决以下问题:
- 集中式设计会有单点故障
- 通信容量(上亿台主机发送的查询DNS报文请求,包括但不限于所有的HTTP请求,电子邮件报文服务器,TCP长连接服务)
- 远距离的时间延迟(澳大利亚到纽约的举例)
- 维护开销大(因为所有的主机名-IP映射都要在一个服务站点更新)等
建立一个 socket 连接要经过哪些步骤? link
todo
操作系统
系统调用(system call) link link
进程在系统上的运行分为2个级别
- 用户态(user mode):用户态运行的进程只能受限地访问内存,不允许访问外围设备。占用CPU的能力被剥夺,CPU资源可以被其他程序获取。
- 内核态(kernel mode):运行在内核态下的程序,可以访问内存所有数据,包括外围设备。
用户态切换到内核态的三种方式:
系统调用:用户态进程主动要求切换到内核态的一种方式。用户态进程通过系统调用,申请使用操作系统提供的服务程序,以完成工作。
- 异常:当CPU在执行运行在用户态下的程序时,发生了某些事先不可知的异常,会触发由当前运行进程切换到处理此异常的内核相关程序中。因此也就转到了内核态,比如缺页异常。
- 外围设备终端:外围设备完成用户请求的操作后,会像CPU发送相应的中断信号。此时,CPU会暂停执行下一条即将要执行的指令,转而执行与中断信号对应的处理程序。如果先前执行的指令是用户态的程序,那么转换的过程自然就发生了由用户态到内核态的转换。
系统调用(system call)提供操作系统服务接口。这些调用通常以 C 或 C++ 编写。即使简单程序(如写文件)也可能大量使用操作系统。通常,系统每秒执行成千上万的系统调用。不过,应用程序开发人员根据应用编程接口(Application Programming Interface,API)来设计程序。API 为方便应用程序员规定了一组函数,包括每个函数的输入参数和返回值。
有三组常见 API 可为应用程序员所用:适用于 Windows 系统的 Windows API、适用于 POSIX 系统的 POSIX API(这包括几乎所有版本的 UNIX、Linux 和 Mac OS X)以及适用于 Java 虚拟机的 Java API。程序员通过操作系统提供的函数库来调用 API。对运行于 UNIX 和 Linux 的用 C 语言编写的程序,该库名为 libc。
对大多数的程序设计语言,运行时支持系统(由编译器直接提供的函数库)提供了系统调用接口(system-call interface),以链接到操作系统的系统调用。系统调用接口截取 API 函数的调用,并调用操作系统中的所需系统调用。通常,每个系统调用都有一个相关数字,而系统调用接口会根据这些数字来建立一个索引列表。系统调用接口就可调用操作系统内核中的所需系统调用,并返回系统调用状态与任何返回值。调用者无需知道如何实现系统调用,而只需遵循 API,并知道在调用系统调用后操作系统做了什么。因此,通过 API,操作系统接口的大多数细节可隐藏起来,且可由运行时库来管理。
在用户应用程序调用了系统调用 open() 后,操作系统是如何处理的。如图:

向操作系统传递参数有三种常用方法。 最简单的是通过寄存器来传递参数。不过,有时参数数量会比寄存器多。这时,这些参数通常存在内存的块或表中,而块或表的地址通过寄存器来传递(图 3)。Linux就是这样。

参数也可通过程序放在或压入(pushed)到堆栈(stack),并通过操作系统弹出(popped)。有的系统偏爱块或堆栈方法,因为这些方法并不限制传递参数的数量或长度。
- CPU 不执行程序的时候在干什么 link
CPU大部分的时间都是停留在”idle task”中。在Linux中,idle task并不是一个独立的线程,但是可以通过top指令查看CPU的idle比例
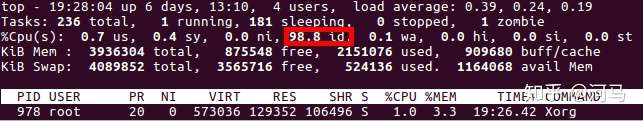
当CPU执行HLT指令后,CPU就会停止指令的执行,并且让CPU处于HALT状态。当CPU处于HALT状态的时候,CPU虽然停止指令执行,并且CPU的部分功能模块将会被关闭(达到降低功耗的目的),但是CPU的LAPIC(Local Advanced Programmable Interrupt Controller)并不会停止工作,即CPU将会继续接收外部中断、异常等外部事件(事实上,CPU HALT状态的退出将由外部事件触发)。当CPU接收到这些外部事件的时候,将会从HALT状态恢复回来,执行中断服务函数,并且当中断服务函数执行完毕后,指令寄存器(CS:EIP)将会指向HLT指令的下一条指令,即CPU继续执行HLT指令之后的程序。
操作系统32位与64位区别
主要体现在支持的内存、处理器、软件、处理数据的能力以及体积的大小等方面。
- 内存:32位系统支持的内存最大是4G,与此同时,64位系统则支持4G、 8G、 16G、32G、 64G 、128G 以及256G的内存等
- CPU:32位操作系统自然支持64位以及32位的处理器,同时,64位系统不能支持32位处理器。
- 软件:32位支持基于32位的软件,由于自身的限制,不能支持64位软件,64位则可以支持32位以及64位的软件,并与各种软件都能够兼容
- 体积:64位系统都比32位系统大。
编译器和解释器之间有什么区别
- 解释器:直接执行用编程语言编写的指令的程序
- 编译器:把源代码转换成(翻译)低级语言的程序
并发、并行区别 link
都表示CPU执行多个任务的方式。
对于单CPU的计算机来说,在CPU中,同一时间是只能干一件事儿的。
为了看起来像是“同时干多件事”操作系统把CPU的时间划分成长短基本相同的时间区间,即”时间片”,通过操作系统的管理,把这些时间片依次轮流地分配给各个应用使用。
这样,给用户的感觉是他在同时的进行听歌和打游戏,实际上,在操作系统中,CPU是在游戏进程和音乐播放器进程之间来回切换执行的。
操作系统时间片的使用是有规则的:某个作业在时间片结束之前,整个任务还没有完成,那么该作业就被暂停下来,放弃CPU,等待下一轮循环再继续做。此时CPU又分配给另一个作业去使用。
由于计算机的处理速度很快,只要时间片的间隔取得适当,那么一个用户作业从用完分配给它的一个时间片到获得下一个CPU时间片,中间有所”停顿”,但用户察觉不出来。
所以,在单CPU的计算机中,我们看起来“同时干多件事”,其实是通过CPU时间片技术,并发完成的。
所以,并发(Concurrent),在操作系统中,是指一个时间段中有几个程序都处于已启动运行到运行完毕之间,且这几个程序都是在同一个处理机上运行。
并行(Parallel),当系统有一个以上CPU时,当一个CPU执行一个进程时,另一个CPU可以执行另一个进程,两个进程互不抢占CPU资源,可以同时进行。
进程与线程、协程的区别,进程与线程切换流程
概念:
- 进程。进程是具有一定独立功能的程序关于某个数据集合上的一次运行活动,进程是系统进行资源分配和调度的一个独立单位。每个进程都有自己的独立内存空间,不同进程通过进程间通信来通信。由于进程比较重量,占据独立的内存,所以上下文进程间的切换开销(栈、寄存器、虚拟内存、文件句柄等)比较大,但相对比较稳定安全。
- 线程。线程是进程的一个实体,是CPU调度和分派的基本单位,它是比进程更小的能独立运行的基本单位.线程自己基本上不拥有系统资源,只拥有一点在运行中必不可少的资源(如程序计数器,一组寄存器和栈),但是它可与同属一个进程的其他的线程共享进程所拥有的全部资源。线程间通信主要通过共享内存,上下文切换很快,资源开销较少,但相比进程不够稳定容易丢失数据。多线程的优势是切换快,资源消耗低,但一个线程挂掉则会影响到所有线程,所以不够稳定。现实中使用线程池的场景会比较多
- 协程。协程是一种用户态的轻量级线程,协程的调度完全由用户控制。协程拥有自己的寄存器上下文和栈。协程调度切换时,将寄存器上下文和栈保存到其他地方,在切回来的时候,恢复先前保存的寄存器上下文和栈,直接操作栈则基本没有内核切换的开销,可以不加锁的访问全局变量,所以上下文的切换非常快。
区别:
进程多与线程比较
线程是指进程内的一个执行单元,也是进程内的可调度实体。
线程与进程的区别:
- 地址空间:线程是进程内的一个执行单元,进程内至少有一个线程,它们共享进程的地址空间,而进程有自己独立的地址空间
- 资源拥有:进程是资源分配和拥有的单位,同一个进程内的线程共享进程的资源
- 线程是处理器调度的基本单位,但进程不是
- 二者均可并发执行
- 每个独立的线程有一个程序运行的入口、顺序执行序列和程序的出口,但是线程不能够独立执行,必须依存在应用程序中,由应用程序提供多个线程执行控制
协程多与线程进行比较
- 一个线程可以有多个协程,一个进程也可以单独拥有多个协程,这样python中则能使用多核CPU。
- 线程进程都是同步机制,而协程则是异步
- 协程能保留上一次调用时的状态,每次过程重入时,就相当于进入上一次调用的状态
总结,进程、线程、协程的关系和区别:
进程拥有自己独立的堆和栈,既不共享堆,亦不共享栈,进程由操作系统调度。 线程拥有自己独立的栈和共享的堆,共享堆,不共享栈,线程亦由操作系统调度(标准线程是的)。 协程和线程一样共享堆,不共享栈,协程由程序开发者在协程的代码里显示调度。
进程与线程切换流程?link
线程切换的开销比进程切换的开销小,那么小在什么地方?切换的过程是怎样的?
无论是在多核还是单核系统中,一个CPU看上去都像是在并发的执行多个进程,这是通过处理器在进程间切换来实现的。
- 操作系统实现这种交错执行的机制称为上下文切换。
- 操作系统保持跟踪进程运行所需的所有状态信息,这种状态,也就是上下文,它包括许多信息,例如PC(程序计数器)和寄存器文件的当前值,以及主存的内容。
在任何一个时刻,单处理器系统都只能执行一个进程的代码。
当操作系统决定要把控制权从当前进程转移到某个新进程时,就会进行上下文切换,即保存当前进程的上下文,恢复新进程的上下文,然后将控制权传递到新进程,新进程就会从上次停止的地方开始
举例:
- 如果现在有两个并发的进程:外壳进程和hello进程。
- 开始只有外壳进程在运行,即等待命令行上的输入,当我们让他运行hello程序时,外壳通过调用一个专门的函数,即系统调用,来执行我们的请求,系统调用会将控制权传递给操作系统。
- 操作系统保存外壳进程的上下文,创建一个新的hello进程及其上下文,然后将控制权传递给新的hello进程。
- hello进程终止后,操作系统恢复外壳进程的上下文,并将控制权传回给他,外壳进程将继续等待下一个命令行输入。
上下文切换: 内核为每一个进程维持一个上下文。上下文就是内核重新启动一个被抢占的进程所需的状态。包括:
- 通用目的寄存器
- 浮点寄存器
- 程序计数器
- 用户栈
- 状态寄存器
- 内核栈
- 各种内核数据结构:比如描绘地址空间的页表,包含有关当前进程信息的进程表,以及包含进程已打开文件的信息的文件表。
进程切换:
系统中的每个程序都是运行在某个进程的上下文中的。
上下文是由程序正确运行所需的状态组成的,这个状态包括存放在存储器中的程序的代码和数据,他的栈,通用目的寄存器的内容,程序计数器,环境变量以及打开文件描述符的集合。
所以进程切换就是上下文切换。
虚拟内存:
虚拟内存是操作系统为每个进程提供的一种抽象,每个进程都有属于自己的、私有的、地址连续的虚拟内存,当然我们知道最终进程的数据及代码必然要放到物理内存上,那么必须有某种机制能记住虚拟地址空间中的某个数据被放到了哪个物理内存地址上,这就是所谓的地址空间映射,那么操作系统是如何记住这种映射关系的呢,答案就是页表。
每个进程都有自己的虚拟地址空间,进程内的所有线程共享进程的虚拟地址空间。
进程切换和线程切换有什么区别?(线程指的是同一个进程中的线程)需要理解虚拟内存。
- 进程切换涉及虚拟地址空间的切换而线程不会。因为每个进程都有自己的虚拟地址空间,而线程是共享所在进程的虚拟地址空间的,因此同一个进程中的线程进行线程切换时不涉及虚拟地址空间的转换。
- 进程都有自己的虚拟地址空间,把虚拟地址转换为物理地址需要查找页表,页表查找是一个很慢的过程,因此通常使用Cache来缓存常用的地址映射,这样可以加速页表查找,这个cache就是TLB(translation Lookaside Buffer)
- 由于每个进程都有自己的虚拟地址空间,那么显然每个进程都有自己的页表,那么当进程切换后页表也要进行切换,页表切换后TLB就失效了,cache失效导致命中率降低,那么虚拟地址转换为物理地址就会变慢,表现出来的就是程序运行会变慢,而线程切换则不会导致TLB失效,因为线程线程无需切换地址空间,因此我们通常说线程切换要比较进程切换块,原因就在这里
进程间通信(IPC)的方式 link
进程间通信(Inter-Process Communication,IPC):
每个进程各自有不同的用户地址空间,任何一个进程的全局变量在另一个进程中都看不到,所以进程之间要交换数据必须通过内核,在内核中开辟一块缓冲区,进程A把数据从用户空间拷到内核缓冲区,进程B再从内核缓冲区把数据读走,内核提供的这种机制称为进程间通信。
进程间通信方式:
- 匿名管道( pipe )
- 管道是一种半双工的通信方式,数据只能单向流动,而且只能在具有亲缘关系的进程间使用。进程的亲缘关系通常是指父子进程关系。
- 通过匿名管道实现进程间通信的步骤如下:
- 父进程创建管道,得到两个⽂件描述符指向管道的两端
- 父进程fork出子进程,⼦进程也有两个⽂件描述符指向同⼀管道。
- 父进程关闭fd[0],子进程关闭fd[1],即⽗进程关闭管道读端,⼦进程关闭管道写端(因为管道只支持单向通信)。⽗进程可以往管道⾥写,⼦进程可以从管道⾥读,管道是⽤环形队列实现的,数据从写端流⼊从读端流出,这样就实现了进程间通信。
- 高级管道(popen):将另一个程序当做一个新的进程在当前程序进程中启动,则它算是当前程序的子进程
- 命名管道(named pipe) :命名管道也是半双工的通信方式,但是它允许无亲缘关系进程间的通信。以磁盘文件的方式存在,可以实现本机任意两个进程通信。
- 消息队列( message queue ) :
- 消息队列是由消息的链表,存放在内核中并由消息队列标识符标识。
- 消息队列克服了信号传递信息少、管道只能承载无格式字节流以及缓冲区大小受限等缺点。
- 信号量( semophore )
- 信号量是一个计数器,可以用来控制多个进程对共享资源的访问。
- 它常作为一种锁机制,防止某进程正在访问共享资源时,其他进程也访问该资源。
- 因此,主要作为进程间以及同一进程内不同线程之间的同步手段。
- 信号( signal ) :
- 一种比较复杂的通信方式,用于通知接收进程某个事件已经发生。
- 信号可以在任何时候发给某一进程,而无需知道该进程的状态。
- Linux系统中常用信号:
- SIGHUP:用户从终端注销,所有已启动进程都将收到该进程。系统缺省状态下对该信号的处理是终止进程。
- SIGINT:程序终止信号。程序运行过程中,按Ctrl+C键将产生该信号。
- SIGQUIT:程序退出信号。程序运行过程中,按Ctrl+\键将产生该信号。
- SIGBUS和SIGSEGV:进程访问非法地址。
- SIGFPE:运算中出现致命错误,如除零操作、数据溢出等。
- SIGKILL:用户终止进程执行信号。shell下执行kill -9发送该信号。
- SIGTERM:结束进程信号。shell下执行kill 进程pid发送该信号。
- SIGALRM:定时器信号。
- SIGCLD:子进程退出信号。如果其父进程没有忽略该信号也没有处理该信号,则子进程退出后将形成僵尸进程。
- 共享内存( shared memory )
- 映射一段能被其他进程所访问的内存,这段共享内存由一个进程创建,但多个进程都可以访问。
- 共享内存是最快的 IPC 方式,它是针对其他进程间通信方式运行效率低而专门设计的。
- 它往往与其他通信机制,如信号量,配合使用,来实现进程间的同步和通信。
- 套接字( socket ) :用于不同机器间的进程通信
优缺点:
- 管道:速度慢,容量有限;
- Socket:任何进程间都能通讯,但速度慢;
- 消息队列:容量受到系统限制,且要注意第一次读的时候,要考虑上一次没有读完数据的问题;
- 信号量:不能传递复杂消息,只能用来同步;
- 共享内存区:能够很容易控制容量,速度快,但要保持同步,比如一个进程在写的时候,另一个进程要注意读写的问题,相当于线程中的线程安全,当然,共享内存区同样可以用作线程间通讯,不过没这个必要,线程间本来就已经共享了同一进程内的一块内存。
线程间的通信
todo
进程间同步的方式
- 临界区
- 通过对多线程的串行化来访问公共资源或一段代码,速度快,适合控制数据访问。
- 优点:保证在某一时刻只有一个线程能访问数据的简便办法。
- 缺点:虽然临界区同步速度很快,但却只能用来同步本进程内的线程,而不可用来同步多个进程中的线程。
- 互斥量
- 为协调共同对一个共享资源的单独访问而设计的。
- 互斥量跟临界区很相似,比临界区复杂,互斥对象只有一个,只有拥有互斥对象的线程才具有访问资源的权限。
- 优点:使用互斥不仅仅能够在同一应用程序不同线程中实现资源的安全共享,而且可以在不同应用程序的线程之间实现对资源的安全共享
- 缺点:互斥量是可以命名的,也就是说它可以跨越进程使用,所以创建互斥量需要的资源更多,所以如果只为了在进程内部使用的话使用临界区会带来速度上的优势并能够减少资源占用量。
- 通过互斥量可以指定资源被独占的方式使用,但如果有下面一种情况通过互斥量就无法处理,比如现在一位用户购买了一份三个并发访问许可的数据库系统,可以根据用户购买的访问许可数量来决定有多少个线程/进程能同时进行数据库操作,这时候如果利用互斥量就没有办法完成这个要求,信号量对象可以说是一种资源计数器。
- 信号量
- 为控制一个具有有限数量用户资源而设计。
- 它允许多个线程在同一时刻访问同一资源,但是需要限制在同一时刻访问此资源的最大线程数目。
- 互斥量是信号量的一种特殊情况,当信号量的最大资源数=1就是互斥量了。
- 优点:适用于对Socket(套接字)程序中线程的同步。
- 缺点: 信号量机制必须有公共内存,不能用于分布式操作系统,这是它最大的弱点;
- 信号量机制功能强大,但使用时对信号量的操作分散, 而且难以控制,读写和维护都很困难,加重了程序员的编码负担;
- 核心操作P-V分散在各用户程序的代码中,不易控制和管理,一旦错误,后果严重,且不易发现和纠正。
- 事件
- 用来通知线程有一些事件已发生,从而启动后继任务的开始。
- 优点:事件对象通过通知操作的方式来保持线程的同步,并且可以实现不同进程中的线程同步操作。
线程同步的方式
- 临界区
- 当多个线程访问一个独占性共享资源时,可以使用临界区对象。
- 拥有临界区的线程可以访问被保护起来的资源或代码段,其他线程若想访问,则被挂起,直到拥有临界区的线程放弃临界区为止,以此达到用原子方式操 作共享资源的目的。
- 事件:允许一个线程在处理完一个任务后,主动唤醒另外一个线程执行任务。
- 互斥量:互斥对象和临界区对象非常相似,只是其允许在进程间使用,而临界区只限制与同一进程的各个线程之间使用,但是更节省资源,更有效率。
- 信号量:当需要一个计数器来限制可以使用某共享资源的线程数目时,可以使用“信号量”对象。
区别:
- 互斥量与临界区的作用非常相似,但互斥量是可以命名的,也就是说互斥量可以跨越进程使用,但创建互斥量需要的资源更多,所以如果只为了在进程内部是用的话使用临界区会带来速度上的优势并能够减少资源占用量 。因为互斥量是跨进程的互斥量一旦被创建,就可以通过名字打开它。
- 互斥量,信号量,事件都可以被跨越进程使用来进行同步数据操作。
线程的分类
从线程的运行空间来说,分为用户级线程(user-level thread, ULT)和内核级线程(kernel-level, KLT)
- 内核级线程:这类线程依赖于内核,又称为内核支持的线程或轻量级进程。无论是在用户程序中的线程还是系统进程中的线程,它们的创建、撤销和切换都由内核实现。比如英特尔i5-8250U是4核8线程,这里的线程就是内核级线程
- 用户级线程:它仅存在于用户级中,这种线程是不依赖于操作系统核心的。应用进程利用线程库来完成其创建和管理,速度比较快,操作系统内核无法感知用户级线程的存在。
多线程共享什么资源,独享哪些资源? link
同一进程间的线程究竟共享哪些资源呢,而又各自独享哪些资源呢?
共享的资源:
- 堆:由于堆是在进程空间中开辟出来的,所以它是理所当然地被共享的;因此new出来的都是共享的(16位平台上分全局堆和局部堆,局部堆是独享的)
- 全局变量:它是与具体某一函数无关的,所以也与特定线程无关;因此也是共享的
- 静态变量:虽然对于局部变量来说,它在代码中是“放”在某一函数中的,但是其存放位置和全局变量一样,存于堆中开辟的.bss和.data段,是共享的
- 文件等公用资源 这个是共享的,使用这些公共资源的线程必须同步。
独享的资源:
- 栈:栈是独享的
- 寄存器:这个可能会误解,因为电脑的寄存器是物理的,每个线程去取值难道不一样吗?其实线程里存放的是副本,包括程序计数器PC
什么是临界区?如何解决冲突?
每个进程中访问临界资源的那段程序称为临界区,一次仅允许一个进程使用的资源称为临界资源。
解决冲突的办法:
- 如果有若干进程要求进入空闲的临界区,一次仅允许一个进程进入,如已有进程进入自己的临界区,则其它所有试图进入临界区的进程必须等待;
- 进入临界区的进程要在有限时间内退出。
- 如果进程不能进入自己的临界区,则应让出CPU,避免进程出现“忙等”现象。
什么是死锁?死锁产生的条件?
死锁:
在两个或者多个并发进程中,如果每个进程持有某种资源而又等待其它进程释放它或它们现在保持着的资源,在未改变这种状态之前都不能向前推进,称这一组进程产生了死锁。通俗的讲就是两个或多个进程无限期的阻塞、相互等待的一种状态。
死锁产生的四个必要条件:(有一个条件不成立,则不会产生死锁)
- 互斥条件:一个资源一次只能被一个进程使用
- 请求与保持条件:一个进程因请求资源而阻塞时,对已获得资源保持不放
- 不剥夺条件:进程获得的资源,在未完全使用完之前,不能强行剥夺
- 循环等待条件:若干进程之间形成一种头尾相接的环形等待资源关系
如何处理死锁问题:
- 忽略该问题。例如鸵鸟算法,该算法可以应用在极少发生死锁的的情况下。为什么叫鸵鸟算法呢,因为传说中鸵鸟看到危险就把头埋在地底下,可能鸵鸟觉得看不到危险也就没危险了吧。跟掩耳盗铃有点像。
- 检测死锁并且恢复。
- 仔细地对资源进行动态分配,以避免死锁。
- 通过破除死锁四个必要条件之一,来防止死锁产生。
死锁检测、恢复、预防?
todo
进程调度策略(算法)?
- 先来先服务(FCFS):非抢占式的调度算法,按照请求的顺序进行调度。有利于长作业,但不利于短作业,因为短作业必须一直等待前面的长作业执行完毕才能执行,而长作业又需要执行很长时间,造成了短作业等待时间过长。另外,对I/O密集型进程也不利,因为这种进程每次进行I/O操作之后又得重新排队。
- 短作业优先:非抢占式的调度算法,按估计运行时间最短的顺序进行调度。长作业有可能会饿死,处于一直等待短作业执行完毕的状态。因为如果一直有短作业到来,那么长作业永远得不到调度。
- 最短剩余时间优先:最短作业优先的抢占式版本,按剩余运行时间的顺序进行调度。 当一个新的作业到达时,其整个运行时间与当前进程的剩余时间作比较。如果新的进程需要的时间更少,则挂起当前进程,运行新的进程。否则新的进程等待。
- 时间片轮转:将所有就绪进程按 FCFS 的原则排成一个队列,每次调度时,把 CPU 时间分配给队首进程,该进程可以执行一个时间片。当时间片用完时,由计时器发出时钟中断,调度程序便停止该进程的执行,并将它送往就绪队列的末尾,同时继续把 CPU 时间分配给队首的进程。
时间片轮转算法的效率和时间片的大小有很大关系:
- 因为进程切换都要保存进程的信息并且载入新进程的信息,如果时间片太小,会导致进程切换得太频繁,在进程切换上就会花过多时间。
- 而如果时间片过长,那么实时性就不能得到保证。
优先级调度:
为每个进程分配一个优先级,按优先级进行调度。为了防止低优先级的进程永远等不到调度,可以随着时间的推移增加等待进程的优先级。
进程有哪些状态?如何切换?
进程一共有5种状态,分别是创建、就绪、运行(执行)、终止、阻塞。
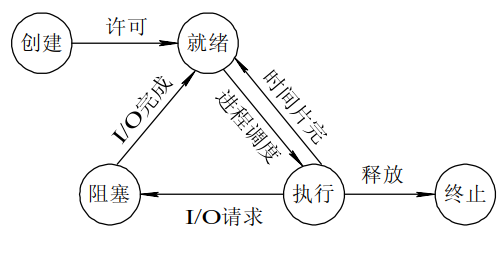
- 运行状态就是进程正在CPU上运行。在单处理机环境下,每一时刻最多只有一个进程处于运行状态。
- 就绪状态就是说进程已处于准备运行的状态,即进程获得了除CPU之外的一切所需资源,一旦得到CPU即可运行。
- 阻塞状态就是进程正在等待某一事件而暂停运行,比如等待某资源为可用或等待I/O完成。即使CPU空闲,该进程也不能运行。
状态转换:
- 运行态→阻塞态:往往是由于等待外设,等待主存等资源分配或等待人工干预而引起的。
- 阻塞态→就绪态:则是等待的条件已满足,只需分配到处理器后就能运行。
- 运行态→就绪态:不是由于自身原因,而是由外界原因使运行状态的进程让出处理器,这时候就变成就绪态。例如时间片用完,或有更高优先级的进程来抢占处理器等。
- 就绪态→运行态:系统按某种策略选中就绪队列中的一个进程占用处理器,此时就变成了运行态。
什么是分页?
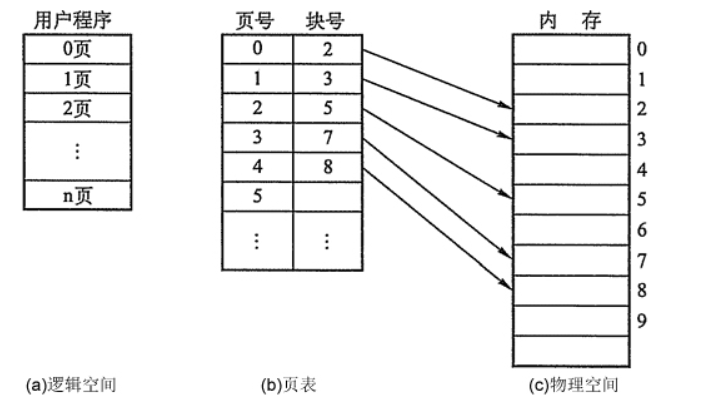
把内存空间划分为大小相等且固定的块,作为主存的基本单位。因为程序数据存储在不同的页面中,而页面又离散的分布在内存中,因此需要一个页表来记录映射关系,以实现从页号到物理块号的映射。
访问分页系统中内存数据需要两次的内存访问 (一次是从内存中访问页表,从中找到指定的物理块号,加上页内偏移得到实际物理地址;第二次就是根据第一次得到的物理地址访问内存取出数据)。
什么是分段?
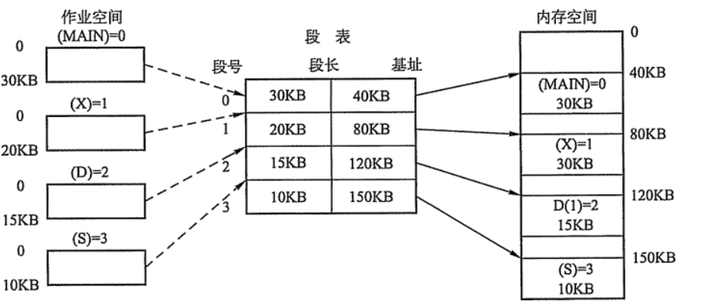
分页是为了提高内存利用率,而分段是为了满足程序员在编写代码的时候的一些逻辑需求(比如数据共享,数据保护,动态链接等)。
分段内存管理当中,地址是二维的,一维是段号,二维是段内地址;其中每个段的长度是不一样的,而且每个段内部都是从0开始编址的。由于分段管理中,每个段内部是连续内存分配,但是段和段之间是离散分配的,因此也存在一个逻辑地址到物理地址的映射关系,相应的就是段表机制。
分页和分段有什区别?
- 分页对程序员是透明的,但是分段需要程序员显式划分每个段。
- 分页的地址空间是一维地址空间,分段是二维的。
- 页的大小不可变,段的大小可以动态改变。
- 分页主要用于实现虚拟内存,从而获得更大的地址空间;分段主要是为了使程序和数据可以被划分为逻辑上独立的地址空间并且有助于共享和保护。
什么是交换空间?
操作系统把物理内存(physical RAM)分成一块一块的小内存,每一块内存被称为页(page)。当内存资源不足时,Linux把某些页的内容转移至硬盘上的一块空间上,以释放内存空间。硬盘上的那块空间叫做交换空间(swap space),而这一过程被称为交换(swapping)。物理内存和交换空间的总容量就是虚拟内存的可用容量。
用途:
- 物理内存不足时一些不常用的页可以被交换出去,腾给系统。
- 程序启动时很多内存页被用来初始化,之后便不再需要,可以交换出去。
页面替换算法是什么,有哪些?
在程序运行过程中,如果要访问的页面不在内存中,就发生缺页中断从而将该页调入内存中。此时如果内存已无空闲空间,系统必须从内存中调出一个页面到磁盘对换区中来腾出空间。
包括以下算法:
- 最佳算法:所选择的被换出的页面将是最长时间内不再被访问,通常可以保证获得最低的缺页率。这是一种理论上的算法,因为无法知道一个页面多长时间不再被访问。
- 先进先出(FIFO):选择换出的页面是最先进入的页面。该算法将那些经常被访问的页面也被换出,从而使缺页率升高。
- 最近最少使用(LRU, last recently used):虽然无法知道将来要使用的页面情况,但是可以知道过去使用页面的情况。LRU 将最近最久未使用的页面换出。为了实现 LRU,需要在内存中维护一个所有页面的链表。当一个页面被访问时,将这个页面移到链表表头。这样就能保证链表表尾的页面是最近最久未访问的。因为每次访问都需要更新链表,因此这种方式实现的 LRU 代价很高。
- 时钟算法:时钟算法使用环形链表将页面连接起来,再使用一个指针指向最老的页面。它将整个环形链表的每一个页面做一个标记,如果标记是0,那么暂时就不会被替换,然后时钟算法遍历整个环,遇到标记为1的就替换,否则将标记为0的标记为1。
- 还有LFU,last frequently used最近使用次数算法。
- OPT,optimal replacement,最优置换算法。保证置换出去的是不再被使用的页,或在实际内存中最晚使用
什么是虚拟内存?
虚拟内存就是,让物理内存扩充成更大的逻辑内存,从而让程序获得更多的可用内存。虚拟内存使用部分加载的技术,让一个进程或者资源的某些页面加载进内存,从而能够加载更多的进程,甚至能加载比内存大的进程,这样看起来好像内存变大了,这部分内存其实包含了磁盘或者硬盘,这就叫做虚拟内存。
什么是缓冲区溢出?有什么危害?
缓冲区溢出是指当计算机向缓冲区填充数据时超出了缓冲区本身的容量,溢出的数据覆盖在合法数据上。
危害有以下两点:
- 程序崩溃,导致拒绝服务
- 跳转并且执行一段恶意代码
造成缓冲区溢出的主要原因是程序中没有仔细检查用户输入。
讲一讲IO多路复用?
IO多路复用是指内核一旦发现进程指定的一个或者多个IO条件准备读取,它就通知该进程。
IO多路复用适用如下场合:
- 当客户处理多个描述字时(一般是交互式输入和网络套接口),必须使用I/O复用。
- 当一个客户同时处理多个套接口时,而这种情况是可能的,但很少出现。
- 如果一个TCP服务器既要处理监听套接口,又要处理已连接套接口,一般也要用到I/O复用。
- 如果一个服务器即要处理TCP,又要处理UDP,一般要使用I/O复用。
- 如果一个服务器要处理多个服务或多个协议,一般要使用I/O复用。
- 与多进程和多线程技术相比,I/O多路复用技术的最大优势是系统开销小,系统不必创建进程/线程,也不必维护这些进程/线程,从而大大减小了系统的开销。
硬链接和软链接有什么区别?
- 硬链接:在目录下创建一个条目,记录着文件名与 inode 编号,这个 inode 就是源文件的 inode。删除任意一个条目,文件还是存在,只要引用数量不为 0。但是硬链接有限制,它不能跨越文件系统,也不能对目录进行链接。
- 符号链接文件:保存着源文件所在的绝对路径,在读取时会定位到源文件上,可以理解为 Windows 的快捷方式。当源文件被删除了,链接文件就打不开了。因为记录的是路径,所以可以为目录建立符号链接。
中断的处理过程?
- 保护现场:将当前执行程序的相关数据保存在寄存器中,然后入栈。
- 开中断:以便执行中断时能响应较高级别的中断请求。
- 中断处理
- 关中断:保证恢复现场时不被新中断打扰
- 恢复现场:从堆栈中按序取出程序数据,恢复中断前的执行状态。
中断和轮询有什么区别?
轮询:
- CPU对特定设备轮流询问。
- 效率低等待时间长,CPU利用率不高。
中断:
- 通过特定事件提醒CPU。
- 容易遗漏问题,CPU利用率不高。
同步、异步?阻塞、非阻塞? link
- 同步:发出一个功能调用时,在没有得到结果之前,该调用就不返回或继续执行后续操作。
- 异步:当一个异步过程调用发出后,调用者在没有得到结果之前,就可以继续执行后续操作。当这个调用完成后,一般通过状态、通知和回调来通知调用者。对于异步调用,调用的返回并不受调用者控制。
- 通知调用者的三种方式:
- 状态:即监听被调用者的状态(轮询),调用者需要每隔一定时间检查一次,效率会很低。
- 通知:当被调用者执行完成后,发出通知告知调用者,无需消耗太多性能。
- 回调:与通知类似,当被调用者执行完成后,会调用调用者提供的回调函数。
- 通知调用者的三种方式:
同步与异步的区别:请求发出后,是否需要等待结果,才能继续执行其他操作。
阻塞与非阻塞: 阻塞和非阻塞这两个概念与程序(线程)等待消息通知(无所谓同步或者异步)时的状态有关。也就是说阻塞与非阻塞主要是程序(线程)等待消息通知时的状态角度来说的。
- 阻塞调用是指调用结果返回之前,当前线程会被挂起。调用线程只有在得到结果之后才会返回。
- 非阻塞调用指在不能立刻得到结果之前,该调用不会阻塞当前线程。
阻塞非阻塞与同步异步的区别:
- 同步/异步关注的是消息通知的机制
- 阻塞/非阻塞关注的是程序(线程)等待消息通知时的状态。
磁盘调度算法:
- FCFS:先进先出
- SSTF:Shortest Seek Time First,最短寻道时间优先。可能会出现饥饿现象
- Elevator:向一个方向寻道,寻完后再向另一个方向寻道
堆与栈的区别,在程序中的使用:
程序的内存分配
- 堆:由程序员分配释放,若程序员不释放,程序结束时可能由操作系统回收
- 栈:由编译器自动分配释放,存放函数的参数值、局部变量的值等等
- 全局区/静态区
- 全局变量和静态变量是放在一起的
- 初始化的全局变量和静态变量放在一个区域
- 未初始化的全局变量和静态变量放在另一个区域
- 程序结束时由系统释放
- 文字常量区:常量字符串的存放位置,由操作系统在程序结束后释放
- 程序代码区:存放函数体的二进制代码
举例:
#include<iostream>
using namespace std;

int a = 0;//全局初始化区
char *p1;//全局未初始化区

int main()
{
    int b;//栈
    char s[] = "abc";//栈
    char *p2;//栈
    char *p3 = "123456";//p3在栈,“123456”在常量区
    static int c = 0;//全局初始化区
    p1 = (char *)malloc(10);
    p2 = (char *)malloc(20);
    //分配得来的10和20字节在堆区
    strcpy(p1, "123456");
    //“123456”在常量区,编译器可能会将它与p3所指向的“123456”优化成一个地方
}
注意:Go中的堆与栈
Go语言区别于C/C++,虽然变量申请在堆空间上,但是它有自动回收垃圾的功能,所以这些堆地址空间也无需我们手动回收,系统会在需要释放的时刻自动进行垃圾回收。
内存连续分配算法
- 首次适应算法:空闲分区以地址递增次序链接,分配内存时顺序查找,找到大小能满足要求的第一个空闲分区
- 最佳适应算法:空闲分区按容量递增的次序链接,找到第一个能满足要求的空闲分区
- 最坏适应算法:空闲分区以容量递减的次序链接,找到第一个能满足要求的空闲分区,也就是挑选最大的分区
孤儿进程,僵尸进程 link
在UNIX里,除了进程0(即PID=0的交换进程,Swapper Process)以外的所有进程都是由其他进程使用系统调用fork创建的,这里调用fork创建新进程的进程即为父进程,而相对应的为其创建出的进程则为子进程,因而除了进程0以外的进程都只有一个父进程,但一个进程可以有多个子进程。
操作系统内核以进程标识符(Process Identifier,即PID)来识别进程。进程0是系统引导时创建的一个特殊进程,在其调用fork创建出一个子进程(即PID=1的进程1,又称init)后,进程0就转为交换进程(有时也被称为空闲进程),而进程1(init进程)就是系统里其他所有进程的祖先。
僵尸进程与孤儿进程
当一个子进程结束运行(一般是调用exit、运行时发生致命错误或收到终止信号所导致)时,子进程的退出状态(返回值)会回报给操作系统,系统则以SIGCHLD信号将子进程被结束的事件告知父进程,此时子进程的进程控制块(PCB)仍驻留在内存中。一般来说,收到SIGCHLD后,父进程会使用wait系统调用以取得子进程的退出状态,然后内核就可以从内存中释放已结束的子进程的PCB;而如若父进程没有这么做的话,子进程的PCB就会一直驻留在内存中,也即成为僵尸进程。
孤儿进程则是指父进程结束后仍在运行的子进程。在类UNIX系统中,孤儿进程一般会被init进程所“收养”,成为init的子进程。
僵尸进程的危害:
系统所能使用的进程号是有限的,如果大量的产生僵死进程,将因为没有可用的进程号而导致系统不能产生新的进程. 此即为僵尸进程的危害应当避免。
僵尸进程中保存着很多对程序员和系统管理员非常重要的信息,首先,这个进程是怎么死亡的?是正常退出呢,还是出现了错误,还是被其它进程强迫退出的?其次,这个进程占用的总系统CPU时间和总用户CPU时间分别是多少?发生页错误的数目和收到信号的数目。这些信息都被存储在僵尸进程中,试想如果没有僵尸进程,进程一退出,所有与之相关的信息都立刻归于无形.
僵尸资源会造成资源浪费,孤儿进程则不会。
linux常用命令与工具
- ps:显示运行的进程,还会显示进程的一些信息如pid, cpu和内存使用情况等
$ ps aux
USER               PID  %CPU %MEM      VSZ    RSS   TT  STAT STARTED      TIME COMMAND
root              1006  12.0  1.0 12861176 166312   ??  S     5:55下午 165:22.95 com.docker.hyperkit
root               435   5.2  0.3  4853560  48696   ??  S     5:54下午  67:08.37 /Applications/Visual Studio Code.app
- kill 命令用于终止进程
kill -signal PID

1:SIGHUP,启动被终止的进程
2:SIGINT,相当于输入ctrl+c,中断一个程序的进行
9:SIGKILL,强制中断一个进程的进行
15:SIGTERM,以正常的结束进程方式来终止进程
17:SIGSTOP,相当于输入ctrl+z,暂停一个进程的进行
- crontab: link
service cron start # 启动cronjob
service cron stop # 停止cronjob
service cron restart #  重启cronjob
crontab -e # 编辑cronjob任务
第1列分钟1~59
第2列小时1~23(0表示子夜)
第3列日1~31
第4列月1~12
第5列星期0~6(0表示星期天)
第6列要运行的命令
# crontab -l
* * * * * /usr/local/bin/docker exec -u www-data php-fpm /usr/local/bin/php artisan --env=developer schedule:run > /dev/null 2> /Users/gaea/fns/log/test.log
- free 命令用于显示Linux系统中空闲的、已用的物理内存及swap内存,及被内核使用的buffer
free [参数]
-b 以Byte为单位显示内存使用情况。
-k 以KB为单位显示内存使用情况。
-m 以MB为单位显示内存使用情况。
-g 以GB为单位显示内存使用情况。
-o 不显示缓冲区调节列。
-s<间隔秒数> 持续观察内存使用状况。
-t 显示内存总和列。
-V 显示版本信息。
# free -m
               total        used        free      shared  buff/cache   available
Mem:            7962        2973        2793          42        2195        4777
Swap:           1023           0        1023
- top 命令是Linux下常用的性能分析工具,能够实时显示系统中各个进程的资源占用状况
top [参数]
-u<用户名> 指定用户名
-p<进程号> 指定进程
...
结果:
top - 06:49:40 up 20:55,  0 users,  load average: 1.40, 1.34, 0.57
Tasks:   3 total,   1 running,   2 sleeping,   0 stopped,   0 zombie
%Cpu(s):  0.3 us,  0.6 sy,  0.0 ni, 99.0 id,  0.0 wa,  0.0 hi,  0.0 si,  0.0 st
MiB Mem :   7962.1 total,   2815.9 free,   2949.2 used,   2197.0 buff/cache
MiB Swap:   1024.0 total,   1024.0 free,      0.0 used.   4806.1 avail Mem

  PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
    1 root      20   0    4092   3260   2832 S   0.0   0.0   0:00.03 bash
    8 root      20   0    2412    580    508 S   0.0   0.0   0:00.04 sh
   16 root      20   0    6928   3144   2628 R   0.0   0.0   0:00.00 top
分析: link
- 第一行:系统运行状态和平均负载
    - 第一个参数:目前的时间:06:49:40
    - 第二个参数:系统目前运行的时间:20:55
    - 第三个参数:当前有多少人登录了这个系统:1
    - 第四个参数:系统负载(load average),既任务队列的平均长度,三个数值分别代表最近1分钟,5分钟,15分钟的系统平均负载
        - 对于单核CPU来说,0表示没有负荷,1表示满负荷,大于1表示超负荷,理想值是0.7
        - 对于多核CPU来说,用核数按比例放大就好,比如四核CPU,理想值就是4*0.7=2.8
        - 查看CPU核数:`cat /proc/cpuinfo | grep name | cut -f2 -d: | uniq -c`
- 第二行:进程相关信息
    - 第一个参数:进程总数:4个
    - 第二个参数:正在运行的进程数 : 1个
    - 第三个参数:睡眠的进程数:3个
    - 第四个参数:停止的进程数 : 0个
    - 第五个参数:僵尸进程数 :0个
- 第三行:cpu信息,**按1可以切换显示多核CPU信息**
    - 第一个参数:**us用户空间**占用的cpu百分比:7.7%
    - 第二个参数:**sy内核空间**占用的cpu百分比:9.1%
    - 第三个参数:**ni用户进程空间内改变过优先级的进程**占用CPU百分比:0%
    - 第四个参数:**id 空闲CPU百分比**:82.7%(关注点)
    - 第五个参数:wa等待输入输出的CPU时间百分比:0%
    - 第六个参数:hi CPU服务于硬件中断所耗费的时间总额:0%
    - 第七个参数:si CPU服务软中断所耗费的时间总额:0.5%
    - 第八个参数:st Steal time 虚拟机被hypervisor偷去的CPU时间:0%
- 第四行:内存信息
    - 第一个参数:mem 物理内存总量 : 后缀是total
    - 第二个参数: 空闲内存总量 : 后缀是free
    - 第三个参数 :使用的物理内存总量 : 后缀是used
    - 第四个参数 : 用作内核缓存的内存量 : 后缀是buff/cache
- 第五行:
    - 第一个参数:交换区总量 : 后缀是total
    - 第二个参数:空闲交换区总量 : 后缀是free
    - 第三个参数:使用的交换区总量 : 后缀是used
    - 第四个参数:缓冲的交换区总量 : 后缀是avail mem
- 进程信息
    - PID(process id):进程id
    - USER (user name):进程所有者的用户名
    - PR (priority) :优先级
    - NI (nice value) : 负值表示高优先级,正值表示低优先级
    - VIRT (Virtual Image (kb)) : 进程使用的虚拟内存总量,单位kb。VIRT=SWAP+RES
    - RES (Resident size (kb)) : 进程使用的、未被换出的物理内存大小,单位kb。RES=CODE+DATA
    - SHR (Shared Mem size (kb)) : 共享内存大小,单位kb
    - S (Process Status) : 进程状态。D=不可中断的睡眠状态,R=运行,S=睡眠,T=跟踪/停止,Z=僵尸进程
    - %CPU (CPU usage) : 上次更新到现在的CPU时间占用百分比。这里可能超过100%,每一个100%表示占用了一个CPU,比如230%,表示目前这个进程占用了2核CPU
    - %MEM (Memory usage (RES)) :进程使用的物理内存百分比
    - TIME+ (CPU Time, hundredths) : 进程使用的CPU时间总计,单位1/100秒
    - COMMAND (Command name/line) : 命令名/命令行
- scp 命令是secure copy的简写,用于在Linux下进行远程拷贝文件的命令,和它类似的命令有cp,不过cp只是在本机进行拷贝不能跨服务器,而且scp传输是加密的
scp [参数] [原路径] [目标路径]
-r 递归复制整个目录。
-v 详细方式显示输出。scp和ssh(1)会显示出整个过程的调试信息。这些信息用于调试连接,验证和配置问题。
-i identity_file 从指定文件中读取传输时使用的密钥文件(私钥),此参数直接传递给ssh。
举例,从本地(MAC)传递文件到远程服务器(前提是本机生成了公钥,并传到了服务器上对应账号文件夹内):
scp -i /Users/local_account_name/.ssh/id_rsa ./tmp.tar.gz remote_account_name@remote_ip:/tmp
- telnet 命令用来远程登录操作
例如,连接本机memcached服务:
telnet 127.0.0.1 11211
- whereis 命令:搜索文件
只能用于程序名的搜索,而且只搜索二进制文件(参数-b)、man说明文件(参数-m)和源代码文件(参数-s)。如果省略参数,则返回所有信息。和find相比,whereis查找的速度非常快,这是因为linux系统会将 系统内的所有文件都记录在一个数据库文件中,当使用whereis和locate时,会从数据库中查找数据,而不是像find命令那样,通过遍历硬盘来查找,效率自然会很高。 但是该数据库文件并不是实时更新,默认情况下时一星期更新一次,因此,我们在用whereis和locate 查找文件时,有时会找到已经被删除的数据,或者刚刚建立文件,却无法查找到,原因就是因为数据库文件没有被更新。
- which 会在PATH变量指定的路径中,搜索某个系统命令的位置,并且返回第一个搜索结果
# which go
/usr/local/go/bin/go
- grep命令
该命令常用于分析一行的信息,若当中有我们所需要的信息,就将该行显示出来,该命令通常与管道命令一起使用,用于对一些命令的输出进行筛选加工等等,比如可以加在ps, tail, cat后面
grep [-acinv] [--color=auto] '查找字符串' filename

参数:
  -a或--text   不要忽略二进制的数据。
  -A<显示列数>或--after-context=<显示列数>  显示该列和之后的内容。
  -c或--count   只打印匹配的行数,不显示匹配的内容。
  -C<显示列数>或--context=<显示列数>或-<显示列数>  显示该列和前后N行的内容。
  -i或--ignore-case   忽略字符大小写的差别。
  -l或--file-with-matches   列出文件内容符合指定的范本样式的文件名称。
  -n或--line-number  在匹配的行前面打印行号。
  -v或--revert-match   反检索,只显示不匹配的行。
- ln 命令是为某一个文件在另外一个位置建立一个同步的链接
- 软链接:
- 软链接,以路径的形式存在。类似于Windows操作系统中的快捷方式
- 软链接可以 跨文件系统 ,硬链接不可以
- 软链接可以对一个不存在的文件名进行链接
- 软链接可以对目录进行链接
- 硬链接:
- 硬链接,以文件副本的形式存在。但不占用实际空间。
- 不允许给目录创建硬链接
- 硬链接只有在同一个文件系统中才能创建
- 软链接:
ln [参数][源文件或目录][目标文件或目录]
参数:
-s 软链接(符号链接)
- sed(流处理编辑器),处理文本的过程如下:
- 从文本或者管道中读入一行内容到模式空间(临时缓冲区)
- 使用sed命令处理,重复第1步,直到文件处理完毕
- 输出到屏幕
- 注意两点:
- sed一次处理一行的内容
- sed默认的不改变文件内容
$sed [options] 'command' files
 options可以使用下面这几个值:
    -e:可以指定多个command
    -n:与p(print)命令合用时,表示只显示被选中的行,而不是显示所有的行,然后被选中的行会显示两次。
    -i:将sed的操作结果更新到文件中,因为默认的是不会操作文件本身的。
 command:行定位(正则)+ sed命令,首先会通过正则行定位,选中要进行操作的行,然后执行sed命令
举例:
[root@localhost test]# #打印第5行
[root@localhost test]# sed -n "5 p" data.txt

[root@localhost test]# 打印匹配"China"的记录,/pattern/使用正则表达式,注意要包含在/..../之间
[root@localhost test]# sed -n "/china/ p" data.txt

[root@localhost test]# 打印第3~6行
[root@localhost test]# cat -n data.txt | sed -n "3,6 p"

[root@localhost test]# #打印“Jane”的行,到“贝爷”之间的行
[root@localhost test]# sed -n "/Jane/, /贝爷/ p" data.txt
...
- AWK 是一种处理文本文件的语言,是一个强大的文本分析工具。
语法
awk [选项参数] 'script' var=value file(s)
或
awk [选项参数] -f scriptfile var=value file(s)
举例:
awk '{[pattern] action}' {filenames}   # 行匹配语句 awk '' 只能用单引号
# 每行按空格或TAB分割,输出文本中的1、4项
$ awk '{print $1,$4}' log.txt

awk -F  #-F相当于内置变量FS, 指定分割字符
# 使用","分割
$ awk -F, '{print $1,$2}'   log.txt
# 使用多个分隔符.先使用空格分割,然后对分割结果再使用","分割
$ awk -F '[ ,]'  '{print $1,$2,$5}'   log.txt

过滤与运算法
# 过滤第一列等于2的行
$ awk '$1==2 {print $1,$3}' log.txt
# 过滤第一列大于2并且第二列等于'Are'的行
$ awk '$1>2 && $2=="Are" {print $1,$2,$3}' log.txt

...
- shell脚本编写 link
Shell 脚本(shell script),是一种为 shell 编写的脚本程序。shell script是一种解释型语言,必须由解释器来执行这些脚本,执行时,解释器将脚本一行一行地转换为代码。 这个解释器就是Shell,它是一个用 C 语言编写的程序。 shell script,通常使用.sh作为扩展名。
# 列出docker容器ID,获取从第2行开始的containerId,再执行 docker start containerId
$ cat docker_start_all.sh
#!/bin/sh

docker start $(docker ps -a | awk '{ print $1}' | tail -n +2)
- 第一行的“#!”是一个约定的标记,它告诉系统这个脚本需要哪一种解释器来执行。
- 编写完shell脚本,在执行脚本前我们需要给脚本添加执行权限。
- 如果不加./,则系统会去PATH中的目录里面查找test.sh脚本,因为当前的目录没有配置在PATH中,所以会提示找不到命令。
- C10K问题与epoll
C10K问题:
随着互联网的普及,应用的用户群体几何倍增长,此时服务器性能问题就出现。最初的服务器是基于进程/线程模型。新到来一个TCP连接,就需要分配一个进程。假如有C10K,就需要创建1W个进程,可想而知单机是无法承受的。那么如何突破单机性能是高性能网络编程必须要面对的问题,进而这些局限和问题就统称为C10K问题。
本质:
C10K问题本质上是操作系统的问题。对于Web 1.0/2.0时代的操作系统,传统的同步阻塞I/O模型处理方式都是requests per second。当创建的进程或线程多了,数据拷贝频繁(缓存I/O、内核将数据拷贝到用户进程空间、阻塞,进程/线程上下文切换消耗大, 导致操作系统崩溃,这就是C10K问题的本质。
可见, 解决C10K问题的关键就是尽可能减少这些CPU资源消耗。
服务器安全
- XSS跨站点脚本攻击
跨站点脚本攻击,指攻击者通过篡改网页,嵌入恶意脚本程序,在用户浏览网页时,控制用户浏览器进行恶意操作的一种攻击方式。
如何防范XSS攻击: 防 XSS 的核心是必须对输入的数据做过滤处理。
- 前端,服务端,同时需要字符串输入的长度限制。
- 前端,服务端,同时需要对HTML转义处理。将其中的”<”,”>”等特殊字符进行转义编码。
CSRF攻击
跨站点请求伪造,指攻击者通过跨站请求,以合法的用户的身份进行非法操作。攻击者盗用你的身份,以你的名义向第三方网站发送恶意请求。CRSF能做的事情包括利用你的身份发邮件,发短信,进行交易转账,甚至盗取账号信息。
如何防范?
- 安全框架,例如Spring Security。
- token机制。在HTTP请求中进行token验证,如果请求中没有token或者token内容不正确,则认为CSRF攻击而拒绝该请求。
- 验证码。通常情况下,验证码能够很好的遏制CSRF攻击,但是很多情况下,出于用户体验考虑,验证码只能作为一种辅助手段,而不是最主要的解决方案。
- referer识别。在HTTP Header中有一个字段Referer,它记录了HTTP请求的来源地址。如果Referer是其他网站,就有可能是CSRF攻击,则拒绝该请求。但是,服务器并非都能取到Referer。很多用户出于隐私保护的考虑,限制了Referer的发送。在某些情况下,浏览器也不会发送Referer,例如HTTPS跳转到HTTP。
所以:
- 验证请求来源地址;
- 关键操作添加验证码;
- 在请求地址添加 token 并验证。
文件上传漏洞是如何发生的?
文件上传漏洞,指的是用户上传一个可执行的脚本文件,并通过此脚本文件获得了执行服务端命令的能力。富文本编辑器可能遭受此攻击,被攻击者上传恶意代码,有可能服务端就被人黑了。
如何防范?
- 文件上传的目录设置为不可执行。
- 判断文件类型,对上传的文件类型进行白名单校验,只允许上传可靠类型。
- 上传的文件需要进行重新命名,使攻击者无法猜想上传文件的访问路径,将极大地增加攻击成本。
- 限制上传文件的大小。
- 单独设置文件服务器的域名。
加密算法(RSA、AES、MD5、SHA)
SHA即安全散列算法(Secure Hash Algorithm)。SHA其实是一个算法家族,由美国国家安全局(NSA)开发,有SHA1、SHA2、SHA3三类,目前SHA1已经被破解,使用比较广泛的是SHA2类。
SHA256算法原理 link
安全散列算法,即是将一段接收到的message通过哈希算法将其转换成固定位数的哈希值(也称消息摘要)。SHA256就是将message通过哈希算法计算得到一个256位的哈希值。