cbirdcn.github.io
http://www.zhzq.site
服务端重点-云服务
云服务
腾讯、阿里、新浪、aws云产品与运维
产品介绍与使用
- ecs、cdn、serverless、aws lambda、redis、tcaplusdb、mysql、mongodb、cmq、k8s、docker、domain、https
云原生
怎么理解云原生
云原生的技术范畴
第一部分是云应用的开发: 偏向云原生应用的定义,镜像制作,CI/CD的配置,数据库等
第二部分是云应用的编排和管理流程: 这是Kubernetes比较关注的部分。包括了应用编排和调度,服务发现治理,远程调用,API网关以及Service Mesh
第三部分是监控和可观测性: 强调云上应用如何进行监控,日志收集等
第四部分: 底层技术:涉及到容器运行时的云原生存储技术和云原生网络技术。
第五部分: 云原生工具集: 容器镜像仓库,云原生安全技术等
第六部分: Serverless: 什么是无服务器计算? “构建或者使用一个微服务或者微功能来响应一个事件” 访问的时候,调入相关资源开始运行,运行完成后,卸载所有的开销,真正做到按需按次计费。
Serveless是一种构建和管理基于微服务架构的完整流程,允许在服务部署级别而不是服务器部署级别来管理应用部署。
Serveless真正做到了部署应用无须设计基础设施的建设,实现自动构建,部署和启动服务。
云原生两个理论基础:
- 不可变基础设施
应用的基础设施不可变,通过容器镜像实现。
- 云应用编排理论
与K8s相关的容器设计模式
云原生关键技术点:
- 如何构建自包含,可定制的应用镜像
- 是否能实现应用快速部署和隔离能力
- 应用基础设施创建和销毁的自动化管理
- 可复制的管控系统和支组件
IaaS、PaaS、PaaS、SaaS
IaaS 提供底层云计算服务。如服务器和虚拟机,存储空间,网络和操作系统。
PaaS 可以按需提供开发,测试交付和管理应用程序所需的环境,包括中间件和数据库等
SaaS 直接提供现成的软件服务
镜像制作
CI/CD的配置
云应用的编排和管理流程
k8s的架构?
什么是K8s的Operator?
K8s Master和Worker有什么组件?
Master:
- etcd
- controller
- scheduler
- api server
Worker:
- kubelet
- kube-proxy
- Pod
todo
docker、命令、用法、网络、网段、dockerfile、docker-compose link link practice

Dcoker基本概念
Docker 包括三个基本概念:
- 镜像(Image):Docker 镜像是一个特殊的文件系统,除了提供容器运行时所需的程序、库、资源、配置等文件外,还包含了一些为运行时准备的一些配置参数(如匿名卷、环境变量、用户等)。镜像不包含任何动态数据,其内容在构建之后也不会被改变。
- 容器(Container):镜像(Image)和容器(Container)的关系,就像是面向对象程序设计中的 类 和 实例 一样,镜像是静态的定义,容器是镜像运行时的实体。容器可以被创建、启动、停止、删除、暂停等。
- 仓库(Repository):仓库(Repository)类似Git的远程仓库,集中存放镜像文件。
三者关系:

服务
-
查看Docker版本信息 docker version
-
查看docker简要信息 docker -v
-
启动Docker systemctl start docker
-
关闭docker systemctl stop docker
-
设置开机启动 systemctl enable docker
-
重启docker服务 service docker restart
-
关闭docker服务 service docker stop
-
镜像仓库 Docker Hub 等镜像仓库上有大量的高质量的镜像可以用,可以从仓库获取镜像。
-
检索镜像 docker search 关键字
-
拉取镜像 docker pull [选项] [Docker Registry 地址[:端口号]/]仓库名[:标签]
镜像管理
-
列出镜像 docker image ls docker images
-
删除镜像 # 删除指定镜像 docker rmi <镜像Id>
-
导出镜像 # 将镜像保存为归档文件 docker save
-
导入镜像 docker load
-
Dockerfile构建镜像 Dockerfile 是一个文本格式的配 文件,用户可以使用 Dockerfile 来快速创建自定义的镜像。
Dockerfile 由一行行行命令语句组成,并且支持以#开头的注释行.
-
Dockerfile常见指令 下面是Dockerfile中一些常见的指令:
- FROM:指定基础镜像
- RUN:执行命令
- COPY:复制文件
- ADD:更高级的复制文件
- CMD:容器启动命令
- ENV:设置环境变量
- EXPOSE:暴露端口
- 其它的指令还有ENTRYPOINT、ARG、VOLUME、WORKDIR、USER、HEALTHCHECK、ONBUILD、LABEL等等。
- 实际上有docker-compose编排容器的情况下,Dockerfile只需要保留FROM、ARG、RUN、ADD、WORKDIR即可,其他由compose.yml配置
以下是一个Dockerfile实例:
 FROM java:8
 MAINTAINER "jinshw"<jinshw@qq.com>
 ADD mapcharts-0.0.1-SNAPSHOT.jar mapcharts.jar
 EXPOSE 8080
 CMD java -jar mapcharts.jar
-
镜像构建 docker build
-
镜像运行 镜像运行,就是新建并运行一个容器。
docker run [镜像ID]
- 容器生命周期 启动:启动容器有两种方式,一种是基于镜像新建一个容器并启动,另外一个是将在终止状态(stopped)的容器重新启动。 # 新建并启动 docker run [镜像名/镜像ID] ```shell $ docker run –help
Usage: docker run [OPTIONS] IMAGE [COMMAND] [ARG…]
Run a command in a new container
Options: –add-host list Add a custom host-to-IP mapping (host:ip) -a, –attach list Attach to STDIN, STDOUT or STDERR –blkio-weight uint16 Block IO (relative weight), between 10 and 1000, or 0 to disable (default 0) –blkio-weight-device list Block IO weight (relative device weight) (default []) –cap-add list Add Linux capabilities –cap-drop list Drop Linux capabilities –cgroup-parent string Optional parent cgroup for the container –cidfile string Write the container ID to the file –cpu-period int Limit CPU CFS (Completely Fair Scheduler) period –cpu-quota int Limit CPU CFS (Completely Fair Scheduler) quota –cpu-rt-period int Limit CPU real-time period in microseconds –cpu-rt-runtime int Limit CPU real-time runtime in microseconds -c, –cpu-shares int CPU shares (relative weight) –cpus decimal Number of CPUs –cpuset-cpus string CPUs in which to allow execution (0-3, 0,1) –cpuset-mems string MEMs in which to allow execution (0-3, 0,1) -d, –detach Run container in background and print container ID –detach-keys string Override the key sequence for detaching a container –device list Add a host device to the container –device-cgroup-rule list Add a rule to the cgroup allowed devices list –device-read-bps list Limit read rate (bytes per second) from a device (default []) –device-read-iops list Limit read rate (IO per second) from a device (default []) –device-write-bps list Limit write rate (bytes per second) to a device (default []) –device-write-iops list Limit write rate (IO per second) to a device (default []) –disable-content-trust Skip image verification (default true) –dns list Set custom DNS servers –dns-option list Set DNS options –dns-search list Set custom DNS search domains –domainname string Container NIS domain name –entrypoint string Overwrite the default ENTRYPOINT of the image -e, –env list Set environment variables –env-file list Read in a file of environment variables –expose list Expose a port or a range of ports –gpus gpu-request GPU devices to add to the container (‘all’ to pass all GPUs) –group-add list Add additional groups to join –health-cmd string Command to run to check health –health-interval duration Time between running the check (ms|s|m|h) (default 0s) –health-retries int Consecutive failures needed to report unhealthy –health-start-period duration Start period for the container to initialize before starting health-retries countdown (ms|s|m|h) (default 0s) –health-timeout duration Maximum time to allow one check to run (ms|s|m|h) (default 0s) –help Print usage -h, –hostname string Container host name –init Run an init inside the container that forwards signals and reaps processes -i, –interactive Keep STDIN open even if not attached –ip string IPv4 address (e.g., 172.30.100.104) –ip6 string IPv6 address (e.g., 2001:db8::33) –ipc string IPC mode to use –isolation string Container isolation technology –kernel-memory bytes Kernel memory limit -l, –label list Set meta data on a container –label-file list Read in a line delimited file of labels –link list Add link to another container –link-local-ip list Container IPv4/IPv6 link-local addresses –log-driver string Logging driver for the container –log-opt list Log driver options –mac-address string Container MAC address (e.g., 92:d0:c6:0a:29:33) -m, –memory bytes Memory limit –memory-reservation bytes Memory soft limit –memory-swap bytes Swap limit equal to memory plus swap: ‘-1’ to enable unlimited swap –memory-swappiness int Tune container memory swappiness (0 to 100) (default -1) –mount mount Attach a filesystem mount to the container –name string Assign a name to the container –network network Connect a container to a network –network-alias list Add network-scoped alias for the container –no-healthcheck Disable any container-specified HEALTHCHECK –oom-kill-disable Disable OOM Killer –oom-score-adj int Tune host’s OOM preferences (-1000 to 1000) –pid string PID namespace to use –pids-limit int Tune container pids limit (set -1 for unlimited) –platform string Set platform if server is multi-platform capable –privileged Give extended privileges to this container -p, –publish list Publish a container’s port(s) to the host -P, –publish-all Publish all exposed ports to random ports –read-only Mount the container’s root filesystem as read only –restart string Restart policy to apply when a container exits (default “no”) –rm Automatically remove the container when it exits –runtime string Runtime to use for this container –security-opt list Security Options –shm-size bytes Size of /dev/shm –sig-proxy Proxy received signals to the process (default true) –stop-signal string Signal to stop a container (default “SIGTERM”) –stop-timeout int Timeout (in seconds) to stop a container –storage-opt list Storage driver options for the container –sysctl map Sysctl options (default map[]) –tmpfs list Mount a tmpfs directory -t, –tty Allocate a pseudo-TTY –ulimit ulimit Ulimit options (default []) -u, –user string Username or UID (format: <name|uid>[:<group|gid>]) –userns string User namespace to use –uts string UTS namespace to use -v, –volume list Bind mount a volume –volume-driver string Optional volume driver for the container –volumes-from list Mount volumes from the specified container(s) -w, –workdir string Working directory inside the container
其中,重要参数有:
```shell
  -d, --detach                         Run container in background and print container ID(后台运行容器)
  -e, --env list                       Set environment variables(环境变量)
  -i, --interactive                    Keep STDIN open even if not attached(允许标准输入输出)
      --link list                      Add link to another container(能与其他容器联通网络)
      --name string                    Assign a name to the container(容器命名)
      --network network                Connect a container to a network(将容器连接到某个网络模式)
  -p, --publish list                   Publish a container's port(s) to the host(映射一个端口到宿主机, -p hostPort:containerPort)
  -P, --publish-all                    Publish all exposed ports to random ports(映射容器Dockerfile中开放的所有端口到宿主机)
      --rm                             Automatically remove the container when it exits(临时容器,关闭shell后立即删除容器)
  -t, --tty                            Allocate a pseudo-TTY(分配一个虚拟终端)
  -v, --volume list                    Bind mount a volume(挂载卷,-v hostVolume:containerVolume)
  -w, --workdir string                 Working directory inside the container(进入容器后的工作路径)
  IMAGE                                OPTIONS后面的IMAGE表示镜像,可以用镜像ID或"镜像名:tag版本号",比如"nginx:latest"
# 假设想要使用镜像mysql:tag(tag为下载的镜像版本号),以及宿主机上的配置文件,创建一个名为some-mysql的容器
$ docker run --name some-mysql -v /my/custom:/etc/mysql/conf.d -e MYSQL_ROOT_PASSWORD=my-secret-pw -d mysql:tag
# 这样宿主机的配置文件就被挂载到实例里面了。请注意,顺序为"host:container",挂载卷的关键是:修改了任何一方,都会同步到另一方。
# -e 参数用于给环境变量MYSQL_ROOT_PASSWORD设置值,也就是mysql密码。 -d表示将实例运行在后台。

# 使用镜像nginx:latest以后台模式启动一个容器,并将容器的80端口映射到主机随机端口。
# 因为nginx镜像默认开放了80端口出来。-P就可以把容器中开放的所有端口映射到宿主机。
$ docker run -P -d nginx:latest
# 现在如果只想映射一个端口,并且不是镜像中开放的端口,还要让映射到主机的是和实例不同的端口时(同样是"host:container"的顺序)
$ docker run -p 8080:80 -v /data:/data -d nginx:latest
# 启动已终止容器 docker start [容器ID]
-
查看容器 # 列出本机运行的容器 $ docker ps # 列出本机所有的容器(包括停止和运行) $ docker ps -a
-
停止容器 # 停止运行的容器 docker stop [容器ID] # 杀死容器进程 docker kill [容器ID]
-
重启容器 docker restart [容器ID]
-
删除容器 docker rm [容器ID]
-
进入容器 进入容器有两种方式:
如果从这个 stdin 中 exit,会导致容器的停止
docker attach [容器ID] # 交互式进入容器 docker exec [容器]
# 以交互模式启动容器实例,并在容器内执行/bin/bash命令。 $ docker exec -it containerID /bin/bash $ docker exec -it mysql /bin/sh # sh一般设成bash的软链 # 容器CONTAINER可以是容器ID,也可以是容器NAME -
进入容器通常使用第二种方式,docker exec后面跟的常见参数如下:
- d, –detach 在容器中后台执行命令; - i, –interactive=true I false :打开标准输入接受用户输入命令; - t, –tty:分配一个伪tty; - w, –workdir string进入路径
导出和导入
- 导出容器
-
导出一个已经创建的容器到一个文件 docker export [容器ID]
- 导入容器
- 导出的容器快照文件可以再导入为镜像 docker import [路径]
其它
- 查看日志 docker logs [容器ID]
$ docker logs --help

Usage:  docker logs [OPTIONS] CONTAINER

Fetch the logs of a container

Options:
      --details        Show extra details provided to logs
  -f, --follow         Follow log output
      --since string   Show logs since timestamp (e.g. 2013-01-02T13:23:37) or relative (e.g. 42m for 42 minutes)
      --tail string    Number of lines to show from the end of the logs (default "all")
  -t, --timestamps     Show timestamps
      --until string   Show logs before a timestamp (e.g. 2013-01-02T13:23:37) or relative (e.g. 42m for 42 minutes)
翻译:
- f : 跟踪(follow)日志输出 –since :显示某个开始时间戳的所有日志 –until:直到某个时间戳
- t : 显示时间戳 –tail :仅列出最新N条容器日志
复制文件
- 从主机复制到容器(从前到后)
docker cp host_path containerID:container_path -
从容器复制到主机
docker cp containerID:container_path host_path - docker-compose link
Compose 项目是 Docker 官方的开源项目,负责实现对 Docker 容器集群的快速编排。
Compose 定位是 「定义和运行多个 Docker 容器的应用(Defining and running multi-container Docker applications)」
虽然使用一个 Dockerfile 模板文件,可以让用户很方便的定义一个单独的应用容器。然而,在日常工作中,经常会碰到需要多个容器相互配合来完成某项任务的情况。例如要实现一个 Web 项目,除了 Web 服务容器本身,往往还需要再加上后端的数据库服务容器,甚至还包括负载均衡容器等。
Compose 恰好满足了这样的需求。它允许用户通过一个单独的 docker-compose.yml 模板文件(YAML 格式)来定义一组相关联的应用容器为一个项目(project)。
Compose 项目由 Python 编写,实现上调用了 Docker 服务提供的 API 来对容器进行管理。
命令:
$ docker-compose
Define and run multi-container applications with Docker.

Usage:
  docker-compose [-f <arg>...] [options] [--] [COMMAND] [ARGS...]
  docker-compose -h|--help

Options:
  -f, --file FILE             Specify an alternate compose file
                              (default: docker-compose.yml)
  -p, --project-name NAME     Specify an alternate project name
                              (default: directory name)
  -c, --context NAME          Specify a context name
  --verbose                   Show more output
  --log-level LEVEL           Set log level (DEBUG, INFO, WARNING, ERROR, CRITICAL)
  --no-ansi                   Do not print ANSI control characters
  -v, --version               Print version and exit
  -H, --host HOST             Daemon socket to connect to

  --tls                       Use TLS; implied by --tlsverify
  --tlscacert CA_PATH         Trust certs signed only by this CA
  --tlscert CLIENT_CERT_PATH  Path to TLS certificate file
  --tlskey TLS_KEY_PATH       Path to TLS key file
  --tlsverify                 Use TLS and verify the remote
  --skip-hostname-check       Don't check the daemon's hostname against the
                              name specified in the client certificate
  --project-directory PATH    Specify an alternate working directory
                              (default: the path of the Compose file)
  --compatibility             If set, Compose will attempt to convert keys
                              in v3 files to their non-Swarm equivalent (DEPRECATED)
  --env-file PATH             Specify an alternate environment file

Commands:
  build              Build or rebuild services
  config             Validate and view the Compose file
  create             Create services
  down               Stop and remove containers, networks, images, and volumes
  events             Receive real time events from containers
  exec               Execute a command in a running container
  help               Get help on a command
  images             List images
  kill               Kill containers
  logs               View output from containers
  pause              Pause services
  port               Print the public port for a port binding
  ps                 List containers
  pull               Pull service images
  push               Push service images
  restart            Restart services
  rm                 Remove stopped containers
  run                Run a one-off command
  scale              Set number of containers for a service
  start              Start services
  stop               Stop services
  top                Display the running processes
  unpause            Unpause services
  up                 Create and start containers
  version            Show version information and quit
最重要的是:
Options:
  -f, --file FILE             Specify an alternate compose file
                              (default: docker-compose.yml)
  -p, --project-name NAME     Specify an alternate project name
                              (default: directory name)

Commands:
  build              Build or rebuild services
  up                 Create and start containers
官方快速说明:
Using Docker Compose is basically a three-step process:

Define your app's environment with a Dockerfile so it can be reproduced anywhere.
Define the services that make up your app in docker-compose.yml so they can be run together in an isolated environment.
Lastly, run docker compose up and Compose will start and run your entire app.
A Compose file looks like this:

services:
  web:
    build: .
    ports:
      - "5000:5000"
    volumes:
      - .:/code
  redis:
    image: redis
实际举例LNMP:
# docker-dompose.dev.yml

version: "2.0"

services:
  nginx:
    build:
      context: ./nginx
      args:
      - USER_ID
      - GROUP_ID
    container_name: "nginx"
    volumes:
    - "..:/var/www"
    ports:
    - "80:80"
    links:
    - php-fpm:php-fpm
    logging:
      options:
        max-size: "10m"
        max-file: "3"
  php-fpm:
    build:
      context: ./php-fpm
      args:
#      - USER_ID
#      - GROUP_ID
      - PHP_XDEBUG_INSTALL="false"
    container_name: "php-fpm"
    volumes:
    - "..:/var/www"
    #- $HOME/.aws:/home/www-data/.aws:ro
    links:
    - redis
    - mysql
    environment:
    - APP_ENV
    logging:
      options:
        max-size: "10m"
        max-file: "3"
  redis:
    image: "redis:3-alpine3.8"
    container_name: "redis"
    ports:
    - "6379:6379"
    volumes:
      - /data/storage/redis:/data
    command: redis-server --appendonly yes
    logging:
      options:
        max-size: "10m"
        max-file: "3"
  mysql:
    container_name: "mysql"
    build:
      context: ./mysql
      args:
      - USER_ID
      - GROUP_ID
    ports:
    - "3306:3306"
    volumes:
    - /data/storage/mysql:/var/lib/mysql
    - /data/storage/logs/mysql:/var/log/mysql
    - ./mysql/initdb.d:/docker-entrypoint-initdb.d
    environment:
      MYSQL_ROOT_PASSWORD: root
      TZ: "Asia/Shanghai"
    command: --innodb-use-native-aio=0
    logging:
      options:
        max-size: "10m"
        max-file: "3"
对应的Dockerfile
# nginx/Dockerfile

FROM nginx:1.13-alpine
#ENV HTTPS_PROXY http://proxy:port
#ENV HTTP_PROXY http://proxy:port
ARG USER_ID
ARG GROUP_ID
RUN echo "http://mirrors.aliyun.com/alpine/v3.7/main" > /etc/apk/repositories && \
    echo "http://mirrors.aliyun.com/alpine/v3.7/community" >> /etc/apk/repositories && \
    apk add --update --no-cache tzdata shadow && \
    cp /usr/share/zoneinfo/Asia/Tokyo /etc/localtime && \
    echo "Asia/Shanghai" > /etc/timezone && \
    usermod -u ${USER_ID:-1000} nginx && groupmod -g ${GROUP_ID:-1000} nginx && \
    apk del tzdata && \
    mkdir -p /var/www
ADD conf/nginx.conf /etc/nginx/nginx.conf
ADD conf/default.conf /etc/nginx/conf.d/default.conf
WORKDIR /var/www
# mysql/Dockerfile

FROM mysql:5.7
ARG USER_ID
ARG GROUP_ID
EXPOSE 3306
ADD ./conf/my.cnf /etc/mysql/conf.d/my.cnf
RUN usermod -u ${USER_ID:-1000} mysql && \
    groupmod -g ${GROUP_ID:-1000} mysql && \
    chown -R mysql:mysql /var/log/mysql && \
    chown mysql:mysql /etc/mysql/conf.d/my.cnf && \
    chmod 700 /etc/mysql/conf.d/my.cnf
CMD ["mysqld"]
# php-fpm 略
# 配置文件略
BUILD & RUN
举例:
$ docker-compose -f docker-compose.developer.yml -p developer build --no-cache
$ APP_ENV=developer docker-compose -f docker-compose.developer.yml -p developer up -d

# docker-compose -f 指定yml文件。所有docker-compose的命令都需要能用-f指定文件或文件就在当前目录下。-p projectName。
# docker-compose build --no-cache,表示Do not use cache when building the image
# APP_ENV是yml中配置的环境变量参数,可以在启动时传入。up表示启动。-d表示后台。
- 网络
容器创建时可以指定network名称,不指定则会使用默认名称,然而不同network间局域网ip网段不同,无法ping通。如何解决?
# 列出网络模式列表
$ docker network ls
NETWORK ID          NAME                  DRIVER              SCOPE
a33247c58ae6        bridge                bridge              local
00dc3fe05a68        developer_default     bridge              local
4fe31116c0ad        host                  host                local
74f54669cf3f        none                  null                local
faf760c7e10b        staticnet             bridge              local

# 默认的网桥模式网络:bridge。查看此网络模式正在被哪些容器所连接
$ docker network inspect bridge
...
            "...": {
                "Name": "consul_server_1",
                ...
                "IPv4Address": "172.17.0.8/16",
                "IPv6Address": ""
            }
...
自定义的网桥模式网络:developer_default
$ docker network inspect developer_default
...
            "...": {
                "Name": "redis",
                ...
                "IPv4Address": "172.18.0.8/16",
                "IPv6Address": ""
            }
...
由于容器启动后,同属一个网络下(默认一般是桥接)的容器彼此能根据对方的name彼此ping通。
但是在上面LNMP环境使用docker-compose RUN时,他为我们新创建了一个虚拟网络developer_default。app中的容器启动后都加入到了这个虚拟网络中。而独立RUN的实例,比如consul,使用了默认的网络bridge。
所以,上面的实例中,默认都是172.17.0.X,自定义网络都是172.18.0.X。在redis中就无法直接ping通consul。
现在需要让两个局域网的容器能互通。途径是新建一个my-bridge网桥,将所有容器加入进这个新建网桥中。
注意:容器加入新局域网时,不会离开旧局域网,而是同时可以连接两个局域网络。
# 以桥接模式,创建新的局域网,名称叫做my-bridge
$ docker network create --driver bridge my-bridge

# 加入两个容器到新网桥模式
$ docker network connect my-bridge redis
$ docker network connect my-bridge consul_server_1

# 查看实例的网络情况
$ docker inspect consul_server_1 | grep IPAddress
            "SecondaryIPAddresses": null,
            "IPAddress": "172.17.0.8",
                    "IPAddress": "172.17.0.8",
                    "IPAddress": "172.21.0.3",
$ docker inspect redis | grep IPAddress
            "SecondaryIPAddresses": null,
            "IPAddress": "",
                    "IPAddress": "172.18.0.8",
                    "IPAddress": "172.21.0.2",
此时,相当于两个实例都连入了新创建的局域网172.21.0.x中,所以两个实例就可以ping通了。
还有个问题,每次启动实例时,docker会给它自动分配一个ip。这个ip不见得就是上次使用过的ip。
联想起yml文件中,nginx依赖于php-fpm实例,使用了如下语法:
    links:
    - php-fpm:php-fpm
这便能解决ip动态变化的问题。这样在可以互相连通的实例中,就可以用容器名称代替ip了。hosts文件会自动解析成ip。
另外如果想在实例内访问宿主机,因为localhost代表实例本身。所以要用host.docker.internal才能访问宿主机。
应用编排和调度,比较k8s与docker swarm link
kubernates的编排思想是,它根本不关系底层的容器是Docker还是其他的容器技术,它站在更高的角度上,允许让用户以yaml的方式去描述自己的应用,去描述哪几个镜像启动后应在绑定在一起(在一个Pod里,而不是像Docker Swarm那样,由Docker Swarm去为单个容器找一个合适的Node),允许用户指定Pod的数量,还为用户提供了 网关、监控、备份、水平扩展、滚动更新、保持指定数量的副本数、负载均衡等功能。
todo
服务发现治理的原理及其应用、实现
conul
etcd
zookeeper
todo
远程调用
API网关
Service Mesh
云上应用如何进行监控,日志收集
efk
prometheus、fluentd
云原生工具集:容器镜像仓库,云原生安全技术等
Serverless(无服务器计算):构建或者使用一个微服务或者微功能来响应一个事件。访问的时候,调入相关资源开始运行,运行完成后,卸载所有的开销,真正做到按需按次计费。构建和管理基于微服务架构的完整流程,允许在服务部署级别而不是服务器部署级别来管理应用部署。部署应用无须设计基础设施的建设,实现自动构建,部署和启动服务。
tcaplusdb原理、使用、应用
移动游戏存储需求 移动游戏具有时间碎片化、玩家间交互较多、数据量大的特点,普遍采用全区全服和分区分服的模式。游戏发展变化较快,运营活动较多。对数据存储服务有平滑、稳定、低时延、高吞吐的要求。
对应解决方案 TcaplusDB 专为游戏设计,采用分布式架构、冷热数据交换、自动区服合并等技术手段满足游戏业务高吞吐、低时延、全区全服、分区分服等需求。并且支持在不停服情况下无损扩缩容和过载保护等特性满足游戏活动运营、突发应对等需求。

cmq原理、使用、应用
CMQ 在微信红包系统的分布式事务问题上得到了体现,微信架构组在红包系统引入了 CMQ,避免分布式事务增加对系统的开销。当资金入账失败时,账户系统将不断从 CMQ 重新拉取重试此更新操作,保证入账消息永远不丢,避免入账失败回滚和频繁轮询数据库等弊端发生。

redis
Redis的数据结构及其实现、使用场景 link
- String(字符串) Redis中String是可以修改的,称为动态字符串(Simple Dynamic String 简称 SDS) 说是字符串但它的内部结构更像是一个 ArrayList,内部维护着一个字节数组,并且在其内部预分配了一定的空间,以减少内存的频繁分配。
Redis的内存分配机制是这样:
当字符串的长度小于 1MB时,每次扩容都是加倍现有的空间。 如果字符串长度超过 1MB时,每次扩容时只会扩展 1MB 的空间。
这样既保证了内存空间够用,还不至于造成内存的浪费,字符串最大长度为 512MB。
Redis内部有很多优化方案,为更合理的使用内存,不同长度的字符串采用不同的数据类型表示,且在创建字符串的时候 len 会和 capacity 一样大,不产生冗余的空间,所以String值可以是字符串、数字(整数、浮点数) 或者 二进制。
- list(列表)
Redis中的list和Java中的LinkedList很像,底层都是一种链表结构, list的插入和删除操作非常快,时间复杂度为 0(1),不像数组结构插入、删除操作需要移动数据。
像归像,但是redis中的list底层可不是一个双向链表那么简单。
当数据量较少的时候它的底层存储结构为一块连续内存,称之为ziplist(压缩列表),它将所有的元素紧挨着一起存储,分配的是一块连续的内存;当数据量较多的时候将会变成quicklist(快速链表)结构。
可单纯的链表也是有缺陷的,链表的前后指针 prev 和 next 会占用较多的内存,会比较浪费空间,而且会加重内存的碎片化。在redis 3.2之后就都改用ziplist+链表的混合结构,称之为 quicklist(快速链表)。
压缩列表为了支持双向遍历,所以才会有 ztail_offset 这个字段,用来快速定位到最后一个元素,然后倒着遍历。 entry它的 prevlen 字段表示前一个 entry 的字节长度,当压缩列表倒着遍历时,需要通过这个字段来快速定位到下一个元素的位置。
应用场景:
由于list它是一个按照插入顺序排序的列表,所以应用场景相对还较多的,例如:
消息队列:lpop和rpush(或者反过来,lpush和rpop)能实现队列的功能 朋友圈的点赞列表、评论列表、排行榜:lpush命令和lrange命令能实现最新列表的功能,每次通过lpush命令往列表里插入新的元素,然后通过lrange命令读取最新的元素列表。
特殊命令:
llen  [key]     返回该列表的元素个数
lrem [key] [count] [value]  删除列表中与value相等的元素,count是删除的个数。 count>0 表示从左侧开始查找,删除count个元素,count<0 表示从右侧开始查找,删除count个相同元素,count=0 表示删除全部相同的元素
lindex [key] [index]  获取list指定下标的元素 (需要遍历,时间复杂度为O(n))index 代表元素下标,index 可以为负数, index= 表示倒数第一个元素,同理 index=-2 表示倒数第二 个元素。
lrange [key]  [start_index] [end_index]   获取list 区间内的所有元素 (时间复杂度为 O(n))
ltrim  [key]  [start_index] [end_index]   保留区间内的元素,其他元素删除(时间复杂度为 O(n))
- hash (字典)
Redis 中的 Hash和 Java的 HashMap 更加相似,都是数组+链表的结构,当发生 hash 碰撞时将会把元素追加到链表上,值得注意的是在 Redis 的 Hash 中 value 只能是字符串.
Hash 和String都可以用来存储用户信息 ,但不同的是Hash可以对用户信息的每个字段单独存储;String存的是用户全部信息经过序列化后的字符串,如果想要修改某个用户字段必须将用户信息字符串全部查询出来,解析成相应的用户信息对象,修改完后在序列化成字符串存入。而 hash可以只对某个字段修改,从而节约网络流量,不过hash内存占用要大于 String,这是 hash 的缺点。
操作命令:
hgetall [key] 获取指定key 字典里的所有字段和值 (字段信息过多,会导致慢查询 慎用:亲身经历 曾经用过这个这个指令导致线上服务故障)
- set(集合)
Redis 中的 set和Java中的HashSet 有些类似,它内部的键值对是无序的、唯一 的。它的内部实现相当于一个特殊的字典,字典中所有的value都是一个值 NULL。当集合中最后一个元素被移除之后,数据结构被自动删除,内存被回收。
应用场景:
- 好友、关注、粉丝、感兴趣的人集合:
- 1) sinter命令可以获得A和B两个用户的共同好友;
- 2) sismember命令可以判断A是否是B的好友;
- 3) scard命令可以获取好友数量;
- 4) 关注时,smove命令可以将B从A的粉丝集合转移到A的好友集合
- 首页展示随机:美团首页有很多推荐商家,但是并不能全部展示,set类型适合存放所有需要展示的内容,而srandmember命令则可以从中随机获取几个。
- 存储某活动中中奖的用户ID ,因为有去重功能,可以保证同一个用户不会中奖两次。
命令:
sismember [key] [value]   判断集合中是否存在某个value
scard [key]    获取集合的长度
spop  [key]   弹出一个元素
srem [key] [value]  删除指定元素
- zset(有序集合)
zset也叫SortedSet一方面它是个 set ,保证了内部 value 的唯一性,另方面它可以给每个 value 赋予一个score,代表这个value的排序权重。它的内部实现用的是一种叫作“跳跃列表”的数据结构。
场景:
- zset 可以用做排行榜,但是和list不同的是zset它能够实现动态的排序,例如: 可以用来存储粉丝列表,value 值是粉丝的用户 ID,score 是关注时间,我们可以对粉丝列表按关注时间进行排序。
- zset 还可以用来存储学生的成绩, value 值是学生的 ID, score 是他的考试成绩。 我们对成绩按分数进行排序就可以得到他的名次。
命令:
zrange [key] [start_index] [end_index] 获取下标范围内的元素列表,按score 排序输出
zrevrange [key] [start_index] [end_index]  获取范围内的元素列表 ,按score排序 逆序输出
zrank [key] [value]  获取元素再集合中的排名
zscore [key] [value] 获取元素的score
zrangebyscore [key] [score1] [score2]  输出score范围内的元素列表
- 跳跃表是有序集合的底层实现之一
- Redis的跳跃表实现由zskiplist和zskiplistNode两个结构组成,其中zskiplist用于保存跳跃表信息(比如表头节点、表尾节点、长度),而zskiplistNode则用于表示跳跃表节点
- 每个跳跃表节点的层高都是1至32之间的随机数
- 在同一个跳跃表中,多个节点可以包含相同的分值,但每个节点的成员对象必须是唯一的。
- 跳跃表中的节点按照分值大小进行排序,当分值相同时,节点按照成员对象的大小进行排序。
- 跳表是一种实现起来很简单,单层多指针的链表,它查找效率很高,堪比优化过的二叉平衡树,且比平衡树好实现。
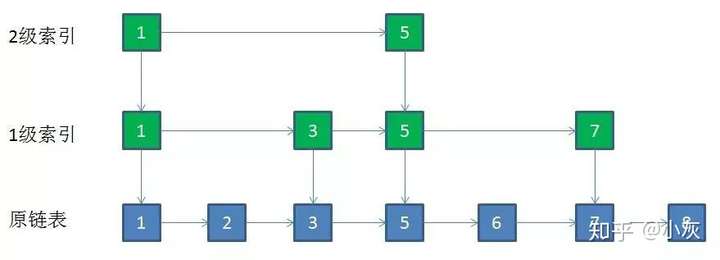 在多个节点中提拔部分节点到上一层形成索引,依次类推,极限情况是顶层只有2个节点。
当有新节点插入时,采用抛硬币方式,逐层判断是否要把新节点向上提升形成新索引。
跳表插入流程:
- 新节点和各层索引节点逐一比较,确定原链表的插入位置。O(logN)
- 把索引插入到原链表。O(1)
- 利用抛硬币的随机方式,决定新节点是否提升为上一级索引。结果为“正”则提升并继续抛硬币,结果为“负”则停止。O(logN) 总体上,跳跃表插入操作的时间复杂度是O(logN),而这种数据结构所占空间是2N,既空间复杂度是 O(N)。
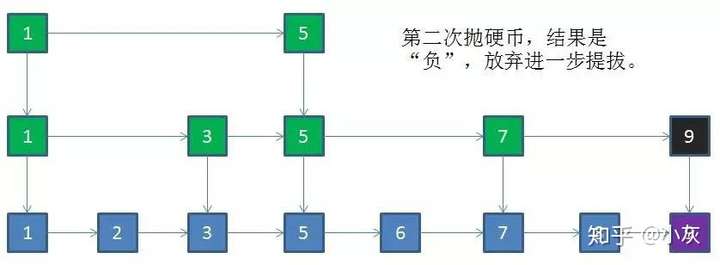
删除步骤:
- 自上而下,查找第一次出现节点的索引,并逐层找到每一层对应的节点。O(logN)
- 删除每一层查找到的节点,如果该层只剩下1个节点,删除整个一层(原链表除外)。O(logN) 总体上,跳跃表删除操作的时间复杂度是O(logN)。
跳表与二叉树的比较: 跳表优点是维持结构平衡的过程简单,完全靠随机。二叉查找树需要在多次插入删除后依靠rebalance平衡结构
为什么 redis 使用跳表而不使用红黑树?
- 红黑树在查找区间元素的效率没有跳表高,其他操作时间复杂度一致。
- 相比红黑树,跳表的实现还是简单的,简单就意味着不容易出错,bug 少,稳定,易读,易维护。 3、跳表更加灵活,通过改变索引构建策略,有效平衡效率和内存消耗。
是否使用过 Redis 集群,集群的原理是什么?集群方案什么情况下会导致整个集群不可用?哨兵是什么
集群原理是:
- Redis Sentinal(哨兵) 着眼于高可用, 在 master 宕机时会自动将 slave 提升为master, 继续提供服务。
- Redis Cluster(集群) 着眼于扩展性, 在单个 redis 内存不足时, 使用 Cluster 进行分片存储。
有 A, B, C 三个节点的集群,在没有复制模型的情况下,如果节点 B 失败了, 那么整个集群就会以为缺少 5501-11000 这个范围的槽而不可用。
Redis 集群没有使用一致性 hash,而是引入了哈希槽的概念, Redis 集群有16384 个哈希槽,每个key 通过 CRC16 校验后对 16384 取模来决定放置哪个槽, 集群的每个节点负责一部分 hash 槽。
为了使在部分节点失败或者大部分节点无法通信的情况下集群仍然可用, 所以集群使用了主从复制模型,每个节点都会有 N-1 个复制品.
Redis 集群目前无法做数据库选择, 默认在 0 数据库。
redis的slot槽为什么是16384 link
从心跳包的大小、网络带宽、心跳并发、压缩率等维度考虑,16384 个插槽比65535更有优势且能满足业务需求。
高可用(High Availability)软件是什么 link
高可用HA(High Availability)是分布式系统架构设计中必须考虑的因素之一,它通常是指,通过设计减少系统不能提供服务的时间。
很多公司的高可用目标是4个9,也就是99.99%,这就意味着,系统的年停机时间为8.76个小时。
单点是系统高可用的大敌
方法论上,高可用保证的原则是“集群化”,或者叫“冗余”:只有一个单点,挂了服务会受影响;如果有冗余备份,挂了还有其他backup能够顶上。
有了冗余之后,还不够,每次出现故障需要人工介入恢复势必会增加系统的不可服务实践。所以,又往往是通过“自动故障转移”来实现系统的高可用。
整个互联网分层系统架构的高可用,又是通过每一层的冗余+自动故障转移来综合实现的,具体的: -【客户端层】到【反向代理层】的高可用,是通过反向代理层的冗余实现的,常见实践是keepalived + virtual IP自动故障转移 -【反向代理层】到【站点层】的高可用,是通过站点层的冗余实现的,常见实践是nginx与web-server之间的存活性探测与自动故障转移 -【站点层】到【服务层】的高可用,是通过服务层的冗余实现的,常见实践是通过service-connection-pool来保证自动故障转移 -【服务层】到【缓存层】的高可用,是通过缓存数据的冗余实现的,常见实践是缓存客户端双读双写,或者利用缓存集群的主从数据同步与sentinel保活与自动故障转移;更多的业务场景,对缓存没有高可用要求,可以使用缓存服务化来对调用方屏蔽-复杂性 -【服务层】到【数据库“读”】的高可用,是通过读库的冗余实现的,常见实践是通过db-connection-pool来保证自动故障转移 -【服务层】到【数据库“写”】的高可用,是通过写库的冗余实现的,常见实践是keepalived + virtual IP自动故障转移
《redis设计与实现》
todo:略
Redis持久化机制(RDB、AOF),及其优缺点,适宜使用场景
Redis是一个支持持久化的内存数据库,通过持久化机制把内存中的数据同步到硬盘文件来保证数据持久化。当Redis重启后通过把硬盘文件重新加载到内存,就能达到恢复数据的目的。
实现:单独创建fork()一个子进程,将当前父进程的数据库数据复制到子进程的内存中,然后由子进程写入到临时文件中,持久化的过程结束了,再用这个临时文件替换上次的快照文件,然后子进程退出,内存释放。
- 快照(snapshotting)持久化(RDB持久化)
Redis可以通过创建快照来获得存储在内存里面的数据在某个时间点上的副本。Redis创建快照之后,可以对快照进行 备份,可以将快照复制到其他服务器从而创建具有相同数据的服务器副本(Redis主从结构,主要用来提高Redis性 能),还可以将快照留在原地以便重启服务器的时候使用。
快照持久化是Redis默认采用的持久化方式,在Redis.conf配置文件中默认有此下配置:
save 900 1 #在900秒(15分钟)之后,如果至少有1个key发生变化,Redis就会自动触发BGSAVE命令
创建快照。

save 300 10 #在300秒(5分钟)之后,如果至少有10个key发生变化,Redis就会自动触发BGSAVE命令创建快照。

save 60 10000 #在60秒(1分钟)之后,如果至少有10000个key发生变化,Redis就会自动触发BGSAVE命令创建快照。
- AOF(append-only file)持久化
与快照持久化相比,AOF持久化的实时性更好,因此已成为主流的持久化方案。默认情况下Redis没有开启 AOF(append only file)方式的持久化,可以通过appendonly参数开启:appendonly yes
开启AOF持久化后每执行一条会更改Redis中的数据的命令,Redis就会将该命令写入硬盘中的AOF文件。AOF文件的 保存位置和RDB文件的位置相同,都是通过dir参数设置的,默认的文件名是appendonly.aof。
在Redis的配置文件中存在三种不同的 AOF 持久化方式
appendfsync always #每次有数据修改发生时都会写入AOF文件,这样会严重降低Redis的速度
appendfsync everysec  #每秒钟同步一次,显式地将多个写命令同步到硬盘
appendfsync no  #让操作系统决定何时进行同步
为了兼顾数据和写入性能,用户可以考虑 appendfsync everysec选项 ,让Redis每秒同步一次AOF文件,Redis性能 几乎没受到任何影响。而且这样即使出现系统崩溃,用户最多只会丢失一秒之内产生的数据。当硬盘忙于执行写入操作的时候,Redis还会优雅的放慢自己的速度以便适应硬盘的最大写入速度。
AOF重写是一个有歧义的名字,该功能是通过读取数据库中的键值对来实现的,程序无须对现有AOF文件进行任伺读入、分析或者写入操作。
在执行 BGREWRITEAOF 命令时,Redis 服务器会维护一个 AOF 重写缓冲区,该缓冲区会在子进程创建新AOF文件期间,记录服务器执行的所有写命令。当子进程完成创建新AOF文件的工作之后,服务器会将重写缓冲区中的所有内容 追加到新AOF文件的末尾,使得新旧两个AOF文件所保存的数据库状态一致。最后,服务器用新的AOF文件替换旧的 AOF文件,以此来完成AOF文件重写操作。
- RDB 和 AOF 的混合持久化
Redis 4.0 开始支持 RDB 和 AOF 的混合持久化(默认关闭,可以通过配置项 aof-use-rdb-preamble 开启)。
如果把混合持久化打开,AOF 重写的时候就直接把 RDB 的内容写到 AOF 文件开头。这样做的好处是可以结合 RDB 和 AOF 的优点, 快速加载同时避免丢失过多的数据。当然缺点也是有的, AOF 里面的 RDB 部分是压缩格式不再是 AOF 格式,可读性较差。
Redis常见性能问题和解决方案
Master最好不要做任何持久化工作,如RDB内存快照和AOF日志文件
如果数据比较重要,某个Slave开启AOF备份数据,策略设置为每秒同步一次
为了主从复制的速度和连接的稳定性,Master和Slave最好在同一个局域网内
尽量避免在压力很大的主库上增加从库
Redis回收策略(淘汰策略)
Redis 内存数据集大小上升到一定大小的时候,就会施行这种策略。
6种内存淘汰策略:
- volatile-lru:从已设置过期时间的数据集(server.db[i].expires)中挑选最近最少使用的数据淘汰
- volatile-ttl:从已设置过期时间的数据集(server.db[i].expires)中挑选将要过期的数据淘汰
- volatile-random:从已设置过期时间的数据集(server.db[i].expires)中任意选择数据淘汰
- allkeys-lru:从数据集(server.db[i].dict)中挑选最近最少使用的数据淘汰
- allkeys-random:从数据集(server.db[i].dict)中任意选择数据淘汰
- no-enviction(驱逐):禁止驱逐数据
注意这里的 6 种机制,volatile 和 allkeys 规定了是对已设置过期时间的数据集淘汰数据还是从全部数据集淘汰数据, 后面的 lru、ttl 以及 random 是三种不同的淘汰策略, 再加上一种 no-enviction 永不回收的策略。
使用策略规则:
- 如果数据呈现幂律分布,也就是一部分数据访问频率高,一部分数据访问频率 低, 则使用 allkeys-lru
- 如果数据呈现平等分布, 也就是所有的数据访问频率都相同, 则使用allkeys-random
Redis 的同步机制了解么
Redis 可以使用主从同步,从从同步。
第一次同步时,主节点做一次 bgsave, 并同时将后续修改操作记录到内存 buffer, 待完成后将 rdb 文件全量同步到复制节点, 复制节点接受完成后将 rdb 镜像加载到内存。
加载完成后, 再通知主节点将期间修改的操作记录同步到复制节点进行重放就完成了同步过程。
Pipeline 有什么好处,为什么要用 pipeline
可以将多次 IO 往返的时间缩减为一次,前提是 pipeline 执行的指令之间没有因果相关性。
使用redis-benchmark 进行压测的时候可以发现影响 redis 的 QPS 峰值的一个重要因素是 pipeline 批次指令的数目。
Redis 如何设置密码及验证密码
设置密码: config set requirepass 123456 授权密码: auth 123456
Redis 集群的主从复制模型是怎样的
为了使在部分节点失败或者大部分节点无法通信的情况下集群仍然可用, 所以集群使用了主从复制模型,每个节点都会有 N-1 个复制品.
Redis 集群会有写操作丢失吗?为什么
Redis 并不能保证数据的强一致性,这意味着在实际中集群在特定的条件下可能会丢失写操作。
Redis 集群之间是如何复制的
异步复制
Redis 集群如何选择数据库
Redis 集群目前无法做数据库选择, 默认在 0 数据库。
怎么理解 Redis 事务?相关命令(MULTI、EXEC、DISCARD、WATCH)
事务是一个单独的隔离操作:事务中的所有命令都会序列化、按顺序地执行。事务在执行的过程中,不会被其他客户端发送来的命令请求所打断。
事务是一个原子操作:事务中的命令要么全部被执行,要么全部都不执行。
MULTI:
标记一个事务块的开始。
事务块内的多条命令会按照先后顺序被放进一个队列当中,最后由 EXEC 命令原子性(atomic)地执行。
EXEC:执行所有事务块内的命令。
假如某个(或某些) key 正处于 WATCH 命令的监视之下,且事务块中有和这个(或这些) key 相关的命令,那么 EXEC 命令只在这个(或这些) key 没有被其他命令所改动的情况下执行并生效,否则该事务被打断(abort)。
打断事务的意思是,该事务中的所有命令都没有执行成功。原因是事务是原子的。事务中的命令是入队存储后一起执行的,当判断无法执行后,就直接清空队列,exec提示nil。watch也自动被关闭。。
# client1
# 1.给a赋值
127.0.0.1:6379> set a b
OK
127.0.0.1:6379> set k v
OK
# 2.监视a
127.0.0.1:6379> watch a
OK
# 3.开始事务和命令入队
127.0.0.1:6379> multi
OK
127.0.0.1:6379> set k v1
QUEUED
# 5.提交事务
127.0.0.1:6379> exec
(nil)
# 6.事务提交失败,查值没有被修改。提交事务失败时自动unwatch,下一次multi不会受到watch监视。
127.0.0.1:6379> get k
"v"
# client2
# 4.修改a
127.0.0.1:6379> set a c
OK
WATCH key [key …]
监视一个(或多个) key ,如果在事务执行之前这个(或这些) key 被其他命令所改动,那么事务将被打断。
UNWATCH:取消 WATCH 命令对所有 key 的监视。
如果在执行 WATCH 命令之后, EXEC 命令或 DISCARD 命令先被执行了的话,那么就不需要再执行 UNWATCH 了。
因为 EXEC 命令会执行事务,因此 WATCH 命令的效果已经产生了;而 DISCARD 命令在取消事务的同时也会取消所有对 key 的监视,因此这两个命令执行之后,就没有必要执行 UNWATCH 了。
DISCARD:取消事务,放弃执行事务块内的所有命令。
如果正在使用 WATCH 命令监视某个(或某些) key,那么取消所有监视,等同于执行命令 UNWATCH 。
举例:
# 监视 key ,且事务成功执行

redis> WATCH lock lock_times
OK

redis> MULTI
OK

redis> SET lock "huangz"
QUEUED

redis> INCR lock_times
QUEUED

redis> EXEC
1) OK
2) (integer) 1


# 监视 key ,且事务被打断

redis> WATCH lock lock_times
OK

redis> MULTI
OK

redis> SET lock "joe"        # 就在这时,另一个客户端修改了 lock_times 的值
QUEUED

redis> INCR lock_times
QUEUED

redis> EXEC                  # 因为 lock_times 被修改, joe 的事务执行失败
(nil)
Redis key 的过期时间和永久有效分别怎么设置?
EXPIRE 和 PERSIST 命令
redis> SET mykey "Hello"
OK

redis> EXPIRE mykey 10  # 为 key 设置生存时间
(integer) 1

redis> TTL mykey
(integer) 10

redis> PERSIST mykey    # 移除 key 的生存时间
(integer) 1

redis> TTL mykey
(integer) -1
Redis 如何做内存优化
尽可能使用散列表( hashes), 散列表( 是说散列表里面存储的数少) 使用的内存非常小, 所以你应该尽可能的将你的数据模型抽象到一个散列表里面。
Redis 回收进程如何工作的
一个客户端运行了新的命令, 添加了新的数据。Redis 检查内存使用情况, 如果大于 maxmemory的限制, 则根据设定好的策略进行回收。一个新的命令被执行, 等等。
所以我们不断地穿越内存限制的边界, 通过不断达到边界然后不断地回收回到边界以下。如果一个命令的结果导致大量内存被使用(例如很大的集合的交集保存到一个新的键), 不用多久内存限制就会被这个内存使用量超越。
都有哪些办法可以降低 Redis 的内存使用情况呢
如果你使用的是 32 位的 Redis 实例,可以好好利用 Hash,list,sorted set,set 等集合类型数据, 因为通常情况下很多小的 Key-Value 可以用更紧凑的方式存放到一起。
Redis 的内存用完了会发生什么
如果达到设置的上限,Redis 的写命令会返回错误信息( 但是读命令还可以正常返回。) 或者你可以将 Redis 当缓存来使用配置淘汰机制, 当 Redis 达到内存上限时会冲刷掉旧的内容。
一个 Redis 实例最多能存放多少的 keys?List、Set、Sorted Set 他们最多能存放多少元素?
理论上 Redis 可以处理多达 2^32 的 keys,并且在实际中进行了测试,每个实例至少存放了 2 亿 5千万的 keys。我们正在测试一些较大的值。任何 list、set、和 sorted set 都可以放 2^32 个元素。
换句话说, Redis 的存储极限是系统中的可用内存值。
MySQL 里有 2000w 数据,redis 中只存 20w 的数据,如何保证 redis 中的数据都是热点数据?
分析:保证Redis 中的 20w 数据都是热点数据 说明是 被频繁访问的数据,并且要保证Redis的内存能够存放20w数据,要计算出Redis内存的大小。
a、保留热点数据:对于保留 Redis 热点数据来说,我们可以使用 Redis 的内存淘汰策略来实现,可以使用allkeys-lru淘汰策略,该淘汰策略是从 Redis 的数据中挑选最近最少使用的数据删除,这样频繁被访问的数据就可以保留下来了。
b、保证 Redis 只存20w的数据:1个中文占2个字节,假如1条数据有100个中文,则1条数据占200字节,20w数据 乘以 200字节 等于 4000 字节(大概等于38M);所以要保证能存20w数据,Redis 需要38M的内存。
Redis 最适合的场景?
- 会话缓存( Session Cache)
- 全页缓存( FPC)
- 队列 (Lpush、Rpop)
- 排行榜/计数器(sorted set,ZRANGE ... )
- 发布订阅(PUB/SUB)
假如 Redis 里面有 1 亿个 key,其中有 10w 个 key 是以某个固定的已知的前缀开头的,如果将它们全部找出来?
使用keys指令可以扫出指定模式的key列表。
对方接着追问:如果这个Redis正在给线上的业务提供服务,那使用keys指令会有什么问题?
Redis关键的一个特性:
Redis是单线程的。keys指令会导致线程阻塞一段时间,线上服务会停顿,直到指令执行完毕,服务才能恢复。
这个时候可以使用scan指令,scan指令可以无阻塞的提取出指定模式的key列表,但是会有一定的重复概率,在客户端做一次去重就可以了,但是整体所花费的时间会比直接用keys指令长。
另外scan不能出现在编码中,不能来一个请求就scan一次,会导致cpu和内存占用的持续上升。
如果有大量的 key 需要设置同一时间过期,一般需要注意什么?
缓存雪崩指的是缓存同一时间大面积的失效,所以,后面的请求都会落到数据库上,造成数据库短时间内承受大量请求而崩掉。
解决办法
- 事前:尽量保证整个 Redis 集群的高可用性,发现机器宕机尽快补上,选择合适的内存淘汰策略。
- 事中:本地ehcache缓存 + hystrix限流&降级,避免MySQL崩掉, 通过加锁或者队列来控制读数据库写缓存的线程数量。比如对某个key只允许一个线程查询数据和写缓存,其他线程等待。
- 事后:利用 Redis 持久化机制保存的数据尽快恢复缓存
使用过 Redis 做异步队列么,你是怎么用的?
简单队列:
rpush,blpop。在没有消息时,可以阻塞住直到消息到来。
1:N的消息队列:
如果要生产一次,消费多次,可以用PUB/SUB主题订阅模式。在消费者下线时,生产的消息将会自动丢失。专业的mq工具才能持久化消息,如kafka,rabbitmq
延时队列:
sorted set,时间戳作为score,消息内容作为key。zadd生产消息,消费者用zrangebyscore获取N秒前的数据轮询处理。
如何实现集群中的 session 共享存储?
- 粘性session:同一用户的多次请求落到同一台服务器上
- 服务器session复制:每次session发生变化就广播给集群中所有服务器
- session共享:redis、memcached
- session持久化:将session存储到数据库
查看 Redis 使用情况及状态信息用什么命令?具体数值含义
info 数值:todo
单线程的Redis为什么这么快?了解Redis的线程模型吗?
选择单线程主要是基于一种客观原因来考虑的。因为Redis是基于内存的操作,CPU不是Redis的瓶颈,Redis的瓶颈最有可能是机器内存的大小或者网络带宽。既然单线程容易实现,而且CPU不会成为瓶颈,那就顺理成章地采用单线程的方案了
redis快速的原因:
- Redis的全部操作都是纯内存的操作;
- Redis采用单线程,有效避免了频繁的上下文切换;
- 采用了非阻塞I/O多路复用机制。
I/O 多路复用程序负责监听多个套接字, 并向文件事件分派器传送那些产生了事件的套接字。
Redis 是单线程的,如何提高多核 CPU 的利用率?
可以在同一个服务器部署多个 Redis 的实例,并把他们当作不同的服务器来使用,在某些时候,无论如何一个服务器是不够的, 所以,如果你想使用多个 CPU,你可以考虑一下分片(shard)
修改配置不重启 Redis 会实时生效吗?
config set *可以修改配置,大部分命令支持实时生效,部分命令不支持
缓存雪崩、缓存穿透、缓存预热、缓存更新、缓存击穿、缓存降级全搞定!
缓存穿透
产生这个问题的原因可能是外部的恶意攻击,例如,对用户信息进行了缓存,但恶意攻击者使用不存在的用户id频繁请求接口,导致查询缓存不命中,然后穿透 DB 查询依然不命中。这时会有大量请求穿透缓存访问到 DB。
解决的办法:
- 对不存在的用户,在缓存中保存一个空对象进行标记,防止相同 ID 再次访问 DB。不过有时这个方法并不能很好解决问题,可能导致缓存中存储大量无用数据。
- 使用 BloomFilter 过滤器,BloomFilter 的特点是存在性检测,如果 BloomFilter 中不存在,那么数据一定不存在;如果 BloomFilter 中存在,实际数据也有可能会不存在。非常适合解决这类的问题。
缓存击穿
就是某个热点数据失效时,大量针对这个数据的请求会来到数据源。
解决办法:
- 可以使用互斥锁更新,保证同一个进程中针对同一个数据不会并发请求到 DB,减小 DB 压力。
- 使用随机退避方式,失效时随机 sleep 一个很短的时间,再次查询,如果失败再执行更新。
- 针对多个热点 key 同时失效的问题,可以在缓存时使用固定时间加上一个小的随机数,避免大量热点 key 同一时刻失效。
缓存雪崩
产生的原因是缓存挂掉,这时所有的请求都会来到 DB。
解决方法:
使用快速失败的熔断策略,减少 DB 瞬间压力; 使用主从模式和集群模式来尽量保证缓存服务的高可用。
如何处理缓存不一致问题
不一致产生的原因一般是主动更新失败,例如更新 DB 后,更新 Redis 因为网络原因请求超时;或者是异步更新失败导致。
解决办法:
如果服务对耗时不是特别敏感可以增加重试;如果服务对耗时敏感可以通过异步补偿任务来处理失败的更新,或者短期的数据不一致不会影响业务,那么只要下次更新时可以成功,能保证最终一致性就可以。
redis基本设计原则:性能、进程线程、并发、原子、落盘、内存、同步、集群
todo
Redis 支持的 Java 客户端都有哪些(Redisson、Jedis)?官方推荐用哪个(Redisson)?Go呢(redigo,go-redis)
todo
Mysql与Mongodb
Mysql高可用方案 link link
如果数据库发生了宕机或者意外中断等故障,能尽快恢复数据库的可用性,尽可能的减少停机时间,保证业务不会因为数据库的故障而中断。 用作备份、只读副本等功能的非主节点的数据应该和主节点的数据实时或者最终保持一致。 当业务发生数据库切换时,切换前后的数据库内容应当一致,不会因为数据缺失或者数据不一致而影响业务。
- 主从或主主半同步复制
使用双节点数据库,搭建单向或者双向的半同步复制。
在5.7以后的版本中,由于lossless replication、logical多线程复制等一些列新特性的引入,使得MySQL原生半同步复制更加可靠。
通常会和proxy、keepalived等第三方软件同时使用,即可以用来监控数据库的健康,又可以执行一系列管理命令。如果主库发生故障,切换到备库后仍然可以继续使用数据库。
…
todo
mysql事务四大特性(ACID)原子性、一致性、隔离性、持久性?
- 原子性:根据定义,原子性是指一个事务是一个不可分割的工作单位,其中的操作要么都做,要么都不做。即要么转账成功,要么转账失败,是不存在中间的状态!
- 一致性:根据定义,一致性是指事务执行前后,数据处于一种合法的状态,这种状态是语义上的而不是语法上的。
- 隔离性:根据定义,隔离性是指多个事务并发执行的时候,事务内部的操作与其他事务是隔离的,并发执行的各个事务之间不能互相干扰。
- 持久性:根据定义,持久性是指事务一旦提交,它对数据库的改变就应该是永久性的。接下来的其他操作或故障不应该对其有任何影响。
事务的并发问题有哪几种?事务隔离级别,每个级别会解决什么问题,引发什么问题?MySQL默认是哪个级别?其他数据库呢?
- 脏读:脏读是指在一个事务处理过程里读取了另一个未提交的事务中的数据,例如,账户A转帐给B500元,B余额增加后但事务还没有提交完成,此时如果另外的请求中获取的是B增加后的余额,这就发生了脏读,因为事务如果失败回滚时,B的余额就不应该增加。
- 不可重复读:不可重复读是指对于数据库中某个数据,一个事务范围内多次查询返回了不同的数据值,这是由于在多次查询之间,有其他事务修改了数据并进行了提交。
- 幻读:是指一个事务中执行两次完全相同的查询时,第二次查询所返回的结果集跟第一个查询不相同。与不可重复读的区别在于,不可重复读是对同一条记录,两次读取的值不同。而幻读是记录的增加或删除,导致两次相同条件获取的结果记录数不同。
事务的四种隔离级别 可以用于解决这几种并发问题。如图右面,由上到下的4种隔离级别由低到高。
- 级别1读未提交:也就是可以读取到其他事务未提交的内容,这是最低的隔离级别,这个隔离级别下,前面提到的三种并发问题都有可能发生。
- 级别2读已提交:就是只能读取到其他事务已经提交的数据。这个隔离级别可以解决脏读问题。(注:除mysql外很多数据库的默认隔离级别)
- 级别3可重复读:可以保证整个事务过程中,对同数据的多次读取结果是相同的。这个级别可以解决脏读和不可重复读的问题。MySQL默认的隔离级别就是可重复读。
- 级别4串行化:这是最高的隔离级别,所有事务操作都依次顺序执行。这个级别会导致并发度下降,性能最差。不过这个级别可以解决前面提到的所有并发问题。
MySQL常见的三种存储引擎(InnoDB、MyISAM、MEMORY)的区别
InnoDB:支持事务处理,支持外键,支持崩溃修复能力和并发控制。如果需要对事务的完整性要求比较高(比如银行),要求实现并发控制(比如售票),那选择InnoDB有很大的优势。如果需要频繁的更新、删除操作的数据库,也可以选择InnoDB,因为支持事务的提交(commit)和回滚(rollback)。
MyISAM:插入数据快,空间和内存使用比较低。如果表主要是用于插入新记录和读出记录,那么选择MyISAM能实现处理高效率。如果应用的完整性、并发性要求比 较低,也可以使用。
MEMORY:所有的数据都在内存中,数据的处理速度快,但是安全性不高。如果需要很快的读写速度,对数据的安全性要求较低,可以选择MEMOEY。它对表的大小有要求,不能建立太大的表。所以,这类数据库只使用在相对较小的数据库表。
查询语句不同元素(where、jion、limit、group by、having等等)执行先后顺序 link
完整顺序为:
from
join
on
where
开始使用select中的别名,后面的语句中都可以使用)
...
group by
having
select
distinct
order by
limit
什么是临时表,临时表什么时候删除?
什么是临时表:MySQL用于存储一些中间结果集的表,临时表只在当前连接可见,当关闭连接时,Mysql会自动删除表并释放所有空间。
为什么会产生临时表:一般是由于复杂的SQL导致临时表被大量创建
下列操作会使用到临时表:
union查询 对于视图的操作,比如使用一些TEMPTABLE算法、union或aggregation 子查询 join 包括not in、exist等 查询产生的派生表 复杂的group by 和 order by Insert select 同一个表,mysql会产生一个临时表缓存select的行 多个表更新 GROUP_CONCAT() 或者 COUNT(DISTINCT) 语句
MySQL B+Tree索引和Hash索引的区别?
由于 hash 索引结构的特殊性,其检索效率非常高,索引的检索可以一次定位,不像B-Tree 索引需要从根节点到枝节点,最后才能访问到页节点这样多次的IO访问,所以 Hash 索引的查询效率要远高于 B-Tree 索引。
虽然 Hash 索引效率高,但是 Hash 索引本身由于其特殊性也带来了很多限制和弊端,主要有以下这些:
- Hash 索引仅仅能满足”=”,”IN”和”<=>”查询,不能使用范围查询。
- 由于 Hash 索引比较的是进行 Hash 运算之后的 Hash 值,所以它只能用于等值的过滤,不能用于基于范围的过滤,因为经过相应的 Hash 算法处理之后的 Hash 值的大小关系,并不能保证和Hash运算前完全一样。
- Hash 索引无法被用来避免数据的排序操作。
- 由于 Hash 索引中存放的是经过 Hash 计算之后的 Hash 值,而且Hash值的大小关系并不一定和 Hash 运算前的键值完全一样,所以数据库无法利用索引的数据来避免任何排序运算;
- Hash 索引不能利用部分索引键查询。
- 对于组合索引,Hash 索引在计算 Hash 值的时候是组合索引键合并后再一起计算 Hash 值,而不是单独计算 Hash 值,所以通过组合索引的前面一个或几个索引键进行查询的时候,Hash 索引也无法被利用。
- Hash 索引在任何时候都不能避免表扫描。
- 由于不同索引键存在相同 Hash 值,所以即使取满足某个 Hash 键值的数据的记录条数,也无法从 Hash 索引中直接完成查询,还是要通过访问表中的实际数据进行相应的比较,并得到相应的结果。
- Hash 索引遇到大量Hash值相等的情况后性能并不一定就会比B-Tree索引高。
数据库如何建索引?sql查询语句确定创建哪种类型的索引?如何优化查询?
normal:表示普通索引
unique:表示唯一的,不允许重复的索引,如果该字段信息保证不会重复例如身份证号用作索引时,可设置为unique
full textl: 表示 全文搜索的索引。 FULLTEXT 用于搜索很长一篇文章的时候,效果最好。用在比较短的文本,如果就一两行字的,普通的 INDEX 也可以。
为了使索引的使用效率更高,在创建索引时,必须考虑在哪些字段上创建索引和创建什么类型的索引,有7大原则:
实际操作过程中,应该选取表中哪些字段作为索引:
1.选择唯一性索引 2.为经常需要排序、分组和联合操作的字段建立索引 3.为常作为查询条件的字段建立索引 4.限制索引的数目 5.尽量使用数据量少的索引 6.尽量使用前缀来索引 7.删除不再使用或者很少使用的索引
聚集索引和非聚集索引区别?
聚集索引一个表只能有一个,而非聚集索引一个表可以存在多个
聚集索引存储记录是物理上连续存在,而非聚集索引是逻辑上的连续,物理存储并不连续。
todo
有哪些锁(乐观锁悲观锁),select 时怎么加排它锁? link
共享锁:
- sql + lock in share mode;
排它锁:
- select * from … for update
- update … set …
todo
使用explain优化sql和索引?
explain + sql语句
explain select * from tsmall;
| id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra |
|---|---|---|---|---|---|---|---|---|---|
| 1 | SIMPLE | product | ALL | NULL | NULL | NULL | NULL | 16 |
字段解释:todo
MySQL慢查询查看,解决?
show variables like “%slow%”;
slow_log_file
todo
什么是 内连接、外连接、交叉连接、笛卡尔积等?
todo
mysql都有什么锁,死锁判定原理和具体场景,死锁怎么解决?
查看数据库的隔离级别: mysql> select @@tx_isolation;
todo
mysql 高并发环境解决方案?
分库 分表 分布式 增加二级缓存 ……
todo
数据库崩溃时事务的恢复机制(REDO日志和UNDO日志)?
数据库存放数据的文件,本文称其为data file。
数据库的内容在内存里是有缓存的,这里命名为db buffer。某次操作,我们取了数据库某表格中的数据,这个数据会在内存中缓存一些时间。对这个数据的修改在开始时候也只是修改在内存中的内容。当db buffer已满或者遇到其他的情况,这些数据会写入data file。
日志在内存里也是有缓存的,这里将其叫做log buffer。磁盘上的日志文件称为log file。log file一般是追加内容,可以认为是顺序写,顺序写的磁盘IO开销要小于随机写。
Undo日志记录某数据被修改前的值,可以用来在事务失败时进行rollback;Redo日志记录某数据块被修改后的值,可以用来恢复未写入data file的已成功事务更新的数据。
todo
MySQL性能调优,维度对比性能与成本?
- 表结构和索引的优化
- SQL语句进行优化
- mysql配置优化
- 硬件和操作系统配置优化和升级
在线更改表结构Online Schema Change
目前InnoDB引擎是通过以下步骤来进行DDL的:
- 按照原始表(original_table)的表结构和DDL语句,新建一个不可见的临时表(tmp_table)
- 在原表上加write lock,阻塞所有更新操作(insert、delete、update等)
- 执行insert into tmp_table select * from original_table
- rename original_table和tmp_table,最后drop original_table
- 释放 write lock。 我们可以看见在InnoDB执行DDL的时候,原表是只能读不能写的。为此 perconal 推出一个工具 pt-online-schema-change ,其特点是修改过程中不会造成读写阻塞。
OSC(Online Schema Change):大多都是利用了触发器的原理,实现了在线更改表结构的同时,避免了锁表,同时还允许其他的dml操作
核心:触发器+临时表
MySQL索引类型与实现
中间件:DBProxy、kingshard
带保存点的事务是怎么回事?和嵌套事务有什么区别
分布式事务解决方案有哪四种?
- **XA协议,强一致性。两段式**。**需要有一个事务协调者来保证所有的事务参与者都完成了第一阶段的准备工作。如果协调者收到所有参与者都准备好的消息,就会通知所有的事务执行第二阶段提交**。
- **TCC,满足最终一致性的柔性事务。采用补偿机制,核心思想是对每个操作,都要注册对应的确认和补偿操作。分为三个阶段:Try阶段主要对业务系统进行检测及资源预留;Confirm阶段对业务系统做确认提交。Cancel阶段是在业务执行错误,执行回滚,释放预留的资源**。
- **消息事务。将本地操作和发送消息放在一个事务中,保证本地操作和消息发送要么都成功要么都失败。下游应用订阅消息,收到消息后执行对应操作**。
- GTS/Fescar:阿里云中的全局事务服务GTS。使用Fescar的前提是分支事务中涉及的资源,必须是支持ACID事务的关系型数据库。分支的提交和回滚机制,都依赖于本地事务来保障。
todo
mysql死锁与处理死锁、避免发生死锁
profile分析query性能
数据库三范式,根据某个场景设计数据表?
其他
- elasticSearch与倒排索引link
- efk(es、fluentd、kibana)日志收集分析查询link
- kafka与golang
- rabbitmqlink
- rabbitmq、kafka对比,及rocketMQ等
- mongodb与文档数据库、索引、读写命令、数据结构、特点比较link
- influxdb与时序数据库tutorial
- rocksdb与分布式文件系统,与leveldb、RDBMS比较,产品,问题分析、部署
- git文件版本,使用顺序,merge跟rebase