cbirdcn.github.io
http://www.zhzq.site
深入理解Redis设计与实现
数据类型和实现方式
主要数据类型:string(字符串),hash(哈希),list(列表),set(集合),zset(sorted set:有序集合)
string
二进制安全的字符串。所以可以保存序列化后的对象、图片等资源,而不用担心类似\0截断的问题。
为了在O(1)的时间内得到字符串的长度,以及高效执行append追加字符串等操作,string被设计成动态sds结构(简单动态字符串)
struct sdshdr{
        int len;//buf数组中已经使用的字节的数量,也就是SDS字符串长度
        int  free;//buf数组中未使用的字节的数量
        char buf[];//字节数组,字符串就保存在这里面
};
读取string长度就是获取len。而C语言原生数组需要遍历完数组才能得到长度。
append就是追加到空闲空间中。如果空余长度大于等于需要追加的字符串长度,那么直接追加即可,这样就减少了重新分配内存操作;否则,先用sdsMakeRoomFor函数对SDS进行扩展,按照一定的机制来决定扩展的内存大小,然后再执行追加操作,扩展后多余的空间不释放,方便下次再次追加字符串,这样做的代价就是浪费了一些内存,但是在Redis字符串追加操作很频繁的情况下,这种机制能很高效的完成追加字符串的操作。
在Redis6.0中,扩容逻辑是:如果新字符串长度小于1024, 即1MB,则扩容双倍,否则在原有基础上增加1024字长内存分配
hash
哈希对象的底层存储可以使用ziplist(压缩列表)和hashtable。
ziplist压缩列表
数据较少时使用ziplist:
- 哈希对象保存的所有键值对的键和值的字符串长度都小于64字节
- 哈希对象保存的键值对数量小于512个
ziplist的数据结构主要包括两层,ziplist和zipEntry。
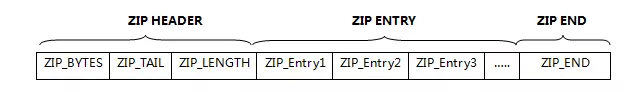
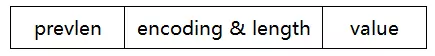
ziplist包括zip header、zip entry、zip end三个模块。
因为key、value可能是各种类型,所以zip entry用于顺序保存每个key、value实体的类型、长度、实际值等数据。
- zip entry由prevlen、encoding&length、value三部分组成。
- prevlen主要是指前面zipEntry的长度,coding&length是指编码字段长度和实际存储value的长度,value是指真正的内容。
- 每个key/value存储结果中key用一个zipEntry存储,value用一个zipEntry存储。
ziplist不需要指针,内存分配是连续的,查询较快。一个键值对的key和value是两个紧挨着保存的zipentry,保存键的节点在前,保存值的节点在后。插入或更新新的键值对时,放在压缩列表尾部。如果键已存在,就找到对应的value entry并替换掉值。
如果在更新时将一个过长的节点设置为表头节点,因为后续每个节点可能要更新previous entry_length,可能导致后续每个节点内存的超长以至于重新分配内存。这就是连锁更新。也就是说,如果压缩列表中恰好有多个连续的、长度介于250 字节至253 宇节之间的节点,更新首个节点时会导致所有节点连锁更新。
用压缩列表ziplist与常见的双向链表linkedList对比:
- 双向链表的前后指针,在存储数据很小时,指针占用的内存空间比数据还大(64位计算机指针占用64位=8字节),不够划算。而压缩列表是依靠偏移量在连续内存上寻址的,数据量有限时,每个实体存储的长度属性占据的内存空间是很小的。
- 双向链表在内存中不是连续的,需要通过前后指针遍历查找,效率很低。而压缩列表存储的实体在内存中连续,通过偏移量和实体存储长度查找,更高效。
- 双向链表对比单向链表的优点是特定情况下查询更快,比如查找最后一个节点。而压缩列表中保存了前一个节点的内存空间大小prevlensize和数据元素prevlen,根据偏移量和数据长度就可以逆向查找了。
ziplist并没有定义明确的结构体,结合上面ziplist和zipEntry的结构图,主要的存储结构可以定义成:
typedef struct ziplist{
     /*ziplist分配的内存大小*/
     uint32_t bytes;
     /*达到尾部的偏移量*/
     uint32_t tail_offset;
     /*存储元素实体个数*/
     uint16_t length;
     /*存储内容实体元素*/
     unsigned char* content[];
     /*尾部标识*/
     unsigned char end;
}ziplist;

/*元素实体所有信息, 仅仅是描述使用, 内存中并非如此存储*/
typedef struct zlentry {
     /*前一个元素长度需要空间和前一个元素长度*/
    unsigned int prevrawlensize, prevrawlen;
     /*元素长度需要空间和元素长度*/
    unsigned int lensize, len;
     /*头部长度即prevrawlensize + lensize*/
    unsigned int headersize;
     /*元素内容编码*/
    unsigned char encoding;
     /*元素实际内容*/
    unsigned char *p;
}zlentry;
在content中包含了很多zlentry,一对连续的zlentry就是hash的key和value。因为每个key和value可以是任何类型且长度不一,所以zlentry会保存数据占据的内容空间、数据长度、编码(用2bit表示不同的数据类型)、数据地址、header(方便逆向查前一实体)。前向遍历通过previous_entry_length即可获取前一个元素的首地址。而后向遍历时,需要解码当前元素,计算当前元素的长度,才能获取后一个元素首地址。所以,在对数据进行增删时,类似数组,除了涉及数据复制、重新分配内存空间,还需要计算数据长度的过程。这就不适合多对象、大对象的存储了。
具体查看:
hashtable
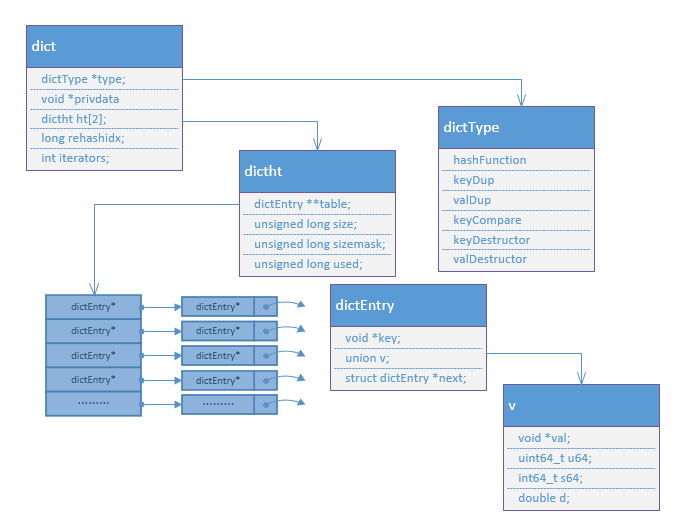
数据量多了以后,用hashtable保存,通过挂链解决冲突。
/*Hash表一个节点包含Key,Value数据对 */
typedef struct dictEntry {
    void *key;
    union {
        void *val;
        uint64_t u64;
        int64_t s64;
        double d;
    } v;
    struct dictEntry *next; /* 指向下一个节点, 链接表的方式解决Hash冲突 */
} dictEntry;

/* 存储不同数据类型对应不同操作的回调函数 */
typedef struct dictType {
    unsigned int (*hashFunction)(const void *key);
    void *(*keyDup)(void *privdata, const void *key);
    void *(*valDup)(void *privdata, const void *obj);
    int (*keyCompare)(void *privdata, const void *key1, const void *key2);
    void (*keyDestructor)(void *privdata, void *key);
    void (*valDestructor)(void *privdata, void *obj);
} dictType;

typedef struct dictht {
    dictEntry **table; /* dictEntry*数组,Hash表 */
    unsigned long size; /* Hash表总大小 */
    unsigned long sizemask; /* 计算在table中索引的掩码, 值是size-1 */
    unsigned long used; /* Hash表已使用的大小 */
} dictht;

typedef struct dict {
    dictType *type;
    void *privdata;
    dictht ht[2]; /* 两个hash表,rehash时使用*/
    long rehashidx; /* rehash的索引, -1表示没有进行rehash */
    int iterators; /*  */
} dict;
关键属性说明:
- dict.dictType 指定了该 dict 的实现方式,不同数据类型的实现方式不同。
- dict.dictht 是一个包含 2 个 dictht 的数组,用于rehash
- dict.rehashidx 表明了该 dict 进行 rehashing 的进度,-1:表示此时并没有在 rehashing。
-
dict.iterators 表明现在正在操作该 dict 的迭代器数量。
- dictType.hashFunction 计算 key 在 [0, dict.dictht.sizemask] 范围内的 hash 值,这个值是 value 存放到 - dict.dictht.table 数组中的下标。
- dictType.keyDup
- dictType.valDup 如何将 value 放入 dictEntry 。可以对 value 的进行处理,默认 null 则表示不需要处理
- dictType.keyCompare 如何比较 key1 和 key2 是否相等,默认 null 表示 key1==key2 时相等
- dictType.keyDestructor 当释放 key 时的回调
-
dictType.valDestructor 当需要释放 value 时的回调
- dictht.table 是一个 dictEntry 数组的起始指针,用来存在 value。
- dictht.size 记录了目前 dictht.table 的容量(即:数组长度)。
- dictht.sizemask dictht.table 容量的掩码。
-
dictht.used 记录了 dict 中目前存放的 value 数量。
- dictEntry.key 存放 key
- dictEntry.v 存放 value
- dictEntry.next 是下一个 dictEntry 的指针。相同 dict.dictht.table 下标的 dictEntry 会 以单向链表的方式存储,因此,dictEntry.next 是这个单向链表的头指针
hash扩容和渐进式rehash
dict中ht[2]中有两个hash表, 我们第一次存储数据的数据时, ht[0]会创建一个最小为4的hash表, 一旦ht[0]中的size和used相等, 则dict中会在ht[1]创建一个size*2大小的hash表, 这就是扩容。
扩容和收缩都会执行渐进式rehash。拿扩容举例,扩容后不会直接将ht[0]中的数据copy进ht[1]中, 而是在以后的操作(find, set, get等)中, 每次操作会分别从 ht[0] 和 ht[1] 中查找数据(0查不到就找1),每次都会将一个链表(注意不是一个元素)从 ht[0] 迁移到 ht[1]。而rehash过程中新添加的元素会直接添加进ht[1]。这就意味着,最极端情况下,进行了size次直接插入到 ht[1] 的操作,顺便把最多size个 ht[0] 的链(注意不是元素)迁移到了 ht[1], 正好填满了 ht[1]。这一措施保证了ht[0]包含的键值对数量会只减不增,并随着rehash操作的执行而最终变成空表,此时释放 ht[0],将 ht[1] 设置为 ht[0],并在 ht[1] 新创建一个空白哈希表, 为下一次 rehash 做准备。因此在ht[1]被占满的时候定能确保ht[0]中所有的数据全部copy到ht[1]中,并在下一次rehash前保证ht[1]不会面临空间不足的问题。
删除和查找:在进行渐进式rehash的过程中,字典会同时使用ht[0]和ht[1]两个哈希表,所以在渐进式rehash进行期间,字典的删除、查找、更新等操作会在两个哈希表上进行。比如说,要在字典里面查找一个键的话,程序会先在ht[0]里面进行查找,如果没找到的话,就会继续到ht[1]里面进行查找,诸如此类。
另外,Redis 服务通过函数 databasesCron 维护一个后台定时任务,该函数的运行频率通过配置文件中的配置项 hz 来设置,该值设置了函数 databasesCron 每秒钟运行的次数,默认为 10。这个后台定时任务主要负责清理过期的 key 、hashtable 的缩容以及在 Redis 服务空闲时进行 rehash 。当 Redis 服务处于空闲状态时,Redis 会使用 1ms 的时间对 dict 进行 rehash 操作。这期间,每次 rehash 时 n 的值设为 100,在每次操作完成之后会检查当前时间距离开始时间是否超过 1 ms,如果是,那么停止 rehash ,否则继续。
具体查看:
Redis 底层数据结构 dict(hashtable)的实现机制
兼容两种存储类型的hash存储过程
比如,在一次hset过程中
- 首先查看hset中key对应的value是否存在,hashTypeLookupWriteOrCreate。
- 判断key和value的长度确定是否需要从zipList到hashtable 转换,hashTypeTryConversion。
- 对key/value进行string层面的编码,解决内存效率问题。
- 更新hash节点中key/value问题。
- 其他后续操作的问题
list
字符串列表。由双向链表实现。插入删除速度快,但是查找需要遍历速度较慢。
当list中最后一个元素弹出后,数据结构被删除,内存将被回收.
当数据数量较少,且每个元素占据内存空间较小时,可以类似前面的哈希用压缩列表存储。而 struct list 作为双向链表,需要另外提供一些诸如元素数量、头尾指针、节点值的比较、释放节点等函数.
如果把list当做异步队列使用,将需要延后处理的任务结构体序列化成字符串塞进 Redis 的列表,另一个线程从这个列表中轮询数据进行处理.
快速链表
由于链表的遍历查找比较耗时,而压缩列表是连续分配内存比较快,所以结合后,让每个节点存储一个压缩列表指针,而压缩列表结构存储1-n个元素,就是快速链表。
然而每个压缩列表的长度(元素数量)设置和连锁更新,是可能存在的问题。尤其是当压缩列表中仅有一个元素时,连锁更新问题就可能很严重。这种存储方式仍然仅限于小数据量短数据的存储,比如每个ziplist小于8kb
listpack
Redis7.0代码分析:底层数据结构listpack实现原理
与messagepack类似。
listpack也是用一块连续的内存空间保存数据,但是不同的数据类型有不同的编码和长度,可以存储字符串、整形。
每个元素不再像ziplist一样,保存前一个元素的长度。每个元素只存储编码类型、实际数据、长度三个属性。这样就不会涉及连锁更新。
那怎么区分每个元素的起始和终止位置呢?以大字符串为例,固定位长(1字节)存储了11种数据编码类型,固定位长(4字节)存储了字符串长度,接下来是字符串数据,最后也就是有别于messagepack的一点,为了支持前向遍历需要提供一个定长的backlen表示当前总占用字节长度。
这样就能快速的在连续内存空间存储大量不同类型的数据。当一个元素需要修改时,编码类型和长度占据的内存空间不会变,字符串占据内存会变化,后续所有元素都需要像数组一样进行复制,但是至少不需要像ziplist一样更改后续每个元素的prevlen属性值。另外listpack是替代ziplist作为快速链表的一个节点存在的,所以一个节点上的元素数量不会太多,即使出现内存复制也没太大影响。
set
集合成员是唯一的,无序的。
集合同样考虑了数据量较少和较多两种情况。
所有元素均为整数且元素个数不超过设定阈值时,为int类型的有序集合(intset)。否则要用hashtable。
intset整形集合
intset也是存在一块连续的内存空间上,当类型都为整形时,就意味着每个元素的长度一开始就固定了。所以除了提供编码类型(不同编码对应的元素长度不同,每次添加数据还可能改变类型)、总长度以外,后面跟着连续的整形就可以了。和数组比较相似。
当插入数据时,需要判断数据是否已经存在,这就要求intset应该是有序的,然后用二分查找快速判断元素是否存在。如果不存在就插入到应该插入的位置上。
set的hash实现
set使用hashtable实现时,不需要存储值,也就是存null就好节省内存,只需要用key判断是否存在就可以了。
集合的并交差运算
并集。遍历所有集合,将每个元素都加入到结果集合中。因为集合具备唯一性,所以能正常插入的就构成了交集。
交集。将所有集合按照元素数量从小到大排序,对最小集合遍历每个元素,去后续集合中查找是否存在。存在则加入到结果集合中。
差集。由于遍历元素数量较少的集合耗时较少,所以有两个算法:
- 遍历集合A的元素,到后续集合中查找不存在的元素,加入到结果集合中
- 将集合A的元素都加入到结果集合中,遍历后续集合的元素,如果在结果集合中能查到就删除掉。最后结果集留下的就是差集。
zset
redis使用哈希表dict和跳表skiplist实现有序集合。有别于mysql的哈希和搜索树算法。
跳表skiplist
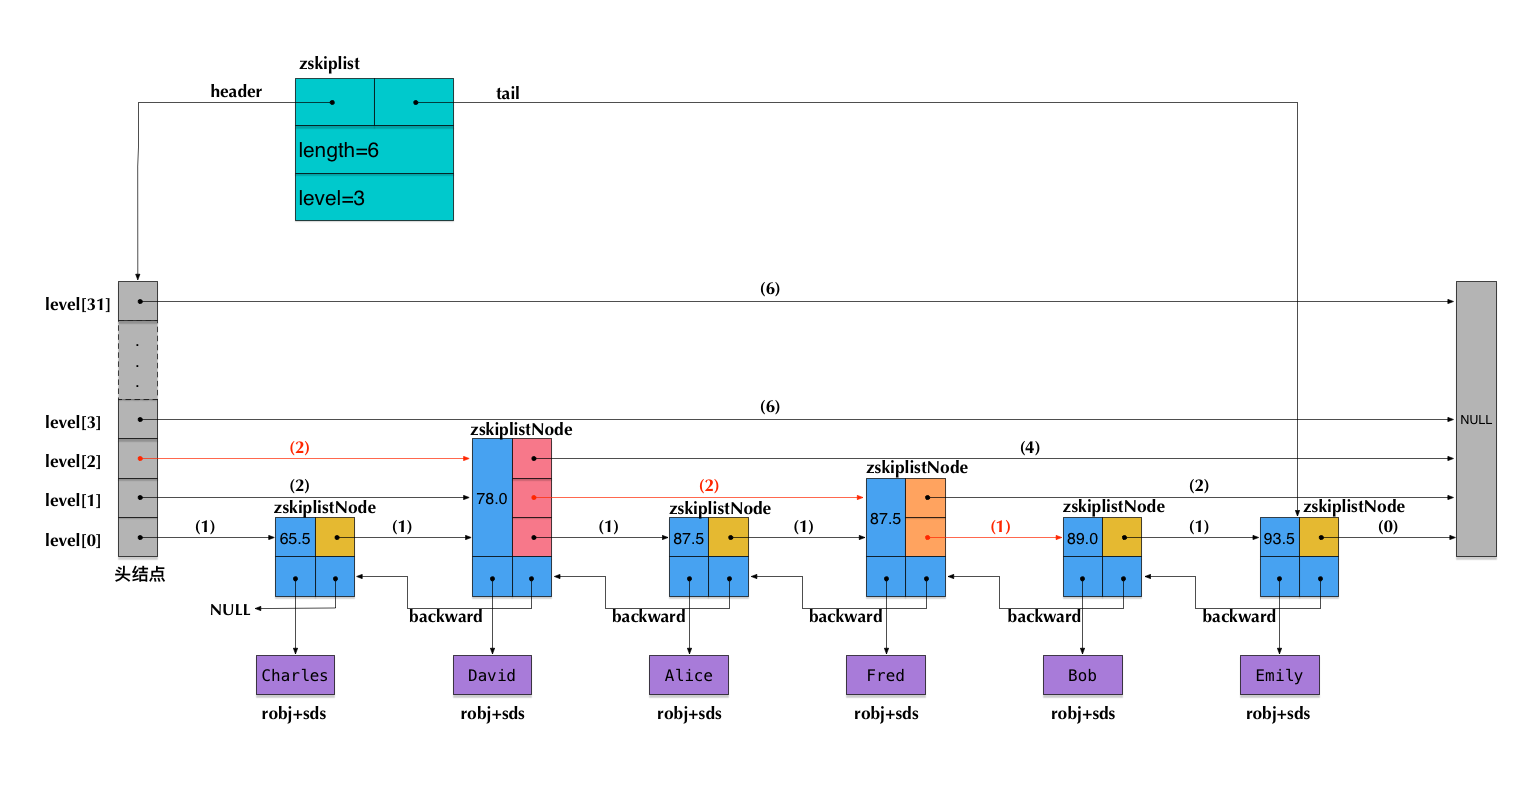
skiplist本质上也是一种查找结构,用于解决算法中的查找问题(Searching),即根据给定的key,快速查到它所在的位置(或者对应的value)。对应到实际问题中就是,通过分数查学生姓名。
有序链表:skiplist是从有序链表发展来的。无论是插入还是查找,都要从头开始逐个进行比较,直到找到包含数据的那个节点,或者找到第一个比给定数据大的节点为止(没找到)。也就是说,时间复杂度为O(n)。
多层链表:为了在查找过程中减少遍历的有序节点数,可以将单层链表转成多层链表。也就是说每隔一个节点地,在一半的节点上添加一个指针,也就是说一半的节点都拥有了双层指针。然后将这些间隔了一个节点的指针连起来,就构成了仅有一半节点的第二层链表(指针数1-2-1-2-1-2-1)。由于链表本身是有序的,所以遍历过程就可以从第二层链表开始遍历,粗略地定位到目标节点附近的小范围,然后到第一层节点中去查找目标值。这样,加起来就是第二层只遍历了一半,第一层只遍历了1-3个。依次类推,第三层链表是每隔一个2层指针的节点,在第二层链表的某个2层指针上加一个指针构成的。也就是说,每一层的节点数是原层级节点数的一半。这样查找过程就变成了二分查找,O(log n)。
但是插入和删除节点时会破坏原有的1:2的关系,需要花时间实现新的节点平衡。
为了避免这个问题,skiplist不要求上下层严格的数量关系,而是为每个节点随机出一个层数(level)。比如,一个节点随机出的层数是3,那么就把它链入到第1层到第3层这三层链表中。这样插入操作不影响其他层的数量,只会修改相关层的前后节点的指针,这种不需要再平衡的插入会比平衡搜索树的插入性能更高。另外有别于平衡搜索树需要遍历到叶子节点才能拿到value,skiplist的节点是同时保存key(索引)和value的,如果索引匹配了直接就能拿到value。
注意,redis的skiplist基于一些默认设定。节点最大的层数不允许超过一个最大值,记为MaxLevel = 32。每 N+1 层出现的概率是 p = 1/4。平均时间复杂度O(log n),和平衡树相当。
在范围查找时,平衡树需要分别从树的根节点查找与边界值接近的数据,而skiplist可以找到左边界后遍历level 1的节点就可以了。
平衡树的增删可能会引起平衡树的再平衡,而skiplist只需要修改前后节点的指针即可,随机level的插入过程不需要平衡。
可是skiplist只能提供通过分数查姓名的过程,那通过姓名查分数呢?可以用哈希表dict结构辅助,时间复杂度O(1)。
比如ZREVRANK用于获取有序集中指定成员的排名(降序)。就需要先从哈希表中查到姓名对应的分数,再到跳表中通过分数倒序查到对应的排名。这就是姓名、分数、排名互查的基本应用。
> zadd ztest 100 peter
> zadd ztest 90 tom
> zrevrank salary peter
0
> zrevrank salary tom
1
> zrevrange ztest 0 -1 WITHSCORES
1) "peter"
2) "100"
3) "tom"
4) "90"
redis的特殊设计
实际上,redis的zset相比于skiplist,还有些特殊设计。比如
- 分数(score)允许重复,即skiplist的key允许重复。这在最开始介绍的经典skiplist中是不允许的。
- 在比较时,不仅比较分数(相当于skiplist的key),还比较数据本身。在Redis的skiplist实现中,数据本身的内容唯一标识这份数据,而不是由key来唯一标识。另外,当多个元素分数相同的时候,还需要根据数据内容来进字典排序,所以每个节点存储的数据(人名)是sds字符串类型。
- 第1层链表不是一个单向链表,而是一个双向链表。这是为了方便以倒序方式获取一个范围内的元素。
- 在skiplist中通过span值可以很方便地计算出每个元素的排名(rank)。span值就是指针跨过节点的数量(不含起点,含终点),升序就是指针跨节点数相加,降序就是skiplist总长-相加的节点数。
数据持久化存储
Redis 是基于内存的数据库,一旦进程退出,数据就会丢失,所以我们需要它也可以把数据写到磁盘上,当 Redis 重启后,可以从磁盘中恢复数据。这一点类似于MySQL的redolog。
两种解决方案将内存中的数据保存到磁盘上。一种是 RDB 持久化,原理是将 Reids 在内存中的全部数据库记录定时 dump 到磁盘上的 RDB 持久化;另外一种是 AOF 持久化,原理是将 Reids 的操作日志以追加的方式写入文件。这就相当于MySQL的全量备份和binlog。
RDB
MySQL的全量备份因为涉及太多磁盘I/O操作所以不能太频繁,但Redis的数据在内存中,这就可以在性能允许的情况下支持稍频繁的全量备份。Redis也支持进行设置,让它在N秒内数据集至少有M个改动这一条件被满足时,自动保存一次数据集。
实现上,每次save的过程可以是通过命令执行,也可以通过bgsave根据配置自动执行。为了不影响当前服务的数据访问,save过程需要执行fork 操作创建子进程进行。所以如果 Redis 意外挂掉,就会丢失最后一次快照后的所有修改。备份的RDB文件是二进制文件。
AOF
MySQL的binlog有多种形式保存写操作历史,比如记录SQL,但是涉及到时间函数等特殊情况需要转成确定时间戳。另外还需要记录undolog用于事务回滚,undolog是逻辑意义的对binlog中SQL的反向写操作。
开启AOF功能:
appendonly yes
和binlog一样,你可以配置 Redis 多久才将数据fsync到磁盘一次。如果突然断电导致数据没来得及写入磁盘,将会丢失最后一次或一批写操作的历史。
- 每次有新命令追加到 AOF 文件时就执行一次fsync:非常慢,也非常安全。
- 每秒fsync一次:足够快(和使用 RDB 持久化差不多),并且在故障时只会丢失 1 秒钟的数据。
- 从不fsync:将数据交给操作系统来处理。更快,也更不安全的选择。
但是由于AOF文件较大,恢复数据较慢,所以有时又需要全量备份的RDB文件。所以Redis也支持混合模式,先使用 bgsave 以 RDB 形式将内存中的全部数据写入磁盘,之后当有新的数据时,再使用 AOF 的形式追加到文件中。
aof-use-rdb-preamble yes
应用
大量key中找指定前缀的一些key
1 亿个 key,其中有 10 万个 key 是已知的某个固定前缀,如何将找出这些 key。
数据量小时,可以用 keys pattern 匹配。但是keys命令是遍历所有key,当key很多时,会导致CPU和内存资源的急剧上升甚至导致阻塞Redis服务,不建议线上使用。
可以用指定范围的 SCAN 指令获取部分key,然后迭代这个命令直到遍历完成。可以理解为渐进式keys命令。
SCAN cursor [MATCH pattern] [COUNT count]
SCAN 0 match key* 5
1) 12
2) 1) "key9"
   1) "key7"
   2) "key4"
SCAN 12 match key* 5
...
注意事项:
- Scan 完成迭代过程,需要和 Redis 进行多次交互。每一次迭代过程都会把新的游标和数据返回给客户端,客户端再请求下一次迭代。
- 返回的结果可能会有重复,需要客户端去重复,这点非常重要;
- 遍历的过程中如果有数据修改,改动后的数据能不能遍历到是不确定的;
- count参数只是给Redis的建议,实际上Redis的遍历数据可能不是count个,所以不能用count判断是否遍历完成。count推荐一万,多了会影响性能,少了会因网络延迟影响接收速度。
- 单次返回的结果是空的并不意味着遍历结束,而要看返回的游标值是否为零。cursor一开始为0,每迭代一次 SCAN 命令,Redis将返回下一个cursor的位置(乱序)和已遍历的数据,然后进行下一次遍历。直到某轮迭代返回cursor回到0时,才表示遍历完了所有key。
实际上,Redis为了在O(1)时间内快速查找键值对,使用了hash存储键,有冲突时用挂链解决。所以游标cursor就相当于一维数组的索引,每一次迭代过程实际上就是迭代哈希表的链头节点,但是由于每个链头节点后面可能有挂链,如果遍历到链头节点了也要把后面挂链的节点遍历到,遍历count个链头节点实际上可能得到更多节点。如果一次迭代数量不足count,就可能得到更少节点。迭代过程中,可能发生扩容rehash(ht[0] -> ht[1]),这不会导致重复或漏掉数据。但是遇到缩容rehash时,为了保证数据不丢失,Redis有冗余数据存在,也就是槽合并导致遍历过的数据被合并入了没遍历过的槽,这时就可能得到重复数据。需要客户端去重。
布隆过滤器在大量数据中筛选是否存在
比如原本有10亿个号码,现在又来了10万个号码,要快速准确判断这10万个号码是否在10亿个号码库中?如果放在Redis内存中,10亿*8字节=8GB,比较耗费内存空间。而且查询时要遍历无序数据或二分查询有序数据也很耗费时间。
再比如爬虫,在大量url中判断某个url是否已经爬过了。或者邮箱判断是否垃圾邮件。或者判断某用户是否访问过。或者屏蔽词检查等需求。
布隆过滤器
布隆过滤器是一种数据结构,由一串很长的二进制向量组成,可以将其看成一个二进制数组。既然是二进制,那么里面存放的不是0,就是1,但是初始默认值都是0。可以避免消耗太多存储空间。
向布隆过滤器插入key时,我们通过多个hash函数,分别算出一个值(索引位置),然后将这个索引位置所在的值置为1。
但是会出现一种情况,多个key经hash函数计算出的结果是一样的。也就是说在二进制向量中某个位置已经被别的数据写入了1,那么新的key即使未经过布隆过滤器处理,但是因为计算出的hash值位置上的数据已经是1,就被判断为已存在于布隆过滤器中了。
这样再判断key是否存在与布隆过滤器中时,就是不准确的。也就是说,布隆过滤器可以判断某个数据一定不存在,但是无法判断一定存在。
所以,布隆过滤器的优点是,二进制组成的数组,占用内存极少,并且插入和查询速度都足够快。缺点就是,随着数据的增加,误判率会增加;还有无法判断数据一定存在;另外还有一个重要缺点,一般无法删除数据,因为删掉元素会导致误判率增加,也就是说删除时也涉及哈希值重复问题,盲目删除元素可能影响其他元素的判断。如果一定要删除一批元素,可以考虑重新初始化一个布隆过滤器,替换原来的。
缓存穿透是指,当用户访问的数据,既不在缓存中,也不在数据库中,导致请求在访问缓存时,发现缓存缺失,再去访问数据库时,发现数据库中也没有要访问的数据,没办法构建缓存数据,来服务后续的请求。那么当有大量这样的请求到来时,数据库的压力骤增。
布隆过滤器天然就能应对缓存穿透的场景。
首先,布隆过滤器的应用策略正好和缓存是相反的:
- 缓存策略:缓存中不存在的,再去查db。
- 布隆过滤器策略:过滤器中存在的,再去查缓存(db)。 然后,由于它的特性:
- 一个元素如果判断结果为存在的时候元素不一定存在,但是判断结果为不存在的时候则一定不存在。 这表明它的误判率并不影响它的策略:
- 当判断结果为存在时:不一定存在。带来的不好的结果,顶多就是多查一次缓存。
- 当判断结果为不存在时:一定不存在。策略中判断不存在时,当前请求就会被拦截,这方面是没有误判的。 所以说,布隆过滤器天然适合缓存穿透的场景,它的误判率对与该场景没有丝毫影响。
redis用bitmap(位图)实现bloomFilter
BitMap 就是基于SDS(Simple Dynamic String,简单动态字符串)实现的
SDS使用char数组将字符串保存为二进制的字节数组buf[]。BitMap 简称位图,是由多个二进制位组成的数组,数组中的每个二进制位都有与之对应的偏移量,可以通过这些偏移量对位图中指定的一个或多个二进制位进行操作。这样bitmap中每个value最低可以只占用1个位,而不是SDS中的1个字节(1byte=8bit)。
Redis提供了SETBIT、GETBIT、BITCOUNT、BITOP四个常用命令用于处理二进制位数组。
- SETBIT:为位数组指定偏移量上的二进制位设置值,偏移量从0开始计数,二进制位的值只能为0或1。返回原位置值。
- GETBIT:获取指定偏移量上二进制位的值。
- BITCOUNT:统计位数组中值为1的二进制位数量。
- BITOP:对多个位数组进行按位与、或、异或运算。 最常用的两个命令 setbit、getbit 执行的复杂度都是 O(1),算是拿空间换时间的做法。
Redis 中采用的是查表和 variable-precision SWAR 算法,查表是指当位数组长度小于 128 时,直接根据预设的映射表找到对应 1 的个数,直接返回。
实现分布式锁
分布式锁也就是要避免并发获取到锁,只允许一个抢锁成功,要能正常释放锁,还要在释放锁后允许继续并发获取锁。
由于Redis一个命令的执行是原子的,但是事务不是原子的,并且是不可回滚的。所以 setnx + expire 命令无法正确地获取分布式锁。
使用Lua脚本(包含SETNX + EXPIRE两条指令)
由于Lua脚本是原子的,所以可以将 setnx + expire 写入Lua脚本中作为原子命令。
但是如果expire执行失败将无法释放锁,不推荐。
Redis提供的原子命令
为此,Redis提供了单一命令生成锁。
SET key value [EX seconds] [PX milliseconds] [NX|XX]
其中 NX 是 key 不存在时设置成功,保证只有第一个客户端请求才能获得锁,而其他客户端请求只能等其释放锁,才能获取。XX 是 key 存在时设置成功。
也就是,当某key不存在时,为此key设置值为value有效期为PX毫秒,过期后才能重新设置。
注意,不要让大量的 key 在同一时间过期,因为删除大量的 key 很耗时,会出现卡顿现象。所以我们可以在设置 key 的过期时间时,加上一个随机值来避免。
存在问题。
- 锁过期,但是没执行完代码。第二个线程也获取到了锁,也开始执行代码。这样就产生了并发,临界区代码和数据可能受到影响。
- 类似锁过期,如果被其他线程误删除锁。
为了避免误删除锁,可以借鉴乐观锁,在抢到锁时给锁一个随机数值,执行完代码后,释放锁时查询锁的值还是不是自己生成的那个数值,是才删除锁。这个过程涉及到查询和删除两步操作,需要在Lua脚本中执行。
但是仍然无法解决锁过期自动释放问题,锁的时间也是不好确定的。
Redisson框架
为了解决锁过期释放问题,Redisson给获得锁的线程,开启一个定时守护线程,每隔一段时间检查锁是否还存在,存在则对锁的过期时间延长,防止锁过期提前释放。也就是续租。
只要某线程加锁成功,就会启动一个watch dog看门狗,它是一个后台线程,会每隔10秒检查一下,如果线程1还持有锁,那么就会不断的延长锁key的生存时间。
另外,如果redis锁没有规定自动释放时间,业务机线程又在执行过程中挂了,导致锁没有被正确释放,看门狗同样可以根据延迟配置比如30秒决定自动释放锁。或者超过指定时间还没拿到锁就放弃抢锁并报错。
多机实现的分布式锁Redlock+Redisson
前面都只是基于单机版的讨论,还不是很完美。其实Redis一般都是集群部署的。由于集群的主从同步需要时间,如果线程A在master拿到了锁,但是加锁的key还未同步到slave,此时master故障并将slave提升为master,此时线程B也可以从新master获取到锁。Redlock用来解决这个问题。
搞多个Redis master部署,以保证它们不会同时宕掉。并且这些master节点是完全相互独立的,相互之间不存在数据同步。同时,需要确保在这多个master实例上,是与在Redis单实例,使用相同方法来获取和释放锁。
步骤
- 准备N(比如5)个master节点,彼此不互通,也不会同时宕掉。
- 记录当前时间,以毫秒为单位。
- 按顺序或并发向5个master节点请求加锁。客户端设置网络连接和响应超时时间,并且超时时间要小于锁的失效时间。(假设锁自动失效时间为10秒,则超时时间一般在5-50毫秒之间,我们就假设超时时间是50ms吧)。如果超时,跳过该master节点,尽快去尝试下一个master节点。
- 客户端使用当前时间减去开始获取锁时间(即步骤1记录的时间),得到获取锁使用的时间。当且仅当超过一半(N/2+1,这里是5/2+1=3个节点)的Redis master节点都获得锁,并且总上锁耗时小于锁失效时间时,锁才算获取成功。
- 如果取到了锁,key的真正有效时间就变啦,需要减去获取锁所使用的时间。
- 如果获取锁失败(没有在至少N/2+1个master实例取到锁,或者获取锁时间已经超过了有效时间),客户端要在所有的master节点上解锁(即便有些master节点根本就没有加锁成功,也需要解锁,以防止有些漏网之鱼)。
简言之,顺序或并发请求多台分布式master,过半抢锁成功时才获取到锁。
失败重试等待:如果多个客户端同时获取锁都获取到部分,没有过半,则生成一个随机等待的时间,之后再次执行获取锁,还有获取锁失败的客户端要尽快的释放锁,让其它的尽快获取到,多个客户端获取锁,要并发的请求,获取的速度足够快失败的次数就少一点。
释放锁:向所有节点发送释放指令,不用关心之前是否获得过锁,使用lua脚本
还有一个问题,如果redis挂了,然后重启(主从中可能会自动重启),这时候可能clientA获取到了锁,clientB也获取到了,这时候我们使用redis的延迟重启(超过这个TTL),保证A锁过期之后再重启成功,可以避免这个问题,但是会有性能上的问题。如果不重启,也就是N个master节点中有少数无法正常连接的节点,对整个分布式master也没有太大影响。
实现消息队列
使用list结构作为队列,一边进(生产)另一边出(消费),可以满足单一的消息队列。
而pub/sub(订阅)模式可以满足多用户消息。发布者pub消息到指定渠道(channel),订阅者指定要接收的渠道(任意数量)
问题是消息的发布是无状态,不保存数据的,并且数据量有限,不能支持过大数据量。
应该用专业的消息队列工具。
高可用架构
通过设计减少系统不能提供服务的时间。
redis 高可用的三种模式:主从模式,哨兵模式,集群模式。
一般的主从
一般主节点可以进行读、写操作,而从节点只能进行读操作。同时由于主节点可以写,数据会发生变化,当主节点的数据发生变化时,会将变化的数据同步给从节点,这样从节点的数据就可以和主节点的数据保持一致了。一个主节点可以有多个从节点,但是一个从节点会只会有一个主节点,也就是所谓的一主多从结构。和MySQL的主从原理比较类似。
从节点需要从配置或命令参数中通过slaveof指定,当前节点是从属于哪个主节点的,以及主节点的账号密码。
如果master挂了,Redis会在从节点中选一个提升为主节点,并将所有从节点的主指向这个新的主节点,即使挂掉的master再起来也只能作为新主节点的从属节点。注意这里就可能出现上面提到的并发获取到两个锁的问题。
复制过程和MySQL的binlog复制基本一致,也就是主向从同步快照数据时,将新的写操作写入缓冲区,等从载入快照完成后,再向从同步写操作缓冲。循环往复此过程。也就是说master是非阻塞的,同步期间仍然支持服务。而Slave是以阻塞的方式完成数据同步的。也就是在同步期间,如果有客户端提交查询请求,Redis 则返回同步之前的数据,直到同步结束才能用新数据。
主从刚刚连接的时候,进行全量同步;全同步结束后,进行增量同步。当然,如果有需要,slave 在任何时候都可以发起全量同步。Redis 的策略是,无论如何,首先会尝试进行增量同步,如不成功,要求从机进行全量同步。
MySQL的binlog主从存在的问题,Redis同样存在。比如宕机和恢复需要等机器重启或手动切ip,主机宕机导致数据丢失或不同步,多个slave重启请求数据同步可能拖垮master,不好在线扩容
哨兵sentinel模式下的主从
为了避免master宕机时需要手动切换master,实际生产中,可以用哨兵模式自动选举master节点。
在主从模式下,redis 同时提供了哨兵命令redis-sentinel,哨兵是一个独立的进程。原理是哨兵进程向所有的 redis 机器发送命令,等待 Redis 服务器响应,从而监控运行的多个 Redis 实例。
哨兵可以有多个,一般为了便于决策选举,使用奇数个哨兵。哨兵可以和 redis 机器部署在一起(redis宕机将导致哨兵不可用),也可以部署在其他的机器上。每个哨兵可以连接到所有节点,多个哨兵构成一个哨兵集群,哨兵之间也会相互通信检查哨兵是否正常运行,同时发现 master 宕机哨兵之间会进行决策选举新的 master
工作模式:
- 每个 Sentinel(哨兵)进程以每秒钟一次的频率向整个集群中的 Master 主服务器,Slave 从服务器以及其他 Sentinel(哨兵)进程发送一个 PING 命令。
- 如果一个实例(instance)距离最后一次有效回复 PING 命令的时间超过 down-after-milliseconds 选项所指定的值, 则这个实例会被 Sentinel(哨兵)进程标记为主观下线(SDOWN)
- 如果一个 Master 主服务器被标记为主观下线(SDOWN),则正在监视这个 Master 主服务器的所有 Sentinel(哨兵)进程要以每秒一次的频率确认 Master 主服务器的确进入了主观下线状态
- 当有足够数量的 Sentinel(哨兵)进程(大于等于配置文件指定的值)在指定的时间范围内确认 Master 主服务器进入了主观下线状态(SDOWN), 则 Master 主服务器会被标记为客观下线(ODOWN)
- 在一般情况下, 每个 Sentinel(哨兵)进程会以每 10 秒一次的频率向集群中的所有 Master 主服务器、Slave 从服务器发送 INFO 命令。
- 当 Master 主服务器被 Sentinel(哨兵)进程标记为客观下线(ODOWN)时,Sentinel(哨兵)进程向下线的 Master 主服务器的所有 Slave 从服务器发送 INFO 命令的频率会从 10 秒一次改为每秒一次。
- 若没有足够数量的 Sentinel(哨兵)进程同意 Master 主服务器下线, Master 主服务器的客观下线状态就会被移除。若 Master 主服务器重新向 Sentinel(哨兵)进程发送 PING 命令返回有效回复,Master 主服务器的主观下线状态就会被移除。
总结一下,假设 master 宕机,sentinel 1 先检测到这个结果,系统并不会马上进行 failover(故障转移)选出新的 master,仅仅是 sentinel 1 主观的认为 master 不可用,这个现象成为主观下线。当后面的哨兵也检测到主服务器不可用,并且数量达到一定值时,那么哨兵之间就会进行一次投票,投票的结果由 sentinel 1 发起,进行 failover 操作。切换成功后,就会通过发布订阅模式,让各个哨兵把自己监控的从服务器实现切换主机,这个过程称为客观下线。这样对于客户端而言,一切都是透明的。
虽然可以避免数据问题,但是仍然因为占据了大量服务器和内存,可以通过集群模式优化。
集群Cluster
Cluster 集群模式,实现了 Redis 的分布式存储,对数据进行分片,也就是说每台 Redis 节点上存储不同的内容
redis 节点两两之间并不是独立的,每个节点都会通过集群总线(cluster bus),与其他的节点进行通信。通讯时使用特殊的端口号,即对外服务端口号加 10000。例如如果某个 node 的端口号是 6379,那么它与其它 nodes 通信的端口号是 16379。nodes 之间的通信采用特殊的二进制协议。各节点通过集群总线检测故障节点,更新配置等,而客户端是不能使用该端口的。
对客户端来说,整个 cluster 被看做是一个整体,客户端可以连接任意一个 node 进行操作,就像操作单一 Redis 实例一样,当客户端操作的 key 没有分配到该 node 上时,Redis 会返回转向指令,指向正确的 node,这有点儿像浏览器页面的 302 redirect 跳转。
登录集群时需要 -c 参数指定连接到集群:redis-cli -c -h 192.168.1.11 -p 6379 -a 123456
通过CLUSTER NODES和CLUSTER INFO查看集群信息
运行机制
在每一个节点上都有插槽(slot),它的的取值范围是:0-16383,这些slot分布在 N 个master上。以及cluster,可以理解为是一个集群管理的插件,类似哨兵。
存取Key时,Redis 会根据 crc16 的算法对key计算后得出一个结果,然后把结果和 16384 求余数,这样每个 key 都会对应一个编号在 0-16383 之间的哈希槽,通过这个值,去找到对应的插槽所对应的节点,然后直接自动跳转到这个对应的节点上进行存取操作。
为了保证高可用,redis-cluster 集群引入了主从模式,一个主节点对应一个或者多个从节点。当数据写入到对应的 master 节点后,这个数据会同步给这个 master 对应的所有 slave 节点。当其它主节点 ping 主节点 master 1 时,如果半数以上的主节点与 master 1 通信超时,那么认为 master 1 宕机了,就会启用 master 1 的从节点 slave 1,将 slave 1 变成主节点继续提供服务。
如果 master 1 和它的从节点 slave 1 都宕机了,整个集群就会进入 fail 状态,因为集群的 slot 映射不完整。如果集群超过半数以上的 master 挂掉,无论是否有 slave,集群都会进入 fail 状态。
redis-cluster 采用去中心化的思想,没有中心节点的说法,客户端与 Redis 节点直连,不需要中间代理层,客户端不需要连接集群所有节点,连接集群中任何一个可用节点即可。
总线bus
总线是计算机组成原理的知识,是各个部件共享数据及信息的传输介质。
总线的一个操作过程是完成两个模块(节点)之间传送信息,启动操作过程的是主模块,另外一个是从模块,某一时刻总线上只能有一个主模块占用总线。如果要N个节点两两通信,可以让每个节点都连接到总线。
总线在同一时刻只能支持一个节点发出消息的操作,这就需要进行
- 主模块申请总线控制权,总线控制器进行裁决。只有仲裁判断总线是闲置的才允许发送信息。仲裁会根据消息重要性给发信操作排队。
- 主模块得到总线控制权后寻址从模块,从模块确认后进行数据传送。
- 数据传送的错误检查。
定时协议可保证数据传输的双方操作同步,传输正确。
这里redis通过集群总线实现两两节点通信,在总线上有一个仲裁控制器。节点的消息通过集群总线进行数据交互,数据量不大且不频繁,完全够用。出现节点增减时,不需要管理每个独立节点,只需要新节点连接到总线即可。
扩缩容
对 redis 集群的扩容就是向集群中添加机器,缩容就是从集群中删除机器,并重新将 16383 个 slots 分配到集群中的节点上(数据迁移)。
扩容时,就是每个master把一部分槽和数据迁移到新的节点。比如原有3个master各持有一段连续的slot,就把每个master中连续slot的最后一部分分别挪到新节点上,这样原来的3个master仍然持有一段略短的连续的slot,新节点持有3个很短但分别连续的slot。实际上,并不会要求每个master的slot编号是连续的,只要每个master管理的slot的数量均衡就可以。
slot迁移的其他说明
- 迁移过程是同步的,在目标节点执行restore指令到原节点删除key之间,原节点的主线程处于阻塞状态,直到key被删除成功
- 如果迁移过程突然出现网路故障,整个slot迁移只进行了一半,这时两个节点仍然会被标记为中间过滤状态,即”migrating”和”importing”,下次迁移工具连接上之后,会继续进行迁移
- 在迁移过程中,如果每个key的内容都很小,那么迁移过程很快,不会影响到客户端的正常访问
- 如果key的内容很大,由于迁移一个key的迁移过程是阻塞的,就会同时导致原节点和目标节点的卡顿,影响集群的稳定性,所以,集群环境下,业务逻辑要尽可能的避免大key的产生
操作上,先使用redis-tri.rb add-node将新的机器加到集群中,这是新机器虽然已经在集群中了,但是没有分配 slots,依然是不起做用的。在使用 redis-tri.rb reshard进行分片重哈希(数据迁移),将旧节点上的 slots 分配到新节点上后,新节点才能起作用。
缩容与此相反,将某个要删除节点持有的slot段平均分配转移到仍然存活的节点上即可。
缩容要注意
- 如果下线的是slave,那么通知其他节点忘记下线的节点
- 如果下线的是master,那么将此master的slot迁移到其他master之后,通知其他节点忘记此master节点
- 其他节点都忘记了下线的节点之后,此节点就可以正常停止服务了
缩容时,先要使用 redis-tri.rb reshard移除的机器上的 slots,然后使用redis-tri.rb add-del移除机器。
其他
内存淘汰策略
在Redis的用于缓存的内存不足时,怎么处理需要新写入且需要申请额外空间的数据。
主要是
- noeviction:当内存不足以容纳新写入数据时,新写入操作会报错。
- allkeys-lru:当内存不足以容纳新写入数据时,在键空间中,移除最近最少使用的key。
- volatile-lru:当内存不足以容纳新写入数据时,在设置了过期时间的键空间中,移除最近最少使用的key。
实际上,不应该出现内存不足情况才对,内存淘汰可能导致数据的丢失。
一致性hash
Redis 集群没有使用一致性hash, 而是引入了哈希槽slots的概念。
I/O模型
键值对的读写是单线程的。原本客户端请求也是单线程的,现在可以支持多线程。
为什么单线程的模型能这么快?原因很简单,因为 Redis 本身就是在内存中运算,而对于上游的客户端请求,采用了多路复用的原理。Redis 会给每一个客户端套接字都关联一个指令队列,客户端的指令队列通过队列排队来进行顺序处理,同时 Reids 给每一个客户端的套件字关联一个响应队列,Redis 服务器通过响应队列来将指令的接口返回给客户端。简言之,请求是顺序排队的。
通信协议
Gossip 是一种传播消息的方式,可以类比为瘟疫或者流感的传播方式,使用 Gossip 协议的有:Redis Cluster、Consul、Apache Cassandra 等。Gossip 协议类似病毒扩散的方式,将信息传播到其他的节点,这种协议效率很高,只需要广播到附近节点,然后被广播的节点继续做同样的操作即可。当然这种协议也有一个弊端就是:会存在浪费,哪怕一个节点之前被通知到了,下次被广播后仍然会重复转发。
Gossip 过程是由种子节点发起,当一个种子节点有状态需要更新到网络中的其他节点时,它会随机的选择周围几个节点散播消息,收到消息的节点也会重复该过程,直至最终网络中所有的节点都收到了消息。这个过程可能需要一定的时间,由于不能保证某个时刻所有节点都收到消息,但是理论上最终所有节点都会收到消息,因此它是一个最终一致性协议。
需要做一些前提设定
- Gossip 是周期性的散播消息,把周期限定为 1 秒
- 被感染节点随机选择 k 个邻接节点(fan-out)散播消息,这里把 fan-out 设置为 3,每次最多往 3 个节点散播。
- 每次散播消息都选择尚未发送过的节点进行散播
- 收到消息的节点不再往发送节点散播,比如 A -> B,那么 B 进行散播的时候,不再发给 A。
注意:Gossip 过程是异步的,也就是说发消息的节点不会关注对方是否收到,即不等待响应;不管对方有没有收到,它都会每隔 1 秒向周围节点发消息。异步是它的优点,而消息冗余则是它的缺点。
Gossip 的特点(优势)
- 扩展性。网络可以允许节点的任意增加和减少,新增加的节点的状态最终会与其他节点一致。
- 容错。网络中任何节点的宕机和重启都不会影响 Gossip 消息的传播,Gossip 协议具有天然的分布式系统容错特性。
- 去中心化。Gossip 协议不要求任何中心节点,所有节点都可以是对等的,任何一个节点无需知道整个网络状况,只要网络是连通的,任意一个节点就可以把消息散播到全网。
- 一致性收敛。Gossip 协议中的消息会以一传十、十传百一样的指数级速度在网络中快速传播,因此系统状态的不一致可以在很快的时间内收敛到一致。消息传播速度达到了 logN。
- 简单。Gossip 协议的过程极其简单,实现起来几乎没有太多复杂性。
在 Gossip 协议下,网络中两个节点之间有三种通信方式:
- Push: 节点 A 将数据 (key,value,version) 及对应的版本号推送给 B 节点,B 节点更新 A 中比自己新的数据
- Pull:A 仅将数据 key, version 推送给 B,B 将本地比 A 新的数据(Key, value, version)推送给 A,A 更新本地
- Push/Pull:与 Pull 类似,只是多了一步,A 再将本地比 B 新的数据推送给 B,B 则更新本地
如果把两个节点数据同步一次定义为一个周期,则在一个周期内,Push 需通信 1 次,Pull 需 2 次,Push/Pull 则需 3 次。虽然消息数增加了,但从效果上来讲,Push/Pull 最好,理论上一个周期内可以使两个节点完全一致。直观上,Push/Pull 的收敛速度也是最快的。
这个过程中要注意一些特殊情况,比如节点死亡。
对redis的改造方案
分布式一致性协议 Gossip 和 Redis 集群原理解析 大厂们的 redis 集群方案
比如Codis。特点:
- 自动平衡;
- 使用非常简单;
- 图形化的面板和管理工具;
- 支持绝大多数 Redis 命令,完全兼容 Twemproxy(Twitter开源的代理方案,由于Twemproxy也是单点,要用Keepalived作高可用,比如加一台备机,当一台挂掉以后,备机自动接替工作。);
- 支持 Redis 原生客户端;
- 安全而且透明的数据移植,可根据需要轻松添加和删除节点;
- 提供命令行接口,支持 RESTful APIs。
也就是说,实际上就是proxy+魔改Redis。Redis的分片方案(增加slot,用一致性hash替代用CRC16)、高可用方案(keepalived替代哨兵)、代理的路由信息存储(zk、etcd等)都是可以自定义设计的部分。
热key问题
瞬间有几十万的请求去访问redis上某个固定的key,从而压垮缓存服务的情情况。其实生活中也是有不少这样的例子。比如XX明星结婚。
发现热key可以从proxy入手。
解决方案
- 利用二级缓存,比如Java利用ehcache,或者一个HashMap都可以。在你发现热key以后,把热key加载到系统的JVM中。
- 备份热key,不要让key走到同一台redis上。把这个key,在多个redis上都存一份。可以用HOTKEY加上一个随机数(N,集群分片数)组成一个新key。
- 热点数据尽量不要设置过期时间,在数据变更时同步写缓存,防止高并发下重建缓存的资源损耗。可以用setnx做分布式锁保证只有一个线程在重建缓存,其他线程等待重建缓存的线程执行完,重新从缓存获取数据即可。
缓存穿透
当用户访问的数据,既不在缓存中,也不在数据库中,导致请求在访问缓存时,发现缓存缺失,再去访问数据库时,发现数据库中也没有要访问的数据,没办法构建缓存数据,来服务后续的请求。那么当有大量这样的请求到来时,数据库的压力骤增。也就是说大量请求对单一key无论在缓存还是数据库都无法拿到数据,相当于请求直面数据库了,如果db不具备高可用高并发将会宕掉。
如前所述,布隆过滤器可以解决此问题,通过拦截数据库中不存在的数据,保护存储层。
另外,热key失效后重建缓存的过程应该是setnx形式,也就是只允许单一线程重建缓存,避免所有请求都到访DB获取数据企图重建缓存。整个get(含重建缓存)的过程是
- 获取缓存
- 如果命中就直接返回value,未命中就判断是否能setnx一个mutexKey
- 如果setnx成功
- 查询DB
- 重建缓存
- 删除mutexKey
- 如果setnx不成功,说明有其他客户端正在进行setnx内的流程,当前客户端就要等待一段时间再次重试整个get过程了。
缓存雪崩
数据未加载到缓存中,或者缓存同一时间大面积的失效,从而导致所有请求都去查数据库,导致数据库CPU和内存负载过高,甚至宕机。
为了避免对大量key的请求都直面数据库,可以通过以下方案解决
- 保证缓存层服务高可用性:和飞机都有多个引擎一样,如果缓存层设计成高可用的,即使个别节点、个别机器、甚至是机房宕掉,依然可以提供服务,例如前面介绍过的 Redis Sentinel 和 Redis Cluster 都实现了高可用。
- Redis备份和快速预热:Redis备份保证master出问题切换为slave迅速能够承担线上实际流量,快速预热保证缓存及时被写入缓存,防止穿透到库。
- 依赖隔离组件为后端限流并降级:无论是缓存层还是存储层都会有出错的概率,可以将它们视同为资源。作为并发量较大的系统,假如有一个资源不可用,可能会造成线程全部 hang 在这个资源上,造成整个系统不可用。降级在高并发系统中是非常正常的:比如推荐服务中,如果个性化推荐服务不可用,可以降级补充热点数据,不至于造成前端页面是开天窗。
- 提前演练:在项目上线前,演练缓存层宕掉后,应用以及后端的负载情况以及可能出现的问题,在此基础上做一些预案设定。
- 缓存预热:系统上线前,将相关的缓存数据直接加载到缓存系统。这样就可以避免上线后在用户请求的时候,先查询数据库,然后再将数据缓存的问题!用户直接查询事先被预热的缓存数据!
另外,从key本身,为了避免缓存在同一时间大面积的失效,可以为这些key设定随机ttl,避免同时到期。